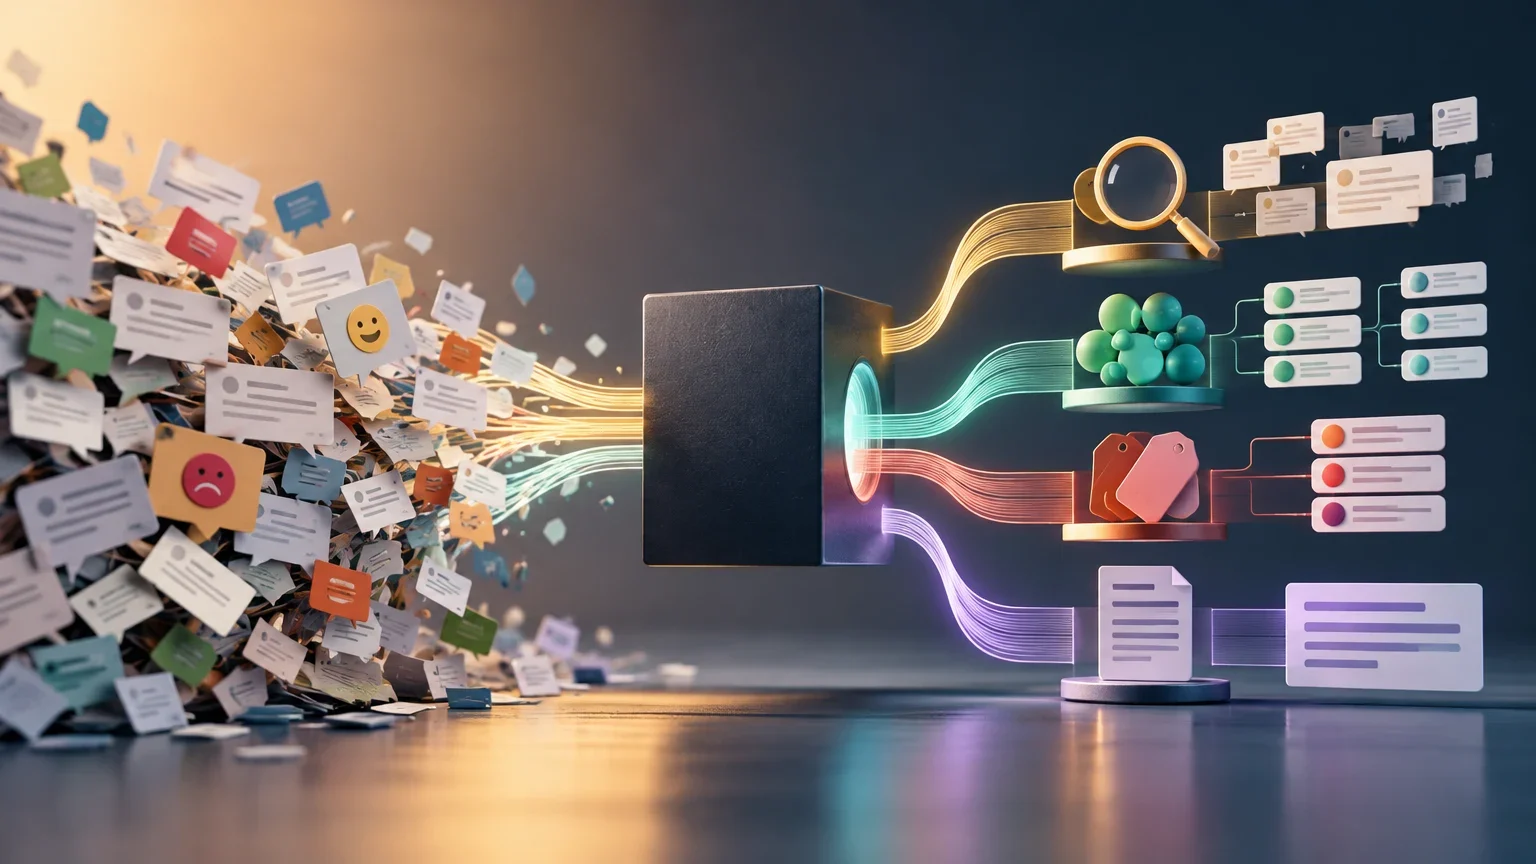
Das Problem eingrenzen: vier verschiedene Aufgaben
Der erste Schritt bei der Auswahl eines Feedback-Analyse-Tools besteht darin zu identifizieren, was mit den Daten geschehen soll. Es ist nicht dasselbe, einen spezifischen Kommentar zu finden, als verborgene Muster zu entdecken oder eine Management-Zusammenfassung zu verfassen. Die Verwechslung dieser Aufgaben führt dazu, dass kostspielige Lösungen für einfache Probleme implementiert oder umgekehrt primitive Methoden für komplexe Bedürfnisse verwendet werden.
Es gibt vier Hauptbedürfnisse: die Lokalisierung relevanter Kommentare durch Suche, die Gruppierung von Themen durch exploratives Discovery, die Messung bekannter Kategorien durch überwachtes Klassifizieren und die Erstellung einer Synthese durch assistierte Generierung. Jede davon erfordert einen anderen technischen Ansatz und hat unterschiedliche Auswirkungen auf Kosten, Präzision und Wartung.
Die Unterscheidung zwischen diesen vier Aufgaben ist fundamental, da jede eine spezifische Art der Interaktion mit den Daten erfordert. Die Suche zielt darauf ab, vorhandene Informationen zu extrahieren, während das Discovery neue Strukturen in unstrukturierten Daten aufdeckt. Das Klassifizieren setzt voraus, dass bereits ein Rahmen existiert, in den die Daten eingeordnet werden können, was eine andere Art der Validierung erfordert als das offene Erkennen von Mustern. Schließlich dient die Generierung der Zusammenführung dieser Erkenntnisse in eine kohärente Erzählung, die für Entscheidungsträger verständlich ist. Diese Trennung hilft, die Erwartungen an das Tool realistisch zu gestalten und die Ressourcen entsprechend der Komplexität der jeweiligen Teilaufgabe zuzuweisen, ohne dass unnötige Überlappungen oder Lücken in der Analyse entstehen.
Wenn diese Aufgaben verwechselt werden, entsteht ein Risiko der ineffizienten Ressourcennutzung. Ein Team, das eigentlich nur nach spezifischen Nennungen sucht, könnte ein aufwendiges Clustering-System implementieren, das zwar Muster findet, aber die direkte Antwort auf die Frage nicht liefert. Umgekehrt könnte ein Team, das tiefe Einblicke in unbekannte Problemfelder benötigt, sich auf eine einfache Stichwortsuche verlassen und dabei kritische, aber anders formulierte Feedbacks übersehen. Die Klarheit über die primäre Aufgabe bestimmt daher nicht nur die technische Architektur, sondern auch die Art der menschlichen Einbindung, die für die Interpretation der Ergebnisse notwendig ist. Jede der vier Aufgaben hat ihre eigenen Stärken und Schwächen, die im Kontext der gesamten Feedback-Strategie abgewogen werden müssen.
Unterschiede zwischen den vier Analyse-Aufgaben
Tabelle, die das Ziel, den typischen Eingang und das erwartete Ergebnis jeder Aufgabe kontrastiert.
| Aufgabe | Hauptziel | Typischer Eingang | Erwartetes Ergebnis |
|---|---|---|---|
| Suche | Spezifische Kommentare lokalisieren | Textuelle oder semantische Abfrage | Liste relevanter Kommentare |
| Discovery | Themen ohne vorherige Labels identifizieren | Unlabeled Textkorpus | Gruppen ähnlicher Kommentare |
| Klassifizierung | Bekannte Kategorien zuweisen | Text und definierte Taxonomie | Labels pro Kommentar |
| Generierung | Eine Synthese verfassen | Vollständiges oder gefiltertes Korpus | Narrativer Zusammenfassungstext |
Eingaben und Einschränkungen des Korpus
Bevor Techniken verglichen werden, ist es notwendig, die Merkmale des Datensatzes zu auditieren. Kundenkommentare sind selten homogen: Sie stammen aus Umfragen, Support-Tickets, öffentlichen Rezensionen und sozialen Medien, jeweils mit eigenem Format, Länge und Strukturierungsgrad.
Kritische Faktoren umfassen das Gesamtvolumen der Kommentare, die Sprachvielfalt, die Frequenz neuer Daten und das Vorhandensein personenbezogener Informationen. Ein kleines, stabiles Korpus kann mit einfachen Regeln verwaltet werden, während ein kontinuierlicher mehrsprachiger Strom Modelle erfordert, die generalisieren und häufig aktualisiert werden können.
Die Heterogenität der Datenquellen stellt eine zentrale Herausforderung dar, da Kommentare aus Umfragen oft strukturiert und kurz sind, während Support-Tickets längere, narrative Beschreibungen von Problemen enthalten. Öffentliche Rezensionen wiederum können subjektiv und emotional aufgeladen sein, was die Interpretation erschwert. Soziale Medien liefern oft fragmentierte Informationen, die Kontext erfordern, um vollständig verstanden zu werden. Diese Unterschiede in Format und Struktur bedeuten, dass ein einzelner analytischer Ansatz selten für alle Quellen gleichermaßen geeignet ist. Es ist daher notwendig, die Daten vor der Verarbeitung zu normalisieren oder separate Pipelines für verschiedene Quellentypen zu erstellen, um sicherzustellen, dass die Analyse die spezifischen Merkmale jeder Quelle berücksichtigt.
Die Frequenz, mit der neue Daten eintreffen, beeinflusst die Architektur des Systems erheblich. Ein statisches Korpus, das nur selten aktualisiert wird, kann mit batch-basierten Prozessen behandelt werden, die kostengünstiger sind, aber eine höhere Latenz aufweisen. Im Gegensatz dazu erfordert ein kontinuierlicher Datenstrom eine Infrastruktur, die in der Lage ist, Kommentare in Echtzeit oder nahezu Echtzeit zu verarbeiten. Dies hat direkte Auswirkungen auf die Skalierbarkeit und die Betriebskosten. Zudem muss die Sprachvielfalt berücksichtigt werden, da mehrsprachige Korpora Modelle erfordern, die über die Grenzen einer einzelnen Sprache hinaus generalisieren können. Die Anwesenheit personenbezogener Daten erfordert zudem eine sorgfältige Datenminimierung, um sicherzustellen, dass nur die für die Analyse relevanten Informationen verarbeitet werden, was die Komplexität der Vorverarbeitungsschritte erhöht.
Vergleich technischer Alternativen
Für die Lokalisierungsaufgabe ist die wörtliche Suche ausreichend, wenn die Abfragen exakt sind, aber die semantische Suche ermöglicht es, konzeptionell verwandte Kommentare zu finden, auch wenn sie keine Schlüsselwörter teilen. Für die Themenentdeckung identifiziert das explorative Clustering Muster ohne vorherige Labels, erfordert jedoch eine menschliche Interpretation zur Benennung der Gruppen.
Die überwachtes Klassifizieren ist die robusteste Option, wenn eine definierte Taxonomie und gelabelte Beispiele vorliegen. Es ermöglicht die Messung der Präzision und die systematische Korrektur von Fehlern. Die assistierte Generierung ist hingegen nützlich, um große Volumina zu synthetisieren, muss aber mit Vorsicht verwendet werden, um Halluzinationen oder Zusammenfassungen zu vermeiden, die die Quellen nicht treu widerspiegeln.
Die semantische Suche erweitert die Möglichkeiten der wörtlichen Suche, indem sie die Bedeutung hinter den Worten berücksichtigt. Während die wörtliche Suche nur Kommentare findet, die exakt die eingegebenen Schlüsselwörter enthalten, kann die semantische Suche auch solche identifizieren, die konzeptionell verwandt sind, aber andere Formulierungen verwenden. Dies ist besonders nützlich, wenn Nutzer ihre Probleme auf verschiedene Arten beschreiben, ohne dass ein gemeinsames Vokabular existiert. Allerdings erfordert die semantische Suche eine genauere Kalibrierung, um sicherzustellen, dass die gefundenen Ergebnisse tatsächlich relevant sind und nicht nur oberflächlich ähnlich klingen. Die Balance zwischen Präzision und Vollständigkeit ist hier entscheidend, da zu breite semantische Abfragen zu einer Überflutung mit irrelevanten Ergebnissen führen können.
Das explorative Clustering ist eine leistungsfähige Methode, um unbekannte Themen in großen Datenmengen zu identifizieren. Es gruppiert ähnliche Kommentare basierend auf ihrer Ähnlichkeit, ohne dass vorherige Labels benötigt werden. Dies ermöglicht es, neue Trends oder Probleme zu entdecken, die nicht in der bestehenden Taxonomie erfasst sind. Der Nachteil dieser Methode ist, dass die resultierenden Cluster oft keine offensichtlichen Namen haben und eine menschliche Interpretation erfordern, um sinnvoll benannt und verstanden zu werden. Dieser Schritt der Interpretation ist zeitaufwendig und erfordert Fachwissen, um die Gruppen korrekt zu beschreiben und ihre Bedeutung für das Unternehmen zu bewerten. Dennoch ist es ein unverzichtbarer Schritt, um die Tiefe der Analyse zu erhöhen und blinde Flecken in der Feedback-Erfassung zu schließen.
Entscheidungs-Matrix zur Auswahl des Ansatzes
Die endgültige Wahl hängt davon ab, das erforderliche Ergebnis mit den operativen Bedingungen des Teams zu kreuzen. Wenn es keine vorherigen Labels gibt und Themen entdeckt werden müssen, ist das explorative Clustering der Ausgangspunkt. Wenn die Kategorien definiert sind und gelabelte Beispiele vorliegen, bietet die überwachtes Klassifizieren mehr Kontrolle und Nachverfolgbarkeit.
Das Budget, die akzeptable Latenz und die Kapazität für menschliche Überprüfung sind entscheidende Faktoren. Ein Echtzeit-System erfordert eine kostspieligere Infrastruktur als ein Batch-System. Außerdem variiert die Fehlertoleranz je nach Verwendung: Ein Fehler bei der Klassifizierung einer Sicherheitsbeschwerde ist schwerwiegender als ein Fehler bei der Kategorisierung eines Lobes.
Die überwachtes Klassifizieren bietet den Vorteil, dass die Ergebnisse messbar und reproduzierbar sind. Da die Kategorien vorab definiert sind, kann die Leistung des Modells anhand der Genauigkeit bewertet werden, mit der es Kommentare den richtigen Kategorien zuweist. Dies ermöglicht eine systematische Verbesserung des Modells durch das Hinzufügen neuer gelabelter Beispiele und das Anpassen der Parameter. Die Nachverfolgbarkeit ist in diesem Ansatz besonders hoch, da jede Zuweisung auf einer definierten Logik basiert, die auditiert werden kann. Dies ist besonders wichtig in Umgebungen, in denen Entscheidungen auf Basis der Feedback-Daten getroffen werden und die Transparenz der Entscheidungsfindung gewährleistet sein muss. Die Möglichkeit, Fehler zu identifizieren und zu korrigieren, macht diesen Ansatz zu einer robusten Wahl für langfristige Feedback-Strategien.
Die assistierte Generierung ist ein mächtiges Werkzeug, um große Mengen an Feedback in eine zusammenhängende Erzählung zu verwandeln. Sie kann Muster und Trends hervorheben, die für den menschlichen Leser schwer zu erkennen wären, und eine narrative Struktur schaffen, die die wichtigsten Erkenntnisse hervorhebt. Allerdings ist dieser Ansatz mit dem Risiko behaftet, dass die generierten Texte nicht immer die Realität der Daten genau widerspiegeln. Es ist daher entscheidend, dass die generierten Zusammenfassungen von Menschen überprüft werden, um sicherzustellen, dass keine falschen Informationen oder Verzerrungen eingeführt werden. Die Generierung sollte als ein Vorschlag betrachtet werden, der die menschliche Expertise unterstützt, aber nicht ersetzt. Die Kombination aus automatischer Synthese und menschlicher Validierung bietet den besten Weg, um die Effizienz der Generierung mit der Genauigkeit der menschlichen Interpretation zu verbinden.
Vereinfachte Entscheidungs-Matrix
Schnellreferenz zur Auswahl der Anfangstechnik basierend auf der Verfügbarkeit von Labels und dem Aktualisierungsbedarf.
| Bedingung | Empfohlener Ansatz | Wichtige Überlegung |
|---|---|---|
| Keine vorherigen Labels | Exploratives Clustering | Erfordert menschliche Interpretation der Cluster |
| Mit Labels und Beispielen | Überwachtes Klassifizieren | Ermöglicht Präzisionsmessung und Korrektur |
| Bedarf an Synthese | Assistierte Generierung | Fideltätigkeit gegenüber Quellen prüfen |
| Punktuelle Suche | Semantische Suche | Geringere Kosten als komplexe Modelle |
Relevante Fehler und operative Prüfungen
Die kostspieligsten Fehler sind nicht immer die sichtbarsten. Das Übersehen eines kritischen Signals, wie einer Sicherheitsbeschwerde, kann schwerwiegende Folgen haben. Die Zuweisung einer falschen Kategorie kann zu unangemessenen Maßnahmen führen. Die Erstellung einer Synthese, die nicht durch identifizierbare Kommentare gestützt wird, untergräbt das Vertrauen in das System.
Vor der Implementierung ist es essenziell zu überprüfen, ob jedes Label oder jede Aussage in der Synthese auf die Quellkommentare zurückverfolgt werden kann. Es muss ein Korrekturprozess existieren, wenn eine Person einen Fehler erkennt, und ein Mechanismus zur Weiterleitung an die menschliche Überprüfung für mehrdeutige oder hochimpactvolle Fälle. Nachverfolgbarkeit und Auditfähigkeit sind genauso wichtig wie die Modellpräzision.
Die operative Umsetzung der gewählten Technik erfordert eine sorgfältige Planung der Ressourcen und Prozesse. Die Verfügbarkeit von Labels ist ein entscheidender Faktor, da sie bestimmt, ob ein überwachter oder ein unüberwachter Ansatz gewählt werden kann. Wenn keine Labels vorhanden sind, muss Zeit für die manuelle Beschriftung einer Stichprobe eingeplant werden, um ein Basismodell zu trainieren. Dieser Prozess kann zeitaufwendig sein, ist aber notwendig, um die Qualität der Klassifizierung sicherzustellen. Die Kapazität für menschliche Überprüfung muss ebenfalls berücksichtigt werden, da selbst die besten Modelle Fehler machen können und eine menschliche Kontrolle erforderlich ist, um die Integrität der Daten zu gewährleisten. Die Einrichtung von klaren Protokollen für die Fehlerkorrektur und die Weiterleitung von unsicheren Fällen an menschliche Experten ist ein wesentlicher Bestandteil eines robusten Feedback-Systems.
Die Nachverfolgbarkeit und Auditfähigkeit sind nicht nur technische, sondern auch organisatorische Anforderungen. Es muss sichergestellt sein, dass jede Entscheidung, die auf Basis der Feedback-Daten getroffen wird, auf nachvollziehbaren Daten basiert. Dies erfordert die Dokumentation der verwendeten Algorithmen, der Parameter und der menschlichen Eingriffe. Ein solches System ermöglicht es, bei Bedarf die Herkunft einer bestimmten Aussage oder Klassifizierung zu überprüfen und gegebenenfalls Korrekturen vorzunehmen. Die Integration dieser Prüfungen in den täglichen Betrieb stellt sicher, dass das Feedback-System nicht nur effektiv, sondern auch vertrauenswürdig ist. Die kontinuierliche Überwachung der Modellleistung und die Anpassung an sich ändernde Datenmuster sind notwendig, um die Relevanz und Genauigkeit der Analyse langfristig zu erhalten.
Validierungsprozess vor der Implementierung
Schritte, um sicherzustellen, dass der gewählte Ansatz die tatsächlichen Bedingungen des Teams erfüllt.
- 01Hauptaufgabe definieren: Suche, Discovery, Klassifizierung oder Generierung.
- 02Korpus auditieren: Volumen, Sprachen, Struktur und personenbezogene Daten.
- 03Verfügbarkeit von Labels und repräsentativen Beispielen überprüfen.
- 04Budget, Latenz und Kapazität für menschliche Überprüfung bewerten.
- 05Mechanismus für Nachverfolgbarkeit und Fehlerkorrektur etablieren.
Offene Fragen
- Es liegen keine unabhängigen Vergleichsdaten zu Kosten oder Leistung zwischen den Techniken für dasselbe Korpus vor.
- Die Wirksamkeit generativer Modelle für eine treue Synthese hängt von der Qualität der Anweisungen und der menschlichen Überprüfung ab, ohne universelle Standardmetriken.
- Der Einfluss der Latenz auf die Kundenzufriedenheit variiert je nach Branche und wird in den bereitgestellten Quellen nicht quantifiziert.
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen