Definition in einem Satz
Familia de métodos que usa preferencias humanas para entrenar señales de recompensa y orientar el comportamiento de un modelo.
Was ist RLHF?
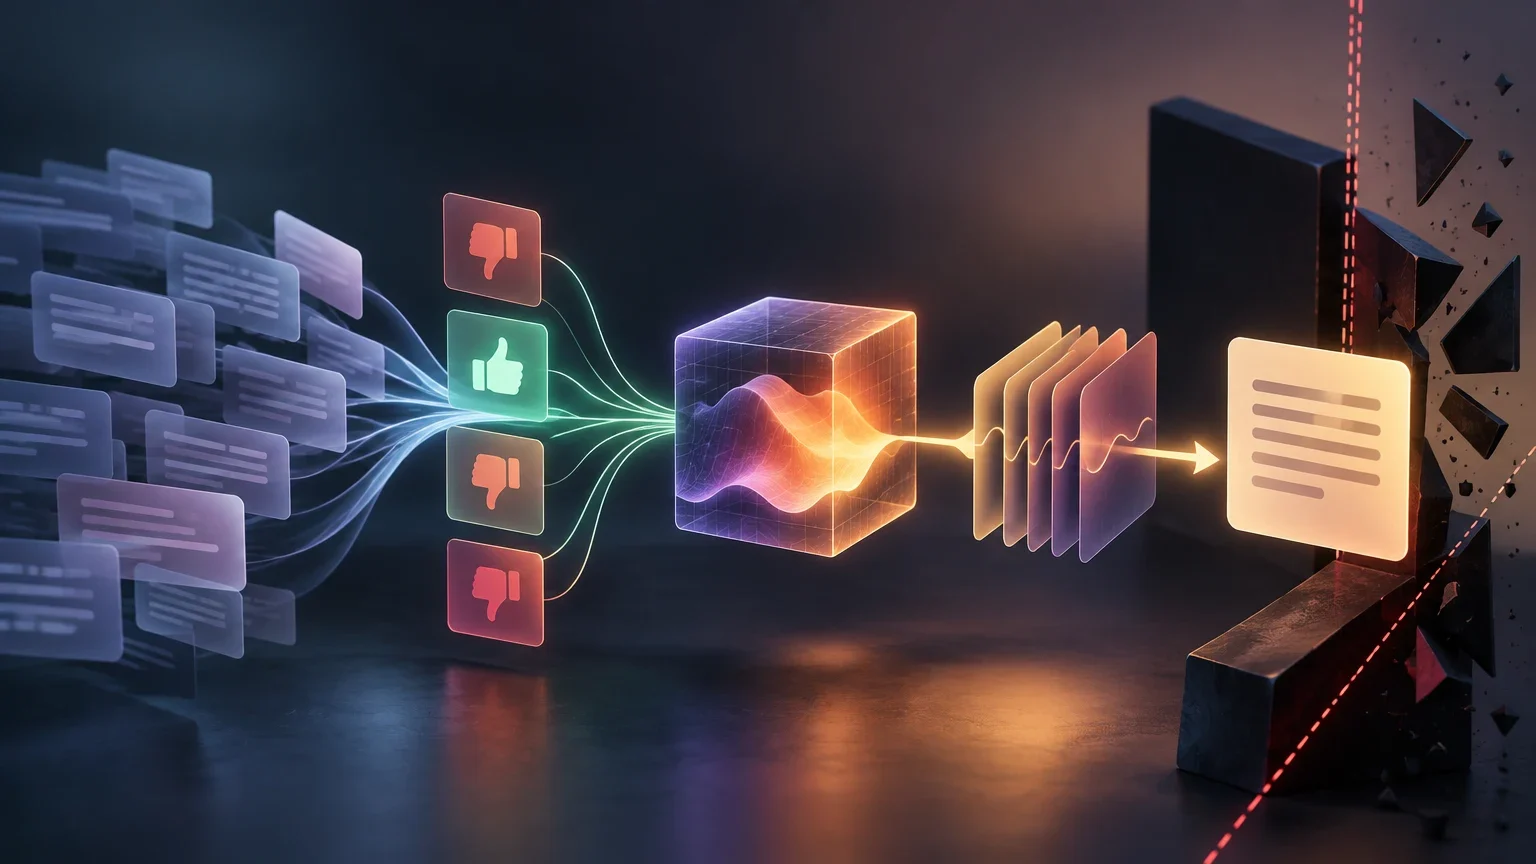
Reinforcement Learning from Human Feedback (RLHF), auf Deutsch etwa bestärkendes Lernen aus menschlichem Feedback, bezeichnet eine Familie von Methoden. Sie nutzt menschliche Bewertungen oder Präferenzen, um ein Belohnungssignal zu erstellen und die Optimierung eines Modells zu steuern. In einer verbreiteten Implementierung vergleichen Menschen mehrere mögliche Antworten. Diese Vergleiche dienen dazu, ein Belohnungsmodell zu trainieren, das anschließend Antworten der gerade angepassten Policy bewertet.
Der Ansatz ist besonders dann nützlich, wenn sich leichter beurteilen lässt, welches von zwei Ergebnissen besser ist, als eine vollständige mathematische Regel für das ideale Ergebnis zu formulieren. Eine Person kann beispielsweise einschätzen, ob eine Antwort verständlich, relevant oder umsichtig ist. Das Belohnungsmodell bildet solche Urteile anhand der verfügbaren Daten näherungsweise ab. Es macht subjektive Kriterien jedoch nicht automatisch zu einer universellen Definition von Qualität.
RLHF ist kein einzelnes, unveränderliches Rezept. Je nach Implementierung unterscheiden sich die Feedback-Art, die Erhebungsmethode, das Modell, das die Präferenzen lernt, und das anschließende Optimierungsverfahren. Bei Sprachmodellen verbindet eine bekannte Konfiguration überwachtes Feintuning, menschliche Vergleiche, das Training eines Belohnungsmodells und eine Optimierung durch bestärkendes Lernen. PPO ist eine mögliche Methode für die letzte Phase, aber keine Voraussetzung für jede Technik, die menschliche Präferenzen nutzt.
Für eine präzise Definition muss außerdem zwischen dem menschlichen Signal und seiner Verarbeitung unterschieden werden. Die beobachtete Präferenz ist ein Datensatz, das Belohnungsmodell eine gelernte Näherung und die optimierte Policy das System, dessen Verhalten verändert werden soll. Werden diese Elemente gleichgesetzt, wird leicht übertrieben, was das Verfahren belegt: Eine höhere Punktzahl im gelernten Modell beweist für sich genommen weder, dass das Modell wahrheitsgetreu oder sicher ist, noch dass es die Präferenzen aller Menschen repräsentiert.
Der technische Ablauf: von den Daten zur Policy
Bei einem häufigen Ablauf für Sprachmodelle beginnt der Prozess mit einer initialen Policy, die Antworten erzeugen kann. Sie kann von einem vortrainierten Modell stammen und zunächst überwachtes Feintuning durchlaufen, bei dem sie lernt, Demonstrationsantworten nachzuahmen. Demonstrationen und Präferenzen erfüllen unterschiedliche Aufgaben: Demonstrationen zeigen Beispiele für gewünschtes Verhalten, während Präferenzen den Vergleich mehrerer Kandidaten ermöglichen.
Anschließend erzeugt das System mehrere Antworten auf dieselbe Anweisung. Menschliche Annotierende vergleichen oder bewerten diese anhand zuvor festgelegter Kriterien. Ein paarweiser Vergleich kann beispielsweise festhalten, dass bei einer bestimmten Frage Antwort A gegenüber Antwort B bevorzugt wird. Das Urteil ist an den jeweiligen Kontext gebunden. Es hält weder zwingend die vollständige Begründung fest noch bedeutet es, dass alle Bewertenden derselben Meinung sind.
Aus den Vergleichen wird ein Belohnungsmodell trainiert. Bei paarweisen Präferenzen lernt es üblicherweise, Antworten so zu bewerten, dass die bevorzugte Antwort tendenziell eine höhere Punktzahl erhält als die abgelehnte. Danach erzeugt die Policy neue Antworten und wird so optimiert, dass sie anhand dieses gelernten Belohnungsmodells hohe Werte erzielt. Verfahren wie PPO können die Policy aktualisieren; manche Konfigurationen begrenzen zusätzlich, wie stark sie von einem Referenzmodell abweicht.
Die einzelnen Phasen erzeugen unterschiedliche Artefakte: Demonstrationen für das überwachte Feintuning, annotierte Antwortpaare oder Rankings, ein Belohnungsmodell und eine angepasste Policy. Werden diese Elemente getrennt gehalten, lässt sich leichter nachvollziehen, welches Signal in das System einging und wie es verarbeitet wurde. Wird eine Phase ausgelassen – etwa indem ausschließlich mit Demonstrationen angepasst wird –, sollte das nicht automatisch als klassischer RLHF-Ablauf mit explizitem Belohnungsmodell bezeichnet werden.
Dieses Schema dient als Orientierung, nicht als universelle Spezifikation. Manche Designs verwenden andere Feedback-Arten oder Optimierungsverfahren. Außerdem gibt es Präferenzoptimierungsansätze, die auf ein separates Belohnungsmodell mit anschließendem herkömmlichem Reinforcement-Learning-Schritt verzichten. Deshalb sollte die konkrete Methode benannt werden, statt anzunehmen, dass jede präferenzbasierte Ausrichtung genau dieselben Schritte umfasst.
Typische Phasen und ihre Ergebnisse
Die folgende Reihenfolge beschreibt eine verbreitete Konfiguration für ein Sprachmodell. Einzelheiten unterscheiden sich je nach Implementierung.
- 01Eine initiale Policy vorbereiten und sie gegebenenfalls mit überwachten Demonstrationen anpassen.
- 02Mehrere Antworten auf ausgewählte Anweisungen erzeugen.
- 03Vergleiche, Rankings oder andere menschliche Bewertungen anhand festgelegter Kriterien erfassen.
- 04Ein Belohnungsmodell trainieren, das die beobachteten Präferenzen näherungsweise abbildet.
- 05Die Policy anhand dieses Belohnungsmodells optimieren und, sofern im jeweiligen Design vorgesehen, einen Reinforcement-Learning-Algorithmus einsetzen.
- 06Das resultierende Modell separat bewerten: Die Belohnung im Training ersetzt keine unabhängige Evaluation.
Anwendungsbeispiele
Bei einem dialogorientierten Assistenten können Bewertende zwei Antworten auf dieselbe Frage vergleichen. Sie könnten die Antwort bevorzugen, die direkt auf die Frage eingeht, Fakten von Unsicherheiten trennt und irrelevante Inhalte vermeidet. Die Vergleiche helfen dabei, eine auf diese Kriterien ausgerichtete Belohnungsfunktion zu lernen und anschließend die Policy anzupassen. Das Beispiel veranschaulicht den Mechanismus, behauptet aber nicht, dass ein bestimmter Assistent auf diese Weise trainiert wurde.
Bei der Inhaltsmoderation könnten Bewertende die Entscheidungen des Systems zu demselben Ausschnitt vergleichen: zulassen, entfernen oder zur Überprüfung weiterleiten. Das Feedback kann Regeln und Prioritäten widerspiegeln, die für einen bestimmten Kontext festgelegt wurden. Bevor es zur Optimierung einer Policy verwendet wird, sollten das zu verringernde Risiko, die Kosten falsch positiver und falsch negativer Entscheidungen sowie Einspruchsmöglichkeiten geklärt sein. Die Präferenz einer Gruppe von Annotierenden ist für sich genommen keine universelle gesellschaftliche Norm.
In einem Empfehlungssystem kann eine Person in einer bestimmten Situation ein Ergebnis einem anderen vorziehen – etwa eine Option, die zu einer konkreten Suche passt, gegenüber einer beliebten, aber wenig passenden Option. Ein solcher Vergleich könnte in ein Belohnungsmodell einfließen, das Ergebnisse sortiert. Ein Klick oder eine beobachtete Auswahl drückt jedoch nicht immer Zufriedenheit aus: Die Position, die Benutzeroberfläche oder unvollständige Informationen können das Verhalten beeinflussen. Bevor solches Verhalten als Feedback interpretiert wird, muss klar sein, welches Ziel damit angenähert werden soll.
In allen drei Fällen ist der Kern derselbe: Urteile werden als Signal zur Optimierung genutzt. Es ändern sich jedoch die bewertete Einheit, die urteilenden Personen und die Folgen möglicher Fehler. Bei der Beschreibung einer Anwendung sollte deshalb klar zwischen einem konzeptionellen Beispiel und einem für ein reales System dokumentierten Verfahren unterschieden werden.
RLHF und verwandte Konzepte
Beim direkten überwachten Feintuning wird ein Modell mit Demonstrationen trainiert: Zu einer Eingabe wird eine Referenzantwort bereitgestellt, und das Modell lernt, eine ähnliche Antwort zu erzeugen. Dafür muss nicht notwendigerweise aus Vergleichen eine Belohnung gelernt oder die Policy anschließend durch bestärkendes Lernen optimiert werden. Überwachtes Feintuning kann als erste Phase Teil eines RLHF-Ablaufs sein, ist aber nicht mit dem gesamten Verfahren gleichzusetzen.
Beim Reinforcement Learning ohne menschliches Feedback stammt die Belohnung aus einer anderen Quelle, beispielsweise aus einer automatischen Punktzahl oder einer überprüfbaren Bedingung. Es bleibt bestärkendes Lernen, wird aber nicht allein dadurch zu RLHF, dass das System eine Belohnung optimiert. Umgekehrt beweist die Beteiligung eines Menschen an einer Annotation nicht, dass ein Belohnungsmodell trainiert oder bestärkendes Lernen eingesetzt wurde.
Beim In-Context-Learning nutzt ein Modell Anweisungen und Beispiele, die während der Anfrage bereitgestellt werden, um eine Ausgabe zu erzeugen. Dadurch werden nicht automatisch die Modellparameter durch das zuvor beschriebene Training aktualisiert. In-Context-Beispiele können das beobachtete Verhalten innerhalb eines Gesprächs beeinflussen, sind aber für sich genommen kein RLHF.
Diese Methoden schließen einander nicht immer aus. Ein System kann zunächst überwachte Demonstrationen verwenden, bevor Präferenzen erhoben werden, und während der Entwicklung mehrere Bewertungsformen kombinieren. Verfahren zur direkten Präferenzoptimierung wie DPO nutzen Präferenzdaten, ohne notwendigerweise den expliziten Ablauf aus separatem Belohnungsmodell und anschließendem Reinforcement-Learning-Algorithmus zu durchlaufen. Die präziseste Bezeichnung hängt davon ab, welche Komponenten tatsächlich eingesetzt wurden.
Methoden unterscheiden
Menschliches Feedback allein reicht nicht aus, um alle Trainingsphasen zu bestimmen.
| Methode | Zentrales Signal | Was daraus nicht automatisch folgt |
|---|---|---|
| Typischer RLHF-Ablauf | Menschliche Präferenzen dienen zum Lernen einer Belohnung und zur Steuerung der Policy | Keine Garantie für Wahrheitsgehalt, Sicherheit oder universellen Konsens |
| Direktes überwachtes Feintuning | Demonstrationen mit gewünschten Ein- und Ausgaben | Erfordert weder ein Belohnungsmodell noch die Optimierung durch Reinforcement Learning |
| Reinforcement Learning ohne menschliches Feedback | Automatische, programmierte oder überprüfbare Belohnung | Ist kein RLHF, wenn das Signal nicht aus menschlichem Feedback stammt |
| In-Context-Learning | Anweisungen und Beispiele in der jeweiligen Anfrage | Bedeutet keine Aktualisierung der Modellparameter |
| Direkte Präferenzoptimierung | Präferenzpaare oder Rankings werden direkt für die Anpassung verwendet | Erfordert nicht zwangsläufig den expliziten Ablauf aus Belohnungsmodell und Reinforcement Learning |
Was Präferenzen aussagen – und was nicht
Ein menschlicher Vergleich hält eine Entscheidung unter bestimmten Bedingungen fest: Wer hat bewertet, welche Alternativen wurden gezeigt, welche Anweisungen galten und wann fand die Bewertung statt? Der Vergleich kann dabei helfen, einem System Muster aus dieser Stichprobe beizubringen. Er beweist jedoch weder, dass die Entscheidung die gesamte Bevölkerung repräsentiert, noch, dass sie in anderen Kontexten stabile Werte widerspiegelt.
Das Belohnungsmodell ist ein gelernter Ersatz für die Urteile, die es erhalten hat. Bei Anweisungen oder Antworten außerhalb seines Abdeckungsbereichs kann es schlecht generalisieren, ein oberflächliches Signal mit der gewünschten Eigenschaft verwechseln oder inkonsistent bewerten. Wird die Policy stark gegen dieses Signal optimiert, kann sie Ergebnisse finden, die eine hohe Punktzahl erzielen, ohne das zugrunde liegende menschliche Ziel zu erfüllen. Dieses Risiko wird häufig als Reward Hacking oder Überoptimierung der Belohnung bezeichnet.
Auch Entscheidungen im Verfahren spielen eine Rolle: wie die Kriterien formuliert werden, welche Alternativen entstehen, welche Gruppen von Annotierenden teilnehmen, wie Meinungsverschiedenheiten behandelt werden und welche Verteilung von Anweisungen zum Einsatz kommt. Eine zu geringe Vielfalt kann dazu führen, dass Präferenzen oder Situationen unterrepräsentiert bleiben. Mehr Optimierung behebt das nicht automatisch; die Qualität des Signals und die Abdeckung in der Evaluation bleiben entscheidend.
RLHF bescheinigt deshalb für sich genommen weder Sicherheit noch Wahrheitsgehalt. Ein Modell kann für die Bewertenden hilfreicher klingen und dennoch faktische Fehler machen. Gewünschte Eigenschaften erfordern spezifische Prüfungen, Evaluationen außerhalb der Trainingsdaten, Fehleranalysen und bei risikoreichen Anwendungen geeignete Schutzmaßnahmen und Aufsicht. Die Belohnung ist als Trainingsziel zu verstehen, nicht als Verhaltenszertifikat.
Häufige Missverständnisse und praktische Prüffragen
Ein häufiges Missverständnis lautet, Menschen würden dem Modell „direkt menschliche Werte beibringen“. In einem typischen Ablauf geben sie begrenzte Urteile ab; ein Belohnungsmodell lernt, diese vorherzusagen. Anschließend wird die Policy an dieser Näherung ausgerichtet. Das Ergebnis hängt davon ab, wie die Kriterien definiert wurden, wer annotiert hat und wie die einzelnen Komponenten trainiert und evaluiert wurden.
Ein weiterer Fehler ist, Demonstrationen, Vergleiche und Punktzahlen als gleichwertig zu behandeln. Eine Demonstration liefert ein Beispiel für eine Ausgabe, ein Vergleich gibt an, welche von mehreren Optionen bevorzugt wird, und eine Punktzahl bewertet eine Antwort anhand einer Skala. Diese Signale unterscheiden sich und erfordern jeweils eigene Interpretationen und Trainingsverfahren. Ebenso sollte nicht jede Anpassung nach dem Vortraining als RLHF bezeichnet werden, wenn der Einsatz menschlicher Präferenzen und der verwendete Mechanismus nicht geprüft wurden.
Außerdem sollte man nicht ohne nähere Angaben behaupten, eine Methode „richte das Modell an menschlichen Werten aus“. Präziser ist es, die Aufgabe, die Gruppe der Bewertenden, die Art des Feedbacks und den Umfang der Evaluation zu benennen. Wird lediglich ein Beispiel zur Veranschaulichung angeführt, sollte es als hypothetisches Szenario und nicht als beobachtetes Ergebnis gekennzeichnet werden.
Bei Aussagen zu RLHF helfen folgende Fragen: Was wurde bewertet? Wer hat bewertet? Welches Signal wurde erzeugt? Wurde ein separates Belohnungsmodell trainiert? Welcher Algorithmus hat die Policy verändert? Welche unabhängige Evaluation stützt die Schlussfolgerung? So lässt sich eine konkrete technische Beschreibung von einer allgemeinen Aussage über Alignment unterscheiden.
Diese Erläuterung konzentriert sich auf maschinelles Lernen und insbesondere auf den verbreiteten Ablauf für Sprachmodelle. Das technische Buch von Nathan Lambert bietet eine umfassende Darstellung der RLHF-Methoden und -Phasen. Die konsultierte Seite stellt das Buch jedoch als arXiv-Version vor; allein daraus lässt sich keine Begutachtung durch Fachkolleginnen und Fachkollegen ableiten. Die erklärende Dokumentation von AWS ergänzt die Beschreibung des Ablaufs, ersetzt aber nicht die Primärarbeiten zu den einzelnen Implementierungen.
Checkliste zur Beschreibung eines Systems
Mit diesen Fragen lassen sich Trainingsphasen, Datensignale und Leistungsversprechen auseinanderhalten.
| Frage | Was ist zu klären? |
|---|---|
| Welches Feedback wurde erfasst? | Vergleiche, Rankings, Punktzahlen, Korrekturen oder Demonstrationen |
| Wer hat bewertet? | Gruppe, Fachkenntnis, Anweisungen und Umgang mit abweichenden Urteilen |
| Wie wurde das Feedback verwendet? | Überwachtes Feintuning, Belohnungsmodell, direkte Optimierung oder ein anderer Weg |
| Welche Aussage soll getroffen werden? | Beobachtete Präferenz, Qualität, Sicherheit, Wahrheitsgehalt oder ein anderes Ergebnis |
| Welche Evidenz stützt sie? | Eine spezifische, unabhängige und für den Kontext geeignete Evaluation |