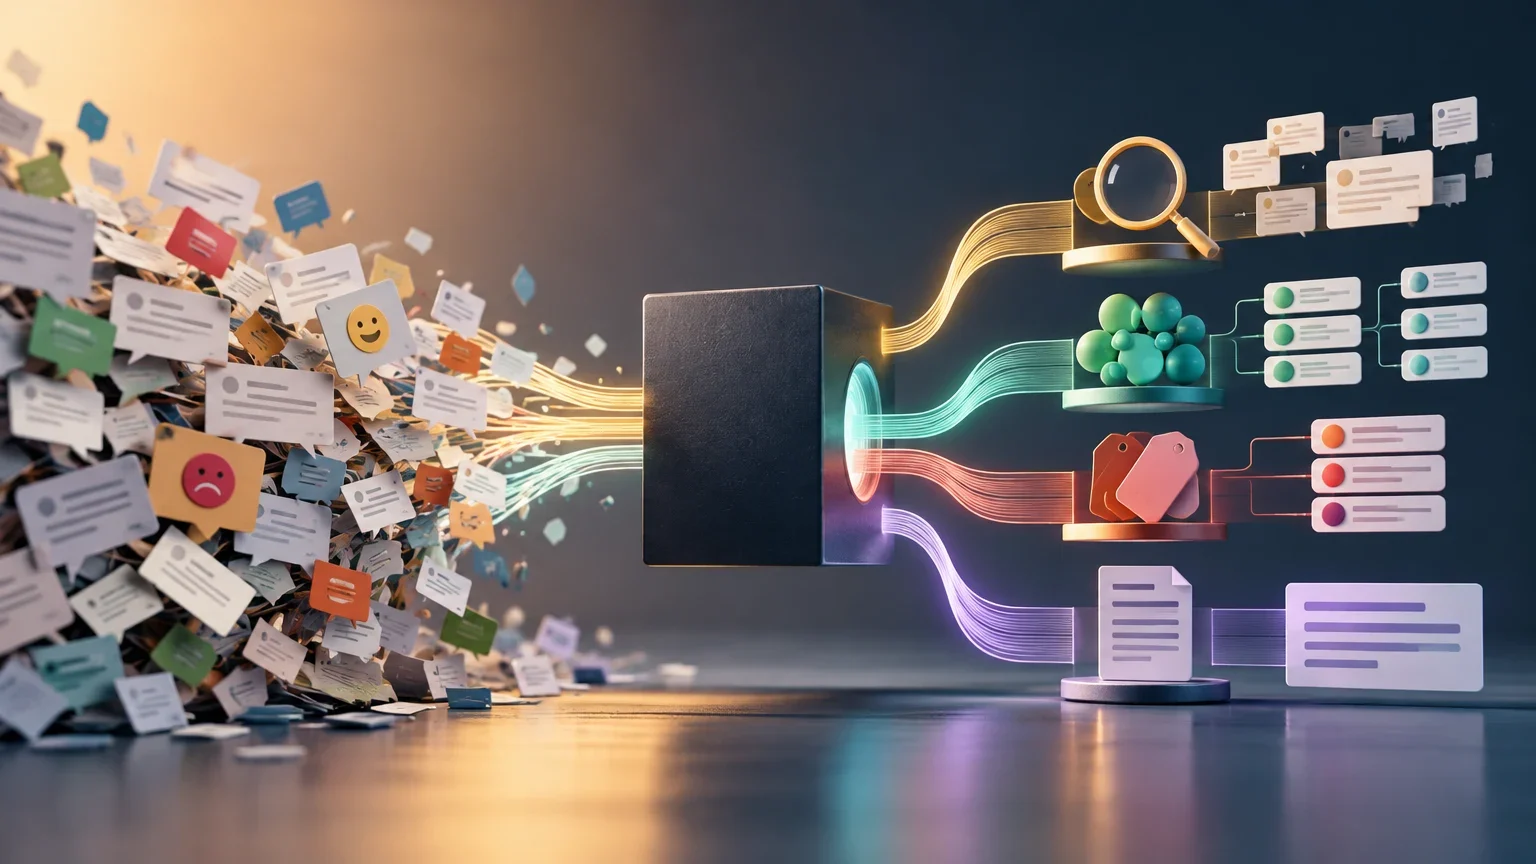
Delimitar el problema: cuatro tareas distintas
El primer paso para elegir una herramienta de análisis de feedback es identificar qué se necesita hacer con los datos. No es lo mismo encontrar un comentario específico que descubrir patrones ocultos o redactar un resumen ejecutivo. Confundir estas tareas lleva a implementar soluciones costosas para problemas simples o, por el contrario, a usar métodos rudimentarios para necesidades complejas.
Existen cuatro necesidades principales: localizar comentarios relevantes mediante búsqueda, agrupar temas mediante descubrimiento exploratorio, medir categorías conocidas mediante clasificación supervisada y redactar una síntesis mediante generación asistida. Cada una requiere un enfoque técnico diferente y tiene implicaciones distintas en cuanto a coste, precisión y mantenimiento.
La distinción entre estas cuatro tareas no es meramente académica, sino que determina la arquitectura técnica y los recursos humanos necesarios para su ejecución. Confundir la búsqueda con la clasificación, por ejemplo, puede llevar a la implementación de modelos de aprendizaje profundo innecesariamente complejos para una tarea que podría resolverse con índices invertidos eficientes. Por el contrario, intentar descubrir patrones ocultos mediante reglas estáticas puede resultar en una pérdida significativa de información valiosa que solo un enfoque exploratorio podría revelar.
Además, cada tarea implica un nivel diferente de intervención humana en el ciclo de vida del análisis. La búsqueda y la clasificación suelen tener un componente de automatización más alto, mientras que el descubrimiento y la generación requieren una supervisión constante para validar la coherencia semántica y la fidelidad de los resultados. Entender estas implicaciones permite al equipo asignar recursos de forma más eficiente, evitando cuellos de botella en la revisión manual o sobrecostos en la infraestructura de cómputo.
Diferencias entre las cuatro tareas de análisis
Tabla que contrasta el objetivo, la entrada típica y la salida esperada de cada tarea.
| Tarea | Objetivo principal | Entrada típica | Salida esperada |
|---|---|---|---|
| Búsqueda | Localizar comentarios específicos | Consulta textual o semántica | Lista de comentarios relevantes |
| Descubrimiento | Identificar temas sin etiquetas previas | Corpus de texto no etiquetado | Grupos de comentarios similares |
| Clasificación | Asignar categorías conocidas | Texto y taxonomía definida | Etiquetas por comentario |
| Generación | Redactar una síntesis | Corpus completo o filtrado | Texto narrativo resumen |
Entradas y restricciones del corpus
Antes de comparar técnicas, es necesario auditar las características del conjunto de datos. Los comentarios de clientes rara vez son homogéneos: provienen de encuestas, tickets de soporte, reseñas públicas y redes sociales, cada uno con su propio formato, longitud y nivel de estructura.
Factores críticos incluyen el volumen total de comentarios, la diversidad de idiomas, la frecuencia con la que llegan nuevos datos y la presencia de información personal. Un corpus pequeño y estable puede gestionarse con reglas simples, mientras que un flujo continuo multilingüe exige modelos capaces de generalizar y actualizarse con frecuencia.
La heterogeneidad de las fuentes de datos presenta un desafío adicional: la normalización de formatos y la limpieza de ruido son pasos previos indispensables antes de aplicar cualquier técnica de análisis. Los comentarios de redes sociales, por ejemplo, suelen contener abreviaturas, emojis y variaciones ortográficas que pueden distorsionar los resultados si no se preprocesan adecuadamente. En cambio, los tickets de soporte suelen tener una estructura más formal, pero pueden incluir metadatos técnicos que no son relevantes para el análisis semántico del contenido.
La frecuencia de actualización de los datos también influye en la elección de la herramienta. Un corpus que se actualiza diariamente requiere un sistema capaz de procesar incrementos de datos de forma eficiente, sin necesidad de reentrenar modelos completos cada vez. Esto favorece arquitecturas que permiten la inferencia en tiempo real o por lotes pequeños, en lugar de procesos por lotes masivos que solo se ejecutan semanalmente o mensualmente.
Comparación de alternativas técnicas
Para la tarea de localización, la búsqueda literal es suficiente si las consultas son exactas, pero la búsqueda semántica permite encontrar comentarios relacionados conceptualmente aunque no compartan palabras clave. Para el descubrimiento de temas, el agrupamiento exploratorio (clustering) identifica patrones sin necesidad de etiquetas previas, aunque requiere interpretación humana para nombrar los grupos.
La clasificación supervisada es la opción más robusta cuando se dispone de una taxonomía definida y ejemplos etiquetados. Permite medir la precisión y corregir errores de forma sistemática. La generación asistida, por su parte, es útil para sintetizar grandes volúmenes, pero debe usarse con cautela para evitar alucinaciones o resúmenes que no reflejen fielmente las fuentes.
La elección entre búsqueda literal y semántica depende en gran medida de la precisión requerida y de la naturaleza de las consultas. La búsqueda literal es determinista y predecible, lo que la hace ideal para auditorías o verificaciones de cumplimiento donde cada palabra clave debe coincidir exactamente. Sin embargo, su rigidez puede llevar a omitir comentarios relevantes que expresan la misma idea con vocabulario diferente. La búsqueda semántica, al captar el significado subyacente, ofrece una cobertura más amplia, pero introduce un grado de subjetividad que debe ser calibrado mediante umbrales de similitud adecuados.
En el caso del agrupamiento exploratorio, la interpretación humana es un componente crítico que no puede ser automatizado por completo. Los algoritmos de clustering generan grupos basados en similitudes matemáticas, pero nombrar estos grupos y asignarles un significado de negocio requiere el conocimiento experto del equipo. Este proceso de interpretación debe documentarse para garantizar la consistencia en futuras iteraciones del análisis y para facilitar la comunicación de los hallazgos a las partes interesadas.
Matriz de decisión para elegir el enfoque
La elección final depende de cruzar el resultado requerido con las condiciones operativas del equipo. Si no hay etiquetas previas y se necesita descubrir temas, el agrupamiento exploratorio es el punto de partida. Si las categorías están definidas y hay ejemplos etiquetados, la clasificación supervisada ofrece mayor control y trazabilidad.
El presupuesto, la latencia aceptable y la capacidad de revisión humana son factores determinantes. Un sistema en tiempo real exige infraestructura más costosa que uno por lotes. Además, la tolerancia al error varía según el uso: un error en la clasificación de una queja de seguridad es más grave que un error en la categorización de un elogio.
La disponibilidad de etiquetas previas es un factor determinante que a menudo se subestima en la planificación inicial. Si la organización no cuenta con una taxonomía definida, el esfuerzo de etiquetado manual puede ser prohibitivo, lo que hace que el agrupamiento exploratorio sea la opción más viable para iniciar el proceso. Una vez que se han identificado los temas principales mediante clustering, es posible definir una taxonomía inicial y comenzar a etiquetar ejemplos para entrenar modelos de clasificación supervisada en fases posteriores.
La capacidad de revisión humana también debe evaluarse en función del volumen de datos y la complejidad de las categorías. Un equipo pequeño puede gestionar la revisión de una muestra representativa de comentarios clasificados, pero si el volumen es muy alto, es necesario implementar mecanismos de muestreo estratificado o sistemas de confianza que prioricen la revisión de los casos con menor certeza del modelo. Esto asegura que los recursos humanos se destinen a los casos más críticos o ambiguos, maximizando el impacto de la supervisión.
Matriz de decisión simplificada
Guía rápida para seleccionar la técnica inicial según la disponibilidad de etiquetas y la necesidad de actualización.
| Condición | Enfoque recomendado | Consideración clave |
|---|---|---|
| Sin etiquetas previas | Agrupamiento exploratorio | Requiere interpretación humana de clusters |
| Con etiquetas y ejemplos | Clasificación supervisada | Permite medir precisión y corregir |
| Necesidad de síntesis | Generación asistida | Verificar fidelidad a las fuentes |
| Búsqueda puntual | Búsqueda semántica | Menor coste que modelos complejos |
Errores relevantes y comprobaciones operativas
Los errores más costosos no son siempre los más visibles. Omitir una señal crítica, como una queja de seguridad, puede tener consecuencias graves. Asignar una categoría incorrecta puede derivar en acciones inapropiadas. Producir una síntesis que no esté respaldada por comentarios identificables erosiona la confianza en el sistema.
Antes de implementar, es esencial verificar que cada etiqueta o afirmación de la síntesis pueda rastrearse hasta los comentarios fuente. Debe existir un proceso de corrección cuando una persona detecta un error y un mecanismo de derivación a revisión humana para casos ambiguos o de alto impacto. La trazabilidad y la capacidad de auditoría son tan importantes como la precisión del modelo.
La trazabilidad no es solo una cuestión de auditoría, sino una herramienta fundamental para la mejora continua del sistema. Al poder rastrear cada etiqueta o afirmación hasta los comentarios fuente, el equipo puede identificar sistemáticamente los tipos de errores que comete el modelo y ajustar los parámetros o los datos de entrenamiento en consecuencia. Este ciclo de retroalimentación es esencial para mantener la precisión del sistema a medida que cambian las tendencias del feedback de los clientes o se introducen nuevos productos o servicios.
El mecanismo de derivación a revisión humana debe estar diseñado para minimizar la fricción y maximizar la eficiencia. Los casos ambiguos o de alto impacto deben ser presentados a los revisores con el contexto completo, incluyendo los comentarios originales y las predicciones del modelo, para facilitar una decisión informada. Además, las decisiones tomadas por los revisores deben registrarse y utilizarse para reentrenar el modelo, cerrando el bucle de aprendizaje y mejorando la capacidad del sistema para manejar casos similares en el futuro.
Proceso de validación previa a la implementación
Pasos para asegurar que el enfoque elegido satisface las condiciones reales del equipo.
- 01Definir la tarea principal: búsqueda, descubrimiento, clasificación o generación.
- 02Auditar el corpus: volumen, idiomas, estructura y datos personales.
- 03Verificar disponibilidad de etiquetas y ejemplos representativos.
- 04Evaluar presupuesto, latencia y capacidad de revisión humana.
- 05Establecer mecanismo de trazabilidad y corrección de errores.
Qué sigue abierto
- No se dispone de datos comparativos independientes de coste o desempeño entre las técnicas para un mismo corpus.
- La eficacia de los modelos generativos para síntesis fiel depende de la calidad de las instrucciones y la verificación humana, sin métricas estándar universales.
- El impacto de la latencia en la satisfacción del cliente varía según el sector y no se cuantifica en las fuentes aportadas.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección