Definición en una frase
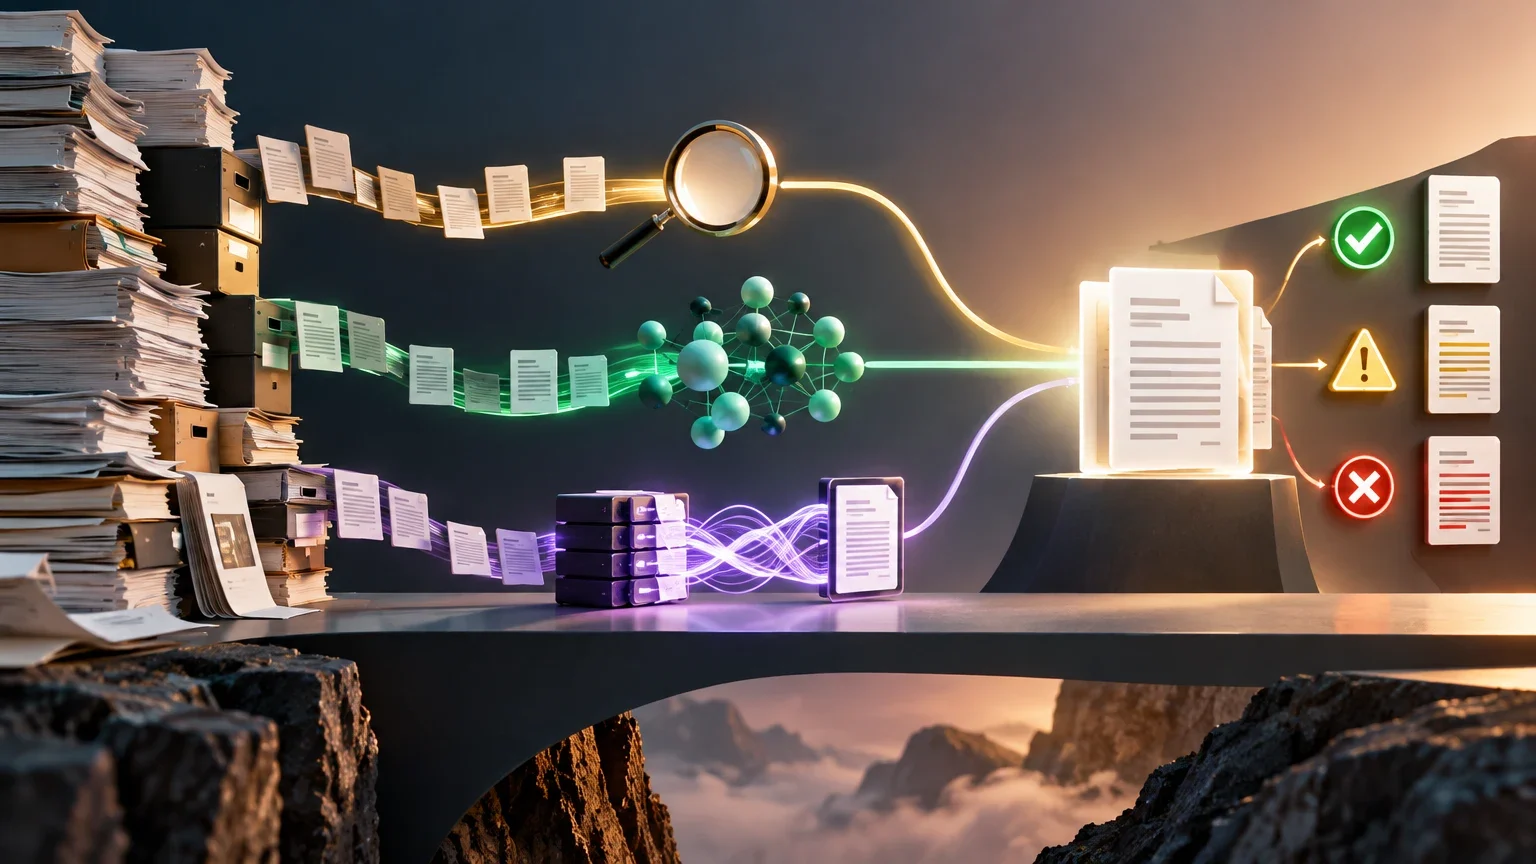
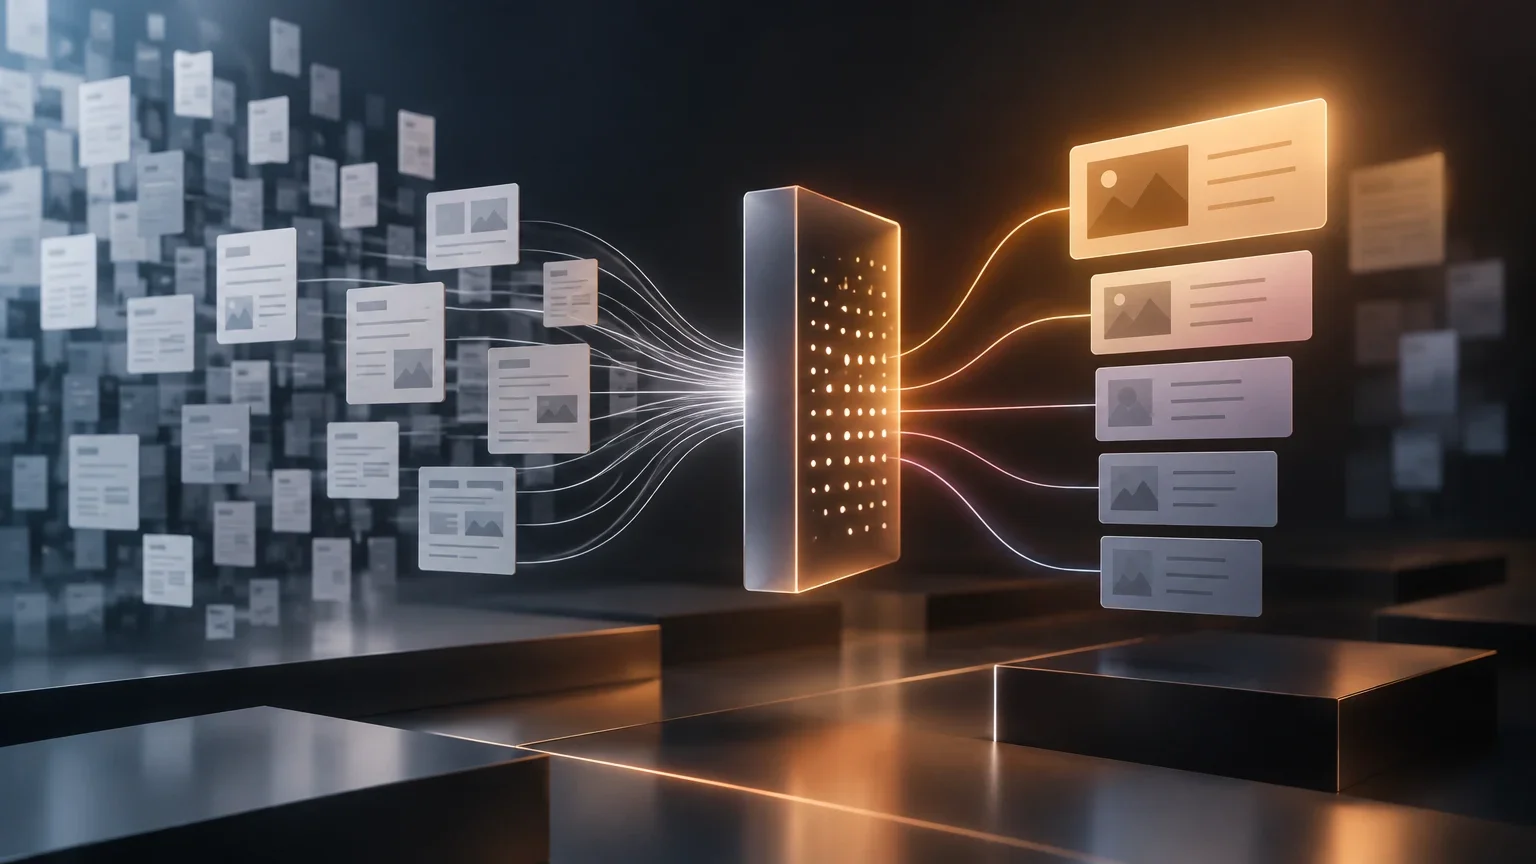
Segunda etapa que vuelve a puntuar candidatos recuperados para colocar primero los más relevantes para la consulta.
Definición precisa: Reranking como segunda etapa de puntuación
El reranking, o reordenación de resultados, es una técnica de recuperación de información que actúa como una segunda etapa de filtrado y puntuación. A diferencia de la búsqueda inicial, que busca capturar la mayor cantidad de documentos relevantes posibles (alto recall), el reranking se centra en refinar esa lista para garantizar que los documentos más pertinentes aparezcan en las primeras posiciones (alta precisión).
En sistemas de Recuperación Aumentada de Generación (RAG), esta etapa es crítica porque el modelo de lenguaje grande (LLM) solo puede procesar una cantidad limitada de contexto. Si la recuperación inicial devuelve documentos irrelevantes o ruidosos, la calidad de la respuesta generativa se degrada. El reranking interviene evaluando la relación semántica profunda entre la consulta específica del usuario y cada documento candidato, reordenando la lista para que el LLM reciba únicamente la información más valiosa.
La separación de estas dos etapas responde a una necesidad arquitectónica fundamental: la incompatibilidad entre la velocidad de búsqueda masiva y la profundidad de análisis semántico. Si se intentara aplicar un cross-encoder directamente sobre un corpus completo, el tiempo de inferencia sería prohibitivo para cualquier aplicación interactiva. Por ello, el sistema debe confiar primero en la eficiencia bruta del bi-encoder para acotar el espacio de búsqueda, reduciendo millones de documentos a un conjunto manejable. Solo entonces, el reranking puede actuar como un filtro de alta fidelidad, sacrificando velocidad por exactitud en una población reducida de candidatos. Esta jerarquía de procesamiento asegura que la carga computacional se distribuya de manera óptima, permitiendo que la etapa costosa de reordenación se ejecute únicamente sobre los elementos que han superado el umbral inicial de similitud vectorial, garantizando así un equilibrio viable entre la amplitud de la recuperación y la calidad final de la presentación de resultados al usuario.
Funcionamiento técnico: Bi-encoders vs. Cross-encoders
La distinción fundamental en el reranking radica en cómo se procesan la consulta y el documento. Los modelos de la primera etapa suelen ser bi-encoders (o modelos de embeddings), que transforman la consulta y los documentos en vectores independientes. Esto permite precalcular los vectores de los documentos y realizar comparaciones rápidas mediante similitud coseno, pero implica una pérdida de información al comprimir el significado en un único vector.
Los rerankers suelen ser cross-encoders. Estos modelos procesan la consulta y el documento simultáneamente como una sola entrada de texto. Esto permite al modelo capturar interacciones finas entre las palabras de la consulta y las del documento, logrando una puntuación de relevancia mucho más precisa. El coste es computacional: no se pueden precalcular los resultados, por lo que el modelo debe ejecutarse en tiempo real para cada par (consulta, documento), lo que introduce latencia.
La incapacidad de precalcular las puntuaciones en los cross-encoders tiene implicaciones directas en la arquitectura de la infraestructura. A diferencia de los embeddings, que pueden almacenarse en bases de datos vectoriales y consultarse mediante índices espaciales optimizados, las puntuaciones de reordenación son efímeras y dependientes del estado específico de la consulta en el momento de la ejecución. Esto obliga a que el componente de reranking esté siempre activo y disponible para realizar inferencias en tiempo real, lo que exige una gestión cuidadosa de la memoria y la potencia de procesamiento. En entornos de alta concurrencia, esta dependencia temporal puede convertirse en un cuello de botella si no se implementan estrategias de colas o procesamiento por lotes pequeños. La naturaleza dinámica de esta etapa significa que la latencia no es un valor fijo, sino una variable que fluctúa según la longitud de los documentos candidatos y la complejidad de la consulta, requiriendo que los sistemas de monitoreo vigilen constantemente el rendimiento de esta fase para evitar degradaciones en la experiencia del usuario final.
Comparativa de arquitecturas de puntuación
Resumen de las diferencias operativas entre la recuperación inicial y la reordenación.
| Característica | Bi-encoder (Etapa 1) | Cross-encoder (Etapa 2 / Reranking) |
|---|---|---|
| Procesamiento | Vectores independientes | Pareja (consulta + documento) |
| Precalculable | Sí (embeddings de documentos) | No (depende de la consulta) |
| Velocidad | Muy rápida (milisegundos) | Lenta (requiere inferencia por par) |
| Precisión | Media (pérdida de contexto) | Alta (interacción directa de tokens) |
Ejemplos aplicados en distintos ámbitos
En la documentación técnica empresarial, el reranking resuelve ambigüedades de términos. Por ejemplo, si una consulta busca 'feature scaling' en machine learning, la búsqueda vectorial podría devolver documentos sobre 'feature scaling' en edición de imágenes o diseño de producto. Un cross-encoder lee el contexto completo y descarta los documentos irrelevantes, elevando a la cima los textos que explican la normalización de variables en algoritmos como SVM o k-means.
En la recuperación de código, el reranking ayuda a seleccionar snippets específicos. Al buscar una función de autenticación, la recuperación inicial puede traer cientos de archivos. El reranking identifica qué fragmentos de código contienen la lógica exacta solicitada, filtrando las definiciones de variables o comentarios genéricos que no aportan valor a la generación de código por parte del LLM.
En el contexto de la documentación técnica, la capacidad del reranker para distinguir entre homónimos técnicos es crucial para evitar la propagación de errores en la respuesta generativa. Cuando un término tiene múltiples significados en diferentes subdominios, la similitud coseno puede fallar al no capturar la intención contextual específica del usuario. El cross-encoder, al analizar la interacción token a token, identifica las pistas contextuales que delimitan el ámbito de aplicación correcto. Por ejemplo, en la normalización de variables, el modelo detecta referencias a estadística o algoritmos de clasificación, descartando automáticamente los documentos que asocian el término con operaciones gráficas o de diseño. Esta precisión en la desambiguación no solo mejora la relevancia de los documentos recuperados, sino que también reduce la probabilidad de que el LLM genere respuestas confusas o incoherentes al mezclar conceptos de dominios distintos, asegurando que la información proporcionada sea coherente con el marco de referencia implícito en la consulta del usuario.
Confusiones frecuentes y conceptos próximos
Un error común es confundir el reranking con el scoring de similitud coseno. La similitud coseno es la métrica utilizada en la primera etapa para comparar vectores precalculados. El reranking es un proceso posterior que utiliza un modelo de lenguaje (generalmente un transformer) para asignar una puntuación de relevancia binaria o probabilística a cada par. No son lo mismo: uno es una comparación geométrica rápida, el otro es una inferencia semántica profunda.
Otra confusión es asumir que recuperar más documentos siempre mejora la respuesta. Debido a la limitación de la ventana de contexto de los LLM y al fenómeno de 'pérdida en el medio' (lost in the middle), saturar el contexto con documentos irrelevantes puede degradar el rendimiento del modelo. El reranking permite recuperar muchos documentos (alto recall) pero enviar solo los mejores (alta precisión) al LLM.
La distinción entre la métrica geométrica de la primera etapa y la inferencia semántica de la segunda es fundamental para entender por qué el reranking no es simplemente una extensión de la búsqueda vectorial, sino un cambio de paradigma en el procesamiento de la información. La similitud coseno mide la proximidad angular entre vectores, una operación algebraica rápida pero superficial que no comprende el significado lingüístico. En cambio, el reranking utiliza la capacidad de un transformer para interpretar el texto completo, evaluando la coherencia lógica y la pertinencia temática. Esta diferencia explica por qué dos documentos pueden tener vectores muy cercanos en el espacio vectorial, pero ser radicalmente distintos en su utilidad práctica para una consulta específica. El reranking actúa como un corrector de estas limitaciones inherentes a la representación vectorial, añadiendo una capa de inteligencia semántica que permite al sistema distinguir entre la mera presencia de términos y la verdadera relevancia del contenido para la tarea que el usuario intenta resolver.
Límites operativos: Latencia y escalabilidad
El principal límite del reranking es la latencia. Como el cross-encoder debe procesar cada documento candidato individualmente, el tiempo de respuesta crece linealmente con el número de candidatos. Procesar millones de documentos con un reranker es inviable; por ello, esta técnica solo se aplica a un subconjunto pequeño (top-k) de los resultados de la primera etapa.
En escalas grandes, el coste computacional puede ser significativo. Si se utiliza un modelo de reranking alojado en la nube, cada consulta genera un coste adicional por token procesado. Los arquitectos deben equilibrar el número de candidatos a reordenar (por ejemplo, recuperar 50 y reordenar a 5) para mantener la latencia dentro de los límites aceptables para la aplicación, especialmente en sistemas de tiempo real.
La gestión de la latencia en sistemas de tiempo real requiere una estrategia de escalado que considere no solo el número de documentos, sino también la complejidad computacional de cada inferencia. Al aumentar el top-k de la recuperación inicial, se incrementa linealmente la carga sobre el reranker, lo que puede llevar a tiempos de respuesta inaceptables si no se optimiza la infraestructura subyacente. Los arquitectos deben realizar pruebas de carga rigurosas para determinar el punto de equilibrio donde la mejora en la precisión deja de justificar el coste adicional en latencia. Además, la variabilidad en la longitud de los documentos candidatos puede introducir picos de latencia impredecibles, ya que el tiempo de inferencia depende directamente del número de tokens procesados. Por ello, es recomendable implementar límites de longitud en los documentos que se envían al reranker, truncando el contenido si es necesario, para garantizar que la latencia total del pipeline se mantenga dentro de los umbrales definidos por los acuerdos de nivel de servicio, asegurando una experiencia de usuario consistente y predecible.
Flujo de decisión para implementar Reranking
Pasos para determinar si el reranking es necesario en su pipeline.
- 01Evaluar la precisión actual de la recuperación inicial (top-5).
- 02Si la precisión es baja y la latencia actual es baja, añadir reranking.
- 03Limitar el top-k de la recuperación inicial (ej. 20-50 documentos).
- 04Aplicar el reranker para seleccionar el top-n final (ej. 3-5 documentos).
- 05Medir la latencia total y ajustar el top-k si excede los SLA.