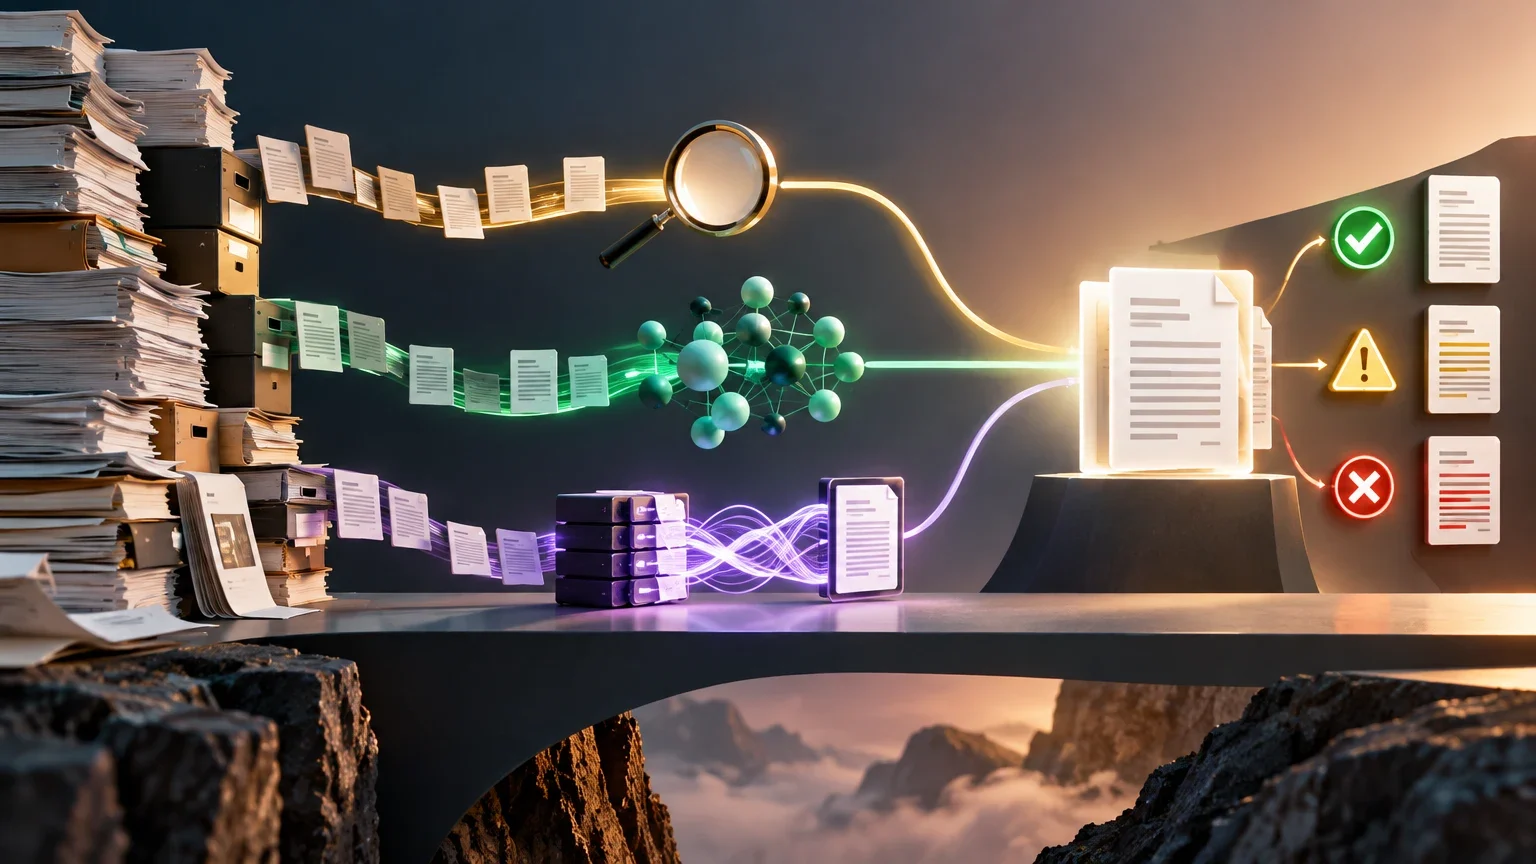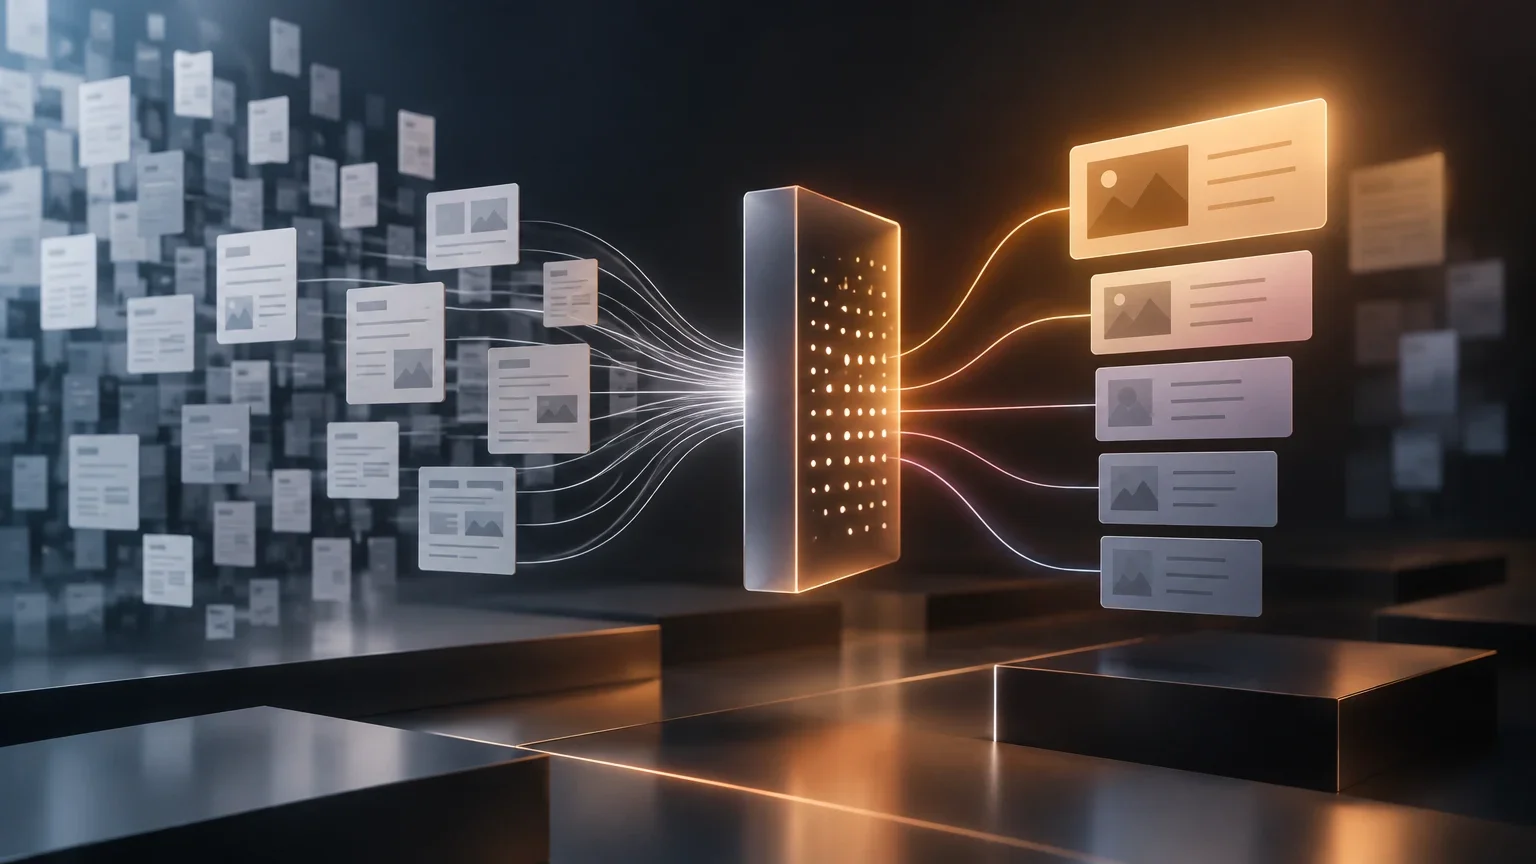
Définition en une phrase
Segunda etapa que vuelve a puntuar candidatos recuperados para colocar primero los más relevantes para la consulta.
Définition précise : Le reranking comme deuxième étape de scoring
Le reranking, ou réordonnancement des résultats, est une technique de récupération d'information qui agit comme une seconde étape de filtrage et de scoring. Contrairement à la recherche initiale, qui vise à capturer le maximum de documents pertinents (rappel élevé), le reranking se concentre sur le raffinement de cette liste pour garantir que les documents les plus pertinents apparaissent en tête (précision élevée).
Dans les systèmes de Génération Augmentée par Récupération (RAG), cette étape est critique car le grand modèle de langage (LLM) ne peut traiter qu'une quantité limitée de contexte. Si la récupération initiale renvoie des documents irrélents ou bruités, la qualité de la réponse générative se dégrade. Le reranking intervient en évaluant la relation sémantique profonde entre la requête spécifique de l'utilisateur et chaque document candidat, réordonnant la liste pour que le LLM ne reçoive que l'information la plus précieuse.
Cette distinction entre rappel et précision est fondamentale pour comprendre l'architecture des systèmes de recherche modernes. La recherche vectorielle initiale, en privilégiant le rappel, accepte volontairement une certaine quantité de bruit dans les résultats afin de ne pas manquer de documents potentiellement pertinents. Cette approche est efficace pour élargir le champ des possibles, mais elle laisse au reranking la tâche délicate de trier ce bruit. En élevant la précision, le reranking s'assure que les positions les plus hautes de la liste sont occupées par des documents dont la pertinence est incontestable, ce qui est crucial lorsque la suite du pipeline, comme un LLM, ne peut consommer qu'une fraction limitée de ces résultats.
Dans le contexte des systèmes RAG, la qualité de la réponse générative dépend directement de la pertinence des documents injectés dans le contexte du modèle. Si la récupération initiale est trop large et non filtrée, le LLM risque de se disperser sur des informations secondaires ou contradictoires, ce qui dilue la cohérence de la réponse finale. Le reranking agit comme un garde-fou sémantique : il évalue la profondeur de la relation entre la requête et chaque document, permettant ainsi de ne transmettre au LLM que l'information la plus dense et la plus directement utile. Cette étape de raffinement est donc indispensable pour garantir que la génération de texte repose sur une base factuelle solide et ciblée, plutôt que sur un ensemble hétérogène de documents.
Fonctionnement technique : Bi-encoders vs. Cross-encoders
La distinction fondamentale dans le reranking réside dans la manière dont la requête et le document sont traités. Les modèles de la première étape sont généralement des bi-encoders (ou modèles d'embeddings), qui transforment la requête et les documents en vecteurs indépendants. Cela permet de précalculer les vecteurs des documents et d'effectuer des comparaisons rapides via la similarité cosinus, mais implique une perte d'information en compressant le sens dans un unique vecteur.
Les rerankers sont souvent des cross-encoders. Ces modèles traitent la requête et le document simultanément comme une seule entrée de texte. Cela permet au modèle de capturer les interactions fines entre les mots de la requête et ceux du document, aboutissant à un score de pertinence beaucoup plus précis. Le coût est computationnel : les résultats ne peuvent pas être précalculés, le modèle doit donc s'exécuter en temps réel pour chaque paire (requête, document), ce qui introduit une latence.
La compression du sens dans un vecteur unique, caractéristique des bi-encoders, implique une perte d'information inévitable. Bien que cette méthode permette des comparaisons rapides grâce à la similarité cosinus, elle ne capture pas les nuances contextuelles subtiles entre les termes de la requête et ceux du document. Le cross-encoder, en revanche, traite la paire de texte comme une entité unique, ce qui lui permet de détecter des interactions lexicales et sémantiques fines que les vecteurs indépendants ne peuvent pas représenter. Cette capacité à modéliser la relation directe entre les tokens de la requête et ceux du document est ce qui confère au reranking sa précision supérieure, au prix d'une complexité computationnelle accrue.
Le coût computationnel du cross-encoder est directement lié à l'impossibilité de précalculer les scores. Contrairement aux embeddings des documents, qui peuvent être stockés et réutilisés pour de multiples requêtes, chaque score de reranking dépend étroitement de la requête spécifique de l'utilisateur. Cela signifie que le modèle doit effectuer une inférence complète pour chaque paire (requête, document) au moment de la demande, introduisant une latence qui augmente avec le nombre de candidats à évaluer. Cette contrainte opérationnelle impose une architecture en deux étapes, où la rapidité du bi-encoder permet de réduire le champ des possibles, et la précision du cross-encoder affine ensuite cette sélection restreinte.
Comparaison des architectures de scoring
Résumé des différences opérationnelles entre la récupération initiale et le réordonnancement.
| Caractéristique | Bi-encoder (Étape 1) | Cross-encoder (Étape 2 / Reranking) |
|---|---|---|
| Traitement | Vecteurs indépendants | Paire (requête + document) |
| Précalculable | Oui (embeddings des documents) | Non (dépend de la requête) |
| Vitesse | Très rapide (millisecondes) | Lente (inférence par paire) |
| Précision | Moyenne (perte de contexte) | Élevée (interaction directe des tokens) |
Exemples appliqués dans différents domaines
Dans la documentation technique d'entreprise, le reranking résout les ambiguïtés terminologiques. Par exemple, si une requête cherche 'feature scaling' en machine learning, la recherche vectorielle pourrait renvoyer des documents sur le 'feature scaling' en édition d'images ou en conception de produit. Un cross-encoder lit le contexte complet et écarte les documents irrélents, hissant en tête les textes expliquant la normalisation des variables dans des algorithmes comme SVM ou k-means.
Dans la récupération de code, le reranking aide à sélectionner des extraits spécifiques. En cherchant une fonction d'authentification, la récupération initiale peut apporter des centaines de fichiers. Le reranking identifie quels fragments de code contiennent la logique exacte demandée, filtrant les définitions de variables ou les commentaires génériques qui n'apportent aucune valeur à la génération de code par le LLM.
Dans la documentation technique d'entreprise, les ambiguïtés terminologiques sont fréquentes et peuvent mener à des résultats trompeurs. Le terme 'feature scaling', par exemple, peut désigner des concepts distincts selon le domaine : la normalisation de variables en machine learning, le redimensionnement d'images en édition graphique, ou l'ajustement de maquettes en conception de produit. La recherche vectorielle, basée sur la similarité sémantique globale, peut confondre ces usages si le contexte n'est pas explicite. Le cross-encoder, en lisant l'intégralité du document et de la requête, identifie les marqueurs contextuels qui ancrent le terme dans un domaine spécifique, écartant ainsi les documents qui, bien que sémantiquement proches, traitent d'un sujet différent.
En récupération de code, la granularité de la pertinence est essentielle. Une requête cherchant une fonction d'authentification peut renvoyer des centaines de fichiers contenant des mots-clés associés, comme 'login' ou 'token', mais sans la logique exacte demandée. Le reranking permet de distinguer les fragments de code qui implémentent réellement la fonctionnalité recherchée de ceux qui ne font que la mentionner ou la définir de manière générique. En filtrant les définitions de variables, les commentaires ou les imports inutiles, le reranking s'assure que le LLM reçoit des extraits de code fonctionnels et pertinents, ce qui améliore la qualité de la génération de code et réduit le risque d'erreurs syntaxiques ou logiques dans la réponse finale.
Confusions fréquentes et concepts proches
Une erreur courante est de confondre le reranking avec le scoring de similarité cosinus. La similarité cosinus est la métrique utilisée à la première étape pour comparer des vecteurs précalculés. Le reranking est un processus ultérieur qui utilise un modèle de langage (généralement un transformer) pour attribuer un score de pertinence binaire ou probabiliste à chaque paire. Ce ne sont pas la même chose : l'un est une comparaison géométrique rapide, l'autre est une inférence sémantique profonde.
Une autre confusion consiste à supposer que récupérer plus de documents améliore toujours la réponse. En raison de la limitation de la fenêtre de contexte des LLM et du phénomène de 'perte au milieu' (lost in the middle), saturer le contexte avec des documents irrélents peut dégrader les performances du modèle. Le reranking permet de récupérer de nombreux documents (rappel élevé) mais n'envoie au LLM que les meilleurs (précision élevée).
La confusion entre le scoring de similarité cosinus et le reranking est fréquente car les deux impliquent une évaluation de la pertinence. Cependant, la similarité cosinus est une métrique géométrique appliquée à des vecteurs précalculés, offrant une approximation rapide de la proximité sémantique. Le reranking, en revanche, est un processus d'inférence sémantique profonde qui utilise un modèle de langage, généralement un transformer, pour analyser la relation directe entre les tokens de la requête et du document. Cette distinction est cruciale : la première est une comparaison de positions dans un espace vectoriel, la seconde est une interprétation contextuelle du texte, permettant de capturer des nuances que la simple similarité vectorielle ne peut pas détecter.
L'idée que récupérer plus de documents améliore toujours la réponse est un piège courant, surtout dans les systèmes RAG. Les LLM ont une fenêtre de contexte limitée et sont sujets au phénomène de 'perte au milieu', où les informations situées au centre du contexte sont moins bien intégrées que celles au début ou à la fin. Saturer le contexte avec des documents irrélents ou de faible pertinence peut donc dégrader les performances du modèle, en le distrayant de l'information clé. Le reranking résout ce problème en permettant une récupération initiale large (rappel élevé) tout en garantissant que seuls les documents les plus pertinents (précision élevée) sont envoyés au LLM, optimisant ainsi l'utilisation de la fenêtre de contexte et la qualité de la réponse générée.
Limites opérationnelles : Latence et scalabilité
La principale limite du reranking est la latence. Comme le cross-encoder doit traiter chaque document candidat individuellement, le temps de réponse augmente linéairement avec le nombre de candidats. Traiter des millions de documents avec un reranker est inviable ; c'est pourquoi cette technique ne s'applique qu'à un sous-ensemble restreint (top-k) des résultats de la première étape.
À grande échelle, le coût computationnel peut être significatif. Si un modèle de reranking hébergé dans le cloud est utilisé, chaque requête génère un coût supplémentaire par token traité. Les architectes doivent équilibrer le nombre de candidats à réordonner (par exemple, récupérer 50 et réordonner à 5) pour maintenir la latence dans des limites acceptables pour l'application, en particulier dans les systèmes en temps réel.
La latence du reranking est une contrainte majeure qui doit être gérée avec soin. Comme le cross-encoder traite chaque document candidat individuellement, le temps de réponse augmente linéairement avec le nombre de documents à évaluer. Cette caractéristique rend le reranking inviable pour de très grands ensembles de documents, ce qui justifie son application uniquement à un sous-ensemble restreint (top-k) des résultats de la première étape. Cette approche en deux étapes permet de bénéficier de la précision du reranking sans sacrifier la rapidité de la recherche initiale, en limitant le nombre de paires (requête, document) que le modèle doit traiter en temps réel.
À grande échelle, le coût computationnel du reranking peut devenir significatif, surtout si le modèle est hébergé dans le cloud. Chaque requête génère un coût supplémentaire proportionnel au nombre de tokens traités, ce qui peut impacter la rentabilité du système. Les architectes doivent donc trouver un équilibre entre la qualité des résultats et la performance, en ajustant le nombre de candidats à réordonner. Par exemple, récupérer 50 documents initialement pour en sélectionner 5 via le reranking est une stratégie courante qui permet de maintenir la latence dans des limites acceptables pour les applications en temps réel, tout en garantissant une précision élevée pour la génération de réponse par le LLM.
Flux de décision pour implémenter le Reranking
Étapes pour déterminer si le reranking est nécessaire dans votre pipeline.
- 01Évaluer la précision actuelle de la récupération initiale (top-5).
- 02Si la précision est faible et la latence actuelle est basse, ajouter du reranking.
- 03Limiter le top-k de la récupération initiale (ex. 20-50 documents).
- 04Appliquer le reranker pour sélectionner le top-n final (ex. 3-5 documents).
- 05Mesurer la latence totale et ajuster le top-k si les SLA sont dépassés.