Définition en une phrase
Familia de métodos que usa preferencias humanas para entrenar señales de recompensa y orientar el comportamiento de un modelo.
Qu’est-ce que le RLHF ?
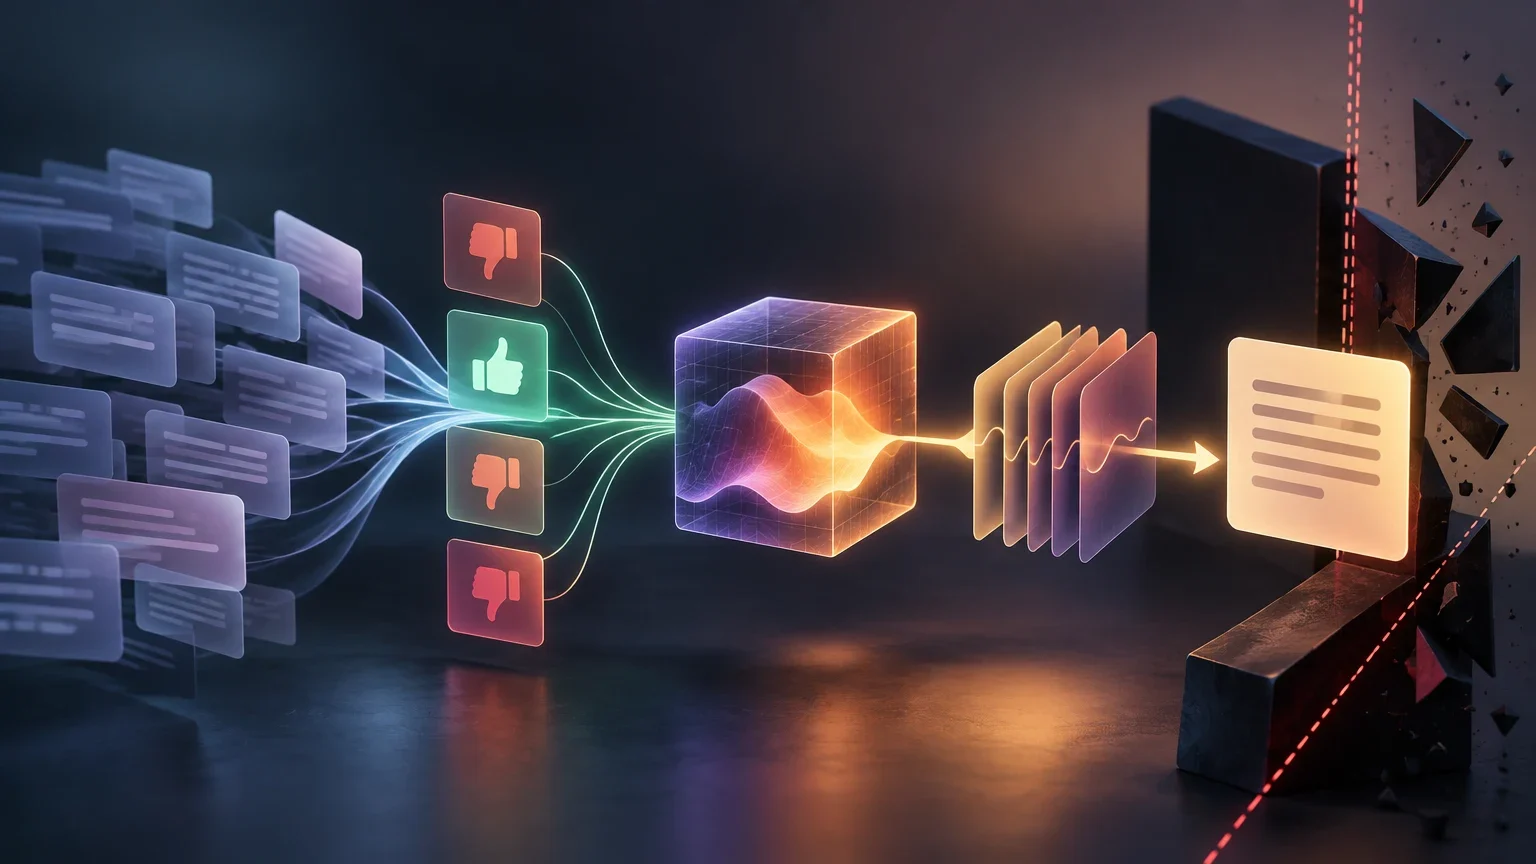
L’apprentissage par renforcement à partir de retours humains — RLHF, pour l’anglais « Reinforcement Learning from Human Feedback » — désigne une famille de méthodes qui s’appuient sur des évaluations ou des préférences humaines pour construire un signal de récompense et orienter l’optimisation d’un modèle. Dans une mise en œuvre courante, des personnes comparent plusieurs réponses possibles. Ces comparaisons servent à entraîner un modèle de récompense, qui attribue ensuite des scores aux réponses produites par la politique en cours d’ajustement.
Cette approche est utile lorsqu’il est plus facile de juger laquelle de deux réponses est préférable que de rédiger une règle mathématique complète définissant la réponse idéale. Une personne peut, par exemple, évaluer si une réponse est claire, pertinente ou prudente. Le modèle de récompense approxime ces jugements à partir des données disponibles ; il ne transforme pas, à lui seul, des critères subjectifs en une définition universelle de la qualité.
Le RLHF ne correspond pas à une recette unique et immuable. Le type de retour, sa méthode de collecte, le modèle utilisé pour apprendre les préférences et la méthode d’optimisation qui suit peuvent varier. Pour les modèles de langage, une configuration connue associe réglage fin supervisé, comparaisons humaines, entraînement d’un modèle de récompense et optimisation par apprentissage par renforcement. PPO est un algorithme possible à cette dernière étape, mais il n’est pas obligatoire pour toute méthode fondée sur les préférences humaines.
La définition impose également de distinguer le signal humain du procédé qui le traite. La préférence observée est une donnée, le modèle de récompense est une approximation apprise, et la politique optimisée est le système que l’on cherche à modifier. Les confondre conduit à exagérer ce que la méthode permet d’établir : améliorer un score appris ne prouve pas, en soi, que le modèle est véridique, sûr ou représentatif de toutes les personnes.
Du jeu de données à la politique : le déroulement technique
Dans un processus fréquent appliqué aux modèles de langage, le point de départ est une politique initiale capable de produire des réponses. Elle peut provenir d’un modèle préentraîné et avoir d’abord fait l’objet d’un réglage fin supervisé, au cours duquel elle apprend à imiter des réponses de démonstration. Démonstrations et préférences remplissent des fonctions distinctes : les premières montrent des exemples de comportement, tandis que les secondes servent à comparer des réponses candidates.
Le système génère ensuite plusieurs réponses pour une même instruction. Des annotateurs humains les comparent ou les classent selon des critères définis pour le projet. Une comparaison par paires peut indiquer que, pour une question donnée, la réponse A est préférée à la réponse B. Ce jugement constitue une décision contextuelle : il ne révèle pas nécessairement toutes les raisons du choix et ne signifie pas que tous les évaluateurs sont d’accord.
Les comparaisons permettent d’entraîner un modèle de récompense. Dans le cas courant de préférences par paires, celui-ci apprend à attribuer des scores de sorte que la réponse choisie obtienne généralement un score supérieur à celui de la réponse écartée. La politique produit ensuite de nouvelles réponses et est optimisée pour obtenir des scores élevés selon cette récompense apprise. Des algorithmes comme PPO peuvent mettre à jour la politique ; certaines configurations limitent également son éloignement par rapport à un modèle de référence.
Chaque étape produit des artefacts différents : des démonstrations pour le réglage supervisé, des paires ou des classements annotés, un modèle de récompense, puis une politique ajustée. Les conserver distincts facilite l’audit du signal utilisé et des transformations appliquées. Si une étape est omise — par exemple si le modèle est ajusté directement à partir de démonstrations —, il ne faut pas automatiquement décrire le procédé comme le flux classique de RLHF avec un modèle de récompense explicite.
Ce schéma est un point de repère, pas une spécification universelle. Certaines conceptions utilisent d’autres formes de retour ou d’autres méthodes d’optimisation. Il existe aussi des approches d’optimisation des préférences qui évitent d’entraîner séparément un modèle de récompense avant d’appliquer un cycle conventionnel d’apprentissage par renforcement. Il est donc préférable de nommer la méthode effectivement utilisée, plutôt que de supposer que toute méthode d’alignement fondée sur les préférences suit exactement les mêmes étapes.
Étapes courantes et résultats associés
La séquence ci-dessous résume une configuration fréquente pour un modèle de langage ; les détails varient selon les mises en œuvre.
- 01Préparer une politique initiale et, le cas échéant, l’ajuster à partir de démonstrations supervisées.
- 02Générer plusieurs réponses pour des instructions sélectionnées.
- 03Recueillir des comparaisons, des classements ou d’autres évaluations humaines selon des critères définis.
- 04Entraîner un modèle de récompense qui approxime les préférences observées.
- 05Optimiser la politique à l’aide de cette récompense, en recourant à un algorithme d’apprentissage par renforcement lorsque la méthode le prévoit.
- 06Évaluer séparément le modèle obtenu : la récompense utilisée à l’entraînement ne remplace pas une évaluation indépendante.
Exemples d’application
Pour un assistant conversationnel, deux réponses à une même question peuvent être présentées à des évaluateurs. Ceux-ci pourraient préférer celle qui répond directement, distingue les faits des incertitudes et évite les éléments hors sujet. Les comparaisons permettent d’apprendre une récompense orientée vers ces critères, puis d’ajuster la politique. Cet exemple illustre le mécanisme ; il ne prétend pas qu’un assistant précis a été entraîné de cette façon.
Dans la modération de contenu, les évaluateurs pourraient comparer les décisions du système concernant un même extrait : le laisser en ligne, le supprimer ou le transmettre pour examen. Le retour peut refléter les règles et les priorités définies pour un contexte particulier. Avant de l’utiliser pour optimiser une politique, il faudrait préciser le préjudice que l’on cherche à réduire, le coût des faux positifs et des faux négatifs, ainsi que les voies de recours. La préférence d’un groupe d’annotateurs ne constitue pas, à elle seule, une norme sociale universelle.
Dans un système de recommandation, une personne peut préférer un résultat à un autre dans une situation donnée : par exemple, une option pertinente pour une recherche précise plutôt qu’une option populaire mais peu adaptée à la requête. Cette comparaison pourrait alimenter un modèle de récompense chargé de classer les résultats. Toutefois, un clic ou un choix observé n’exprime pas toujours la satisfaction : il peut dépendre de la position du résultat, de l’interface ou d’informations incomplètes. Avant de convertir ce comportement en retour, il faut déterminer quel objectif on cherche à approcher.
Dans les trois cas, le principe reste le même — transformer des jugements en signal d’optimisation —, mais l’unité évaluée, les personnes qui évaluent et les conséquences d’une erreur diffèrent. Pour décrire une application, il faut donc distinguer ce qui relève d’un exemple conceptuel de ce qui est documenté pour un système réel.
Le RLHF et les notions proches
Le réglage fin supervisé direct entraîne un modèle à partir de démonstrations : une entrée et une réponse de référence lui sont fournies, et le modèle apprend à produire une réponse similaire. Il n’est pas nécessaire d’apprendre une récompense à partir de comparaisons, ni d’optimiser ensuite la politique par apprentissage par renforcement. Le réglage supervisé peut constituer une première étape du RLHF, mais il ne désigne pas à lui seul l’ensemble de la procédure.
L’apprentissage par renforcement sans retour humain utilise une récompense définie autrement, par exemple un score automatique ou une condition vérifiable. Il s’agit bien d’apprentissage par renforcement, mais pas de RLHF si le signal ne provient pas de retours humains. Inversement, la présence d’une personne dans une tâche d’annotation ne suffit pas à démontrer qu’un modèle de récompense a été entraîné ou qu’un apprentissage par renforcement a été appliqué.
L’apprentissage en contexte se produit lorsqu’un modèle utilise les instructions et les exemples fournis dans la requête pour produire une réponse, sans que ses paramètres soient pour autant mis à jour par l’entraînement décrit ici. Cette méthode peut influencer le comportement observé au cours d’une conversation, mais elle ne constitue pas, à elle seule, du RLHF.
Ces méthodes ne sont pas toujours mutuellement exclusives. Un système peut utiliser des démonstrations supervisées avant la collecte de préférences, puis combiner plusieurs formes d’évaluation au cours de son développement. Des techniques d’optimisation directe des préférences, comme DPO, exploitent les données de préférence sans nécessairement suivre le cycle explicite qui consiste à entraîner séparément une récompense et à l’optimiser par un algorithme d’apprentissage par renforcement. La terminologie la plus précise dépend des composants réellement utilisés.
Repères pour distinguer les méthodes
La présence de retours humains ne suffit pas à identifier toutes les étapes de l’entraînement.
| Méthode | Signal principal | Ce que cela n’implique pas à lui seul |
|---|---|---|
| RLHF courant | Préférences humaines utilisées pour apprendre une récompense et orienter la politique | Ne garantit ni vérité, ni sécurité, ni consensus universel |
| Réglage supervisé direct | Démonstrations associant entrées et sorties souhaitées | N’exige ni modèle de récompense ni optimisation par apprentissage par renforcement |
| Apprentissage par renforcement sans retour humain | Récompense automatique, programmée ou vérifiable | Ne relève pas du RLHF si le signal ne provient pas de retours humains |
| Apprentissage en contexte | Instructions et exemples fournis dans la requête | N’implique pas la mise à jour des paramètres du modèle |
| Optimisation directe des préférences | Paires ou classements de préférences utilisés directement pour l’ajustement | N’exige pas nécessairement le cycle explicite récompense puis apprentissage par renforcement |
Ce que les préférences permettent — ou non — de conclure
Une comparaison humaine consigne un choix dans des conditions précises : qui a évalué, quelles options ont été présentées, quelles instructions ont été données et à quel moment. Elle peut aider à entraîner un système à reproduire des tendances de préférence présentes dans cet ensemble de données. Elle ne prouve pas que ce choix représente l’ensemble de la population ni qu’il reflète des valeurs stables dans d’autres contextes.
Le modèle de récompense est un substitut appris à partir des jugements qu’il a reçus. Il peut mal généraliser à des instructions ou à des réponses qui ne sont pas représentées dans ses données, confondre un indice superficiel avec la qualité recherchée ou produire des scores incohérents. Si la politique est fortement optimisée contre ce signal, elle peut trouver des réponses qui obtiennent un score élevé sans satisfaire l’objectif humain sous-jacent : ce risque est souvent appelé exploitation ou sur-optimisation de la récompense.
Les choix effectués tout au long du processus jouent également un rôle : formulation des critères, sélection des réponses candidates, profils des annotateurs, résolution des désaccords et répartition des instructions. Un manque de diversité peut laisser certaines préférences ou situations sous-représentées. Davantage d’optimisation ne corrige pas automatiquement ces lacunes : la qualité du signal et la couverture de l’évaluation restent déterminantes.
Pour ces raisons, le RLHF ne certifie pas, à lui seul, la sécurité ou la véracité. Un modèle peut sembler plus utile aux évaluateurs tout en continuant à commettre des erreurs factuelles. Les propriétés recherchées exigent des tests spécifiques, des évaluations en dehors des données d’entraînement, une analyse des défaillances et, dans les usages à risque, des mesures de protection opérationnelles et une supervision appropriée. La récompense doit être considérée comme un objectif d’entraînement, et non comme un certificat de comportement.
Erreurs fréquentes et critères pratiques
Une erreur fréquente consiste à dire que « les humains enseignent directement leurs valeurs au modèle ». Dans un processus courant, les personnes fournissent des jugements limités, puis un modèle de récompense apprend à les prédire. La politique est ensuite ajustée à partir de cette approximation. Le résultat dépend des critères définis, des personnes qui annotent les données et de la façon dont les différents composants sont entraînés et évalués.
Une autre erreur consiste à traiter les démonstrations, les comparaisons et les scores comme des signaux équivalents. Une démonstration fournit un exemple de réponse ; une comparaison indique laquelle de plusieurs options est préférée ; un score attribue une valeur selon une échelle. Ces signaux diffèrent et appellent des interprétations et des procédures d’entraînement distinctes. De même, il ne faut pas qualifier automatiquement de RLHF tout ajustement réalisé après le préentraînement si l’intervention de préférences humaines et le mécanisme utilisé n’ont pas été vérifiés.
Il est également préférable d’éviter d’affirmer que la méthode « aligne le modèle sur les valeurs humaines » sans préciser de quels jugements il s’agit et comment le résultat a été mesuré. Une formulation plus précise indique la tâche, la population d’évaluateurs, le type de retour et la portée de l’évaluation. Si l’on ne dispose que d’un exemple illustratif, il faut le présenter comme un scénario hypothétique, et non comme un résultat observé.
Pour examiner une affirmation sur le RLHF, posez-vous les questions suivantes : qu’est-ce qui a été évalué ? Par qui ? Quel signal a été produit ? Un modèle de récompense distinct a-t-il été entraîné ? Quel algorithme a modifié la politique ? Quelle évaluation indépendante étaye la conclusion ? Ces questions permettent de distinguer une description technique précise d’une affirmation générale sur l’alignement.
Cette fiche porte sur les méthodes d’apprentissage automatique, et plus particulièrement sur le processus courant appliqué aux modèles de langage. L’ouvrage technique de Nathan Lambert présente une analyse approfondie des méthodes et des étapes du RLHF, mais la page consultée présente le livre dans une version disponible sur arXiv. À elle seule, cette information ne permet pas d’affirmer que l’ouvrage a été évalué par les pairs. La documentation explicative d’AWS fournit une présentation complémentaire du processus, sans remplacer les articles primaires consacrés à chaque mise en œuvre.
Liste de vérification pour décrire un système
Ces questions aident à ne pas confondre une étape, un signal de données et une garantie de performance.
| Question | Éléments à préciser |
|---|---|
| Quels retours ont été recueillis ? | Comparaisons, classements, scores, corrections ou démonstrations |
| Qui a évalué ? | Population, expertise, consignes et procédure de traitement des désaccords |
| Comment les retours ont-ils été utilisés ? | Réglage supervisé, entraînement d’une récompense, optimisation directe ou autre méthode |
| Quelle affirmation souhaite-t-on faire ? | Préférence observée, qualité, sécurité, véracité ou autre résultat |
| Quelles preuves l’étayent ? | Évaluation spécifique, indépendante de l’entraînement et adaptée au contexte |