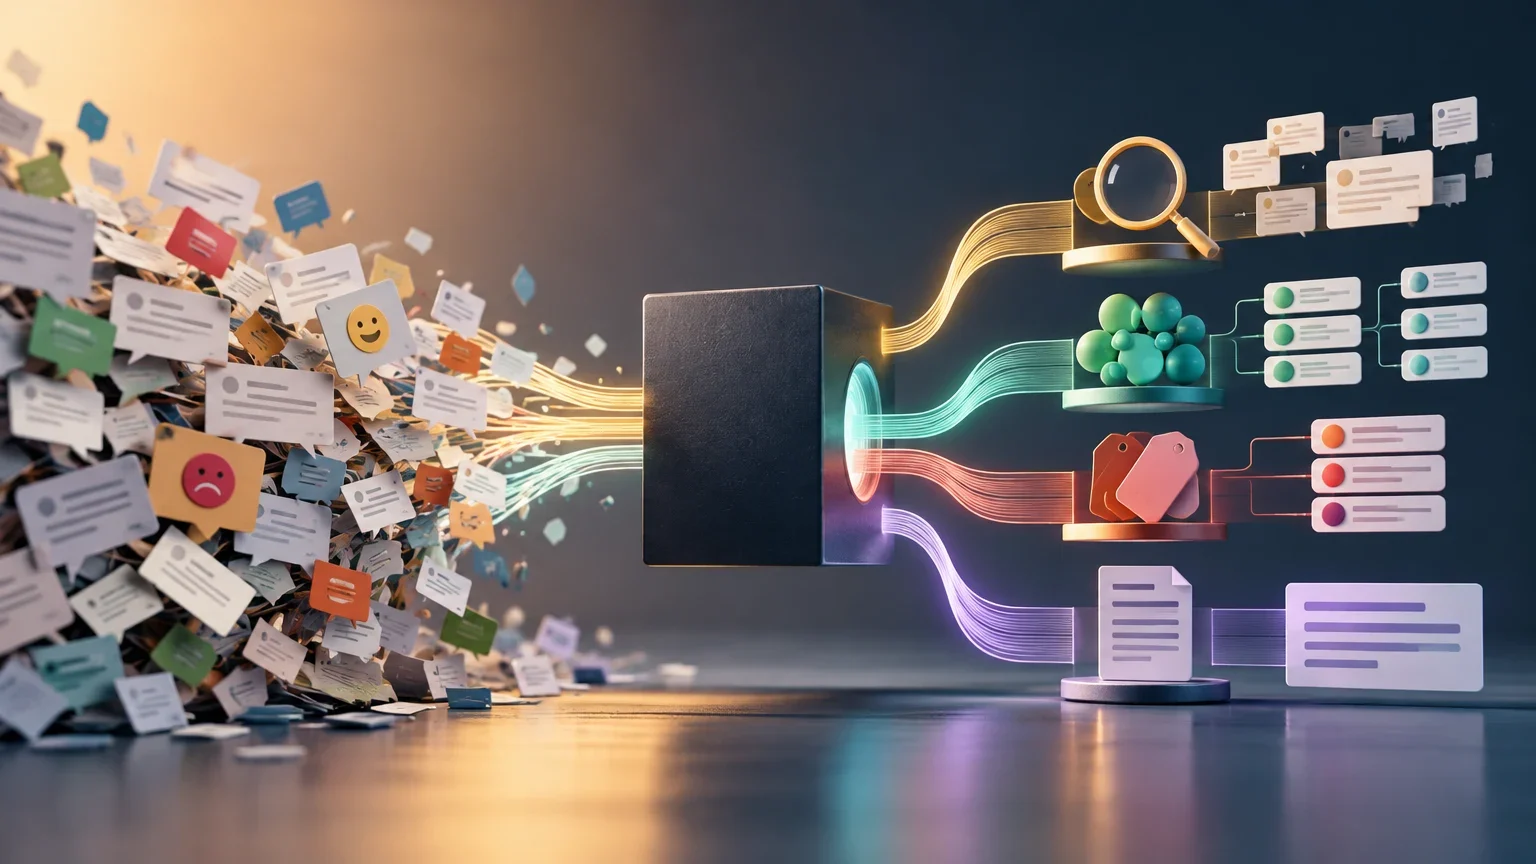
Definire il problema: quattro compiti distinti
Il primo passo per scegliere uno strumento di analisi del feedback è identificare cosa si deve fare con i dati. Non è la stessa cosa trovare un commento specifico, scoprire pattern nascosti o redigere un riassunto esecutivo. Confondere questi compiti porta a implementare soluzioni costose per problemi semplici o, al contrario, a usare metodi rudimentali per esigenze complesse.
Esistono quattro esigenze principali: localizzare commenti rilevanti tramite ricerca, raggruppare temi tramite scoperta esplorativa, misurare categorie note tramite classificazione supervisionata e redigere una sintesi tramite generazione assistita. Ciascuna richiede un approccio tecnico diverso e ha implicazioni differenti in termini di costo, precisione e manutenzione.
La distinzione tra questi quattro compiti non è puramente accademica, ma ha ripercussioni dirette sull'architettura del sistema. Ad esempio, la ricerca semantica, pur essendo un sottoinsieme delle capacità di embedding, non richiede necessariamente la costruzione di un modello predittivo complesso, limitandosi a calcolare la similarità vettoriale in tempo reale. Al contrario, la scoperta esplorativa implica un processo di apprendimento non supervisionato che può richiedere iterazioni multiple per stabilizzare i cluster, rendendo il ciclo di vita del progetto più lungo e meno prevedibile rispetto a una semplice query.
Inoltre, la generazione assistita si posiziona come un livello superiore di astrazione che spesso dipende dagli output dei compiti precedenti. Una sintesi efficace non può emergere dal nulla, ma necessita di un input strutturato, come una lista di commenti filtrati dalla ricerca o di temi aggregati dalla scoperta. Ignorare questa dipendenza gerarchica porta a sintetizzare dati grezzi non contestualizzati, aumentando il rischio di perdere sfumature critiche o di generare affermazioni generiche che non aggiungono valore decisionale per il team di prodotto o di supporto.
Differenze tra i quattro compiti di analisi
Tabella che confronta l'obiettivo, l'input tipico e l'output atteso di ciascun compito.
| Compito | Obiettivo principale | Input tipico | Output atteso |
|---|---|---|---|
| Ricerca | Localizzare commenti specifici | Query testuale o semantica | Elenco di commenti rilevanti |
| Scoperta | Identificare temi senza etichette pregresse | Corpus di testo non etichettato | Gruppi di commenti simili |
| Classificazione | Assegnare categorie note | Testo e tassonomia definita | Etichette per commento |
| Generazione | Redigere una sintesi | Corpus completo o filtrato | Testo narrativo riassuntivo |
Input e vincoli del corpus
Prima di confrontare le tecniche, è necessario auditare le caratteristiche del set di dati. I commenti dei clienti raramente sono omogenei: provengono da sondaggi, ticket di supporto, recensioni pubbliche e social media, ciascuno con il proprio formato, lunghezza e livello di struttura.
I fattori critici includono il volume totale dei commenti, la diversità delle lingue, la frequenza con cui arrivano nuovi dati e la presenza di informazioni personali. Un corpus piccolo e stabile può essere gestito con regole semplici, mentre un flusso continuo multilingue richiede modelli in grado di generalizzare e aggiornarsi con frequenza.
L'eterogeneità delle fonti di feedback introduce ulteriori sfide tecniche legate alla normalizzazione dei dati. I ticket di supporto, ad esempio, tendono a essere più strutturati e tecnici, spesso contenendo riferimenti a ID di transazione o dettagli specifici del prodotto, mentre le recensioni pubbliche sono più narrative e soggettive. Questa disparità di tono e contenuto significa che un modello addestrato esclusivamente su un tipo di testo potrebbe generalizzare male su un altro, producendo etichette incoerenti o mancando segnali rilevanti presenti solo in determinati canali.
La frequenza di aggiornamento dei dati è un altro fattore che condiziona la scelta dell'infrastruttura. Un corpus che cresce lentamente, come quello derivante da sondaggi trimestrali, può essere elaborato in batch con risorse computazionali meno intensive. Tuttavia, un flusso continuo proveniente dai social media richiede capacità di elaborazione in tempo quasi reale per catturare tendenze emergenti prima che si diffondano. In questo scenario, la latenza diventa un parametro critico, poiché un ritardo nell'identificazione di un problema ricorrente può tradursi in un aumento delle lamentele e in un danno reputazionale che un intervento tempestivo avrebbe potuto mitigare.
Confronto delle alternative tecniche
Per il compito di localizzazione, la ricerca letterale è sufficiente se le query sono esatte, ma la ricerca semantica consente di trovare commenti correlati concettualmente anche se non condividono parole chiave. Per la scoperta di temi, il clustering esplorativo identifica pattern senza bisogno di etichette pregresse, sebbene richieda interpretazione umana per nominare i gruppi.
La classificazione supervisionata è l'opzione più robusta quando si dispone di una tassonomia definita ed esempi etichettati. Consente di misurare la precisione e correggere gli errori in modo sistematico. La generazione assistita, d'altra parte, è utile per sintetizzare grandi volumi, ma deve essere usata con cautela per evitare allucinazioni o riassunti che non riflettano fedelmente le fonti.
La ricerca semantica offre un vantaggio significativo rispetto alla ricerca letterale quando il linguaggio dei clienti è impreciso o varia nel tempo. I clienti raramente usano la terminologia tecnica esatta per descrivere un problema; invece, utilizzano metafore, sinonimi o descrizioni vaghe. Un sistema basato su keyword fallirebbe in questi casi, mentre un approccio vettoriale è in grado di catturare l'intento sottostante, collegando commenti che condividono un significato concettuale anche se la superficie testuale è diversa. Questo è particolarmente utile per identificare problemi nuovi che non sono ancora stati catalogati nella tassonomia esistente.
Tuttavia, la ricerca semantica non è esente da limiti. La qualità degli embedding dipende dalla pre-addestrazione del modello e dalla sua capacità di comprendere il dominio specifico. In settori altamente specializzati, i termini tecnici potrebbero essere interpretati in modo errato se il modello non è stato fine-tuned su dati di dominio. Inoltre, la ricerca semantica può restituire risultati troppo ampi, includendo commenti che sono concettualmente vicini ma non rilevanti per l'analisi specifica. Pertanto, è spesso necessario combinare la ricerca semantica con filtri contestuali o regole di business per affinare i risultati e ridurre il rumore informativo.
Matrice decisionale per scegliere l'approccio
La scelta finale dipende dall'incrocio tra il risultato richiesto e le condizioni operative del team. Se non ci sono etichette pregresse e si devono scoprire temi, il clustering esplorativo è il punto di partenza. Se le categorie sono definite e ci sono esempi etichettati, la classificazione supervisionata offre maggiore controllo e tracciabilità.
Il budget, la latenza accettabile e la capacità di revisione umana sono fattori determinanti. Un sistema in tempo reale richiede un'infrastruttura più costosa rispetto a uno batch. Inoltre, la tolleranza all'errore varia in base all'uso: un errore nella classificazione di una segnalazione di sicurezza è più grave di un errore nella categorizzazione di un elogio.
La classificazione supervisionata, sebbene robusta, richiede un investimento iniziale significativo nella creazione di un dataset etichettato di alta qualità. Questo processo è laborioso e soggetto a bias umani, poiché gli annotatori possono interpretare le categorie in modo diverso, specialmente quando i confini tra le categorie sono sfumati. Per mitigare questo rischio, è fondamentale definire linee guida di annotazione chiare e condurre sessioni di calibrazione tra gli annotatori per garantire coerenza. Inoltre, la tassonomia deve essere progettata per essere evolutiva, permettendo l'aggiunta di nuove categorie man mano che emergono nuovi tipi di feedback, senza dover riaddestrare l'intero modello da zero.
La generazione assistita, d'altra parte, presenta sfide uniche legate alla verificabilità dell'output. A differenza della classificazione, dove l'output è una etichetta discreta che può essere confrontata con la verità a terra, la sintesi è un testo libero che richiede una valutazione qualitativa. È essenziale implementare meccanismi di verifica che consentano di tracciare ogni affermazione nella sintesi fino ai commenti originali che la supportano. Senza questa tracciabilità, la sintesi diventa una scatola nera, e gli utenti non possono fidarsi della sua accuratezza, specialmente in contesti in cui le decisioni basate su questi report hanno impatti significativi sulle operazioni aziendali.
Matrice decisionale semplificata
Guida rapida per selezionare la tecnica iniziale in base alla disponibilità di etichette e alla necessità di aggiornamento.
| Condizione | Approccio raccomandato | Considerazione chiave |
|---|---|---|
| Senza etichette pregresse | Clustering esplorativo | Richiede interpretazione umana dei cluster |
| Con etichette ed esempi | Classificazione supervisionata | Permette di misurare la precisione e correggere |
| Necessità di sintesi | Generazione assistita | Verificare la fedeltà alle fonti |
| Ricerca puntuale | Ricerca semantica | Costo inferiore rispetto a modelli complessi |
Errori rilevanti e verifiche operative
Gli errori più costosi non sono sempre i più visibili. Omettere un segnale critico, come una segnalazione di sicurezza, può avere conseguenze gravi. Assegnare una categoria errata può portare ad azioni inappropriate. Produrre una sintesi non supportata da commenti identificabili erode la fiducia nel sistema.
Prima di implementare, è essenziale verificare che ogni etichetta o affermazione della sintesi possa essere tracciata fino ai commenti sorgente. Deve esistere un processo di correzione quando una persona rileva un errore e un meccanismo di inoltro alla revisione umana per casi ambigui o ad alto impatto. La tracciabilità e la capacità di audit sono importanti quanto la precisione del modello.
La tracciabilità non è solo una questione di audit, ma anche di miglioramento continuo del sistema. Quando un errore viene identificato, la capacità di risalire rapidamente al commento sorgente e al contesto in cui è stato generato l'errore permette di diagnosticare la causa radice. Questo potrebbe essere un problema di etichettatura nel dataset di addestramento, una lacuna nella tassonomia o un limite del modello. Senza una tracciabilità granulare, il debug diventa un processo di prova ed errore, lento e costoso, che ritarda le correzioni e prolunga la finestra di esposizione agli errori.
Inoltre, il meccanismo di inoltro alla revisione umana deve essere integrato nel flusso di lavoro in modo trasparente. I casi ambigui o ad alto impatto non dovrebbero essere gestiti in modo silenzioso, ma dovrebbero essere segnalati in modo proattivo ai responsabili del processo. Questo non solo garantisce che le decisioni critiche siano prese da persone competenti, ma crea anche un ciclo di feedback che può essere utilizzato per aggiornare le regole di classificazione o per addestrare nuovi modelli. La combinazione di automazione e supervisione umana, supportata da una tracciabilità completa, crea un sistema resiliente che migliora nel tempo e mantiene la fiducia degli stakeholder.
Processo di validazione pre-implementazione
Passaggi per garantire che l'approccio scelto soddisfi le condizioni reali del team.
- 01Definire il compito principale: ricerca, scoperta, classificazione o generazione.
- 02Auditare il corpus: volume, lingue, struttura e dati personali.
- 03Verificare la disponibilità di etichette ed esempi rappresentativi.
- 04Valutare budget, latenza e capacità di revisione umana.
- 05Stabilire un meccanismo di tracciabilità e correzione degli errori.
Questioni aperte
- Non sono disponibili dati comparativi indipendenti su costi o prestazioni tra le tecniche per lo stesso corpus.
- L'efficacia dei modelli generativi per sintesi fedeli dipende dalla qualità delle istruzioni e dalla verifica umana, senza metriche standard universali.
- L'impatto della latenza sulla soddisfazione del cliente varia in base al settore e non è quantificato nelle fonti fornite.
Continua a esplorare
Fonti consultate
Correzioni e trasparenza
Se trovi un dato errato o non aggiornato, inviaci la pagina e la fonte da verificare.
Proponi una correzione