Definizione in una frase
Familia de métodos que usa preferencias humanas para entrenar señales de recompensa y orientar el comportamiento de un modelo.
Che cos’è l’RLHF
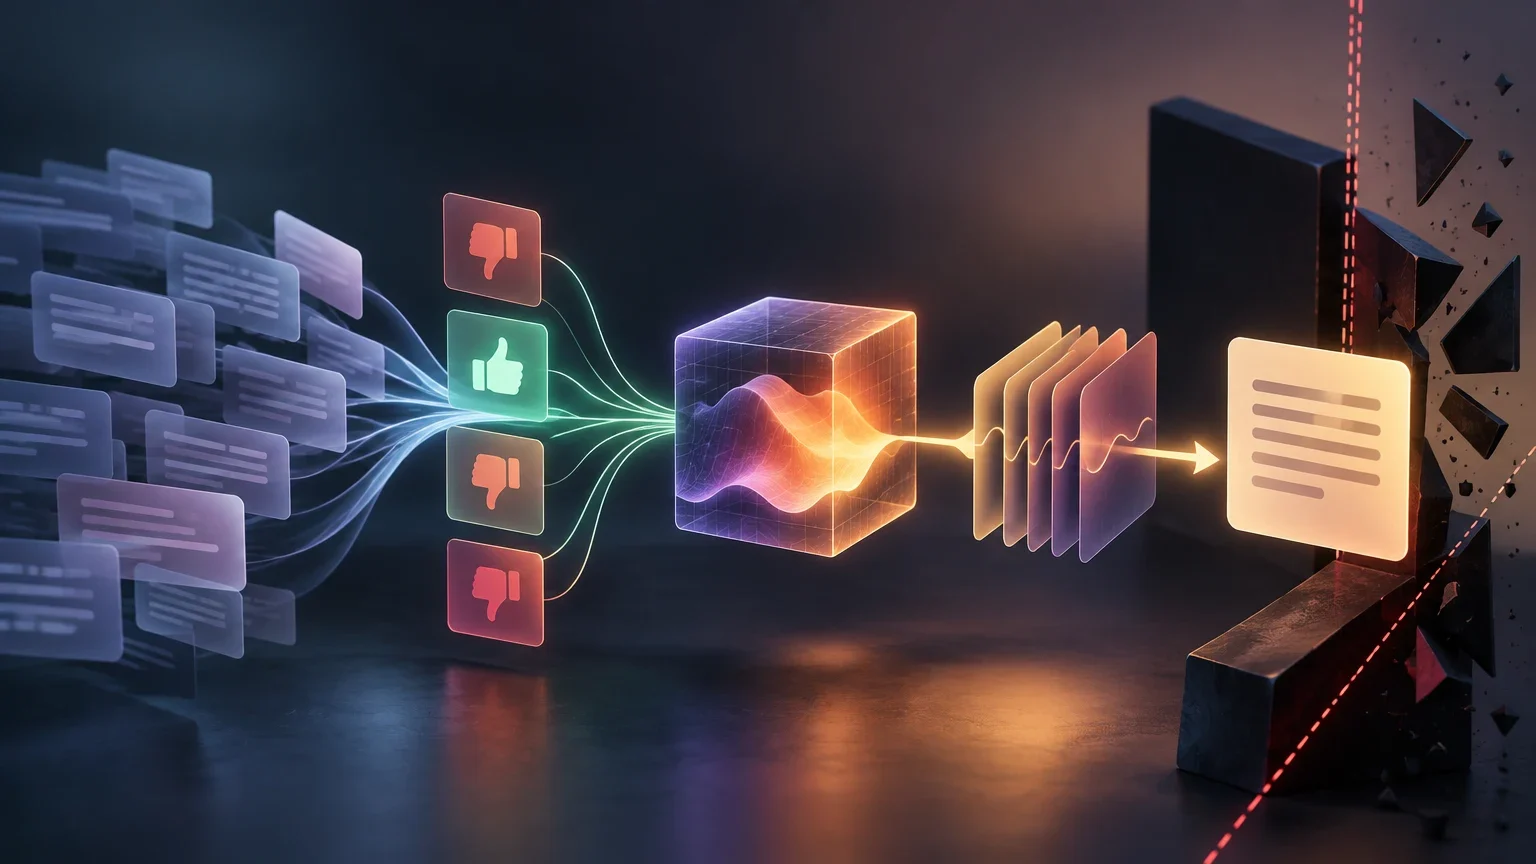
L’apprendimento per rinforzo da feedback umano — RLHF, dall’inglese Reinforcement Learning from Human Feedback — è una famiglia di metodi che usa valutazioni o preferenze umane per costruire un segnale di ricompensa e orientare l’ottimizzazione di un modello. In un’implementazione frequente, le persone confrontano diverse risposte possibili; tali confronti servono ad addestrare un modello di ricompensa, che in seguito assegna punteggi alle risposte generate dalla politica da ottimizzare.
L’approccio è utile quando è più facile giudicare quale fra due risultati sia preferibile che formulare una regola matematica completa per definire quello ideale. Una persona, per esempio, può valutare se una risposta sia chiara, pertinente o prudente. Il modello di ricompensa approssima quei giudizi sulla base dei dati disponibili: non trasforma da sé criteri soggettivi in una definizione universale di qualità.
RLHF non indica una ricetta unica e invariabile. Possono cambiare il tipo di feedback, il modo in cui viene raccolto, il modello usato per apprendere le preferenze e il metodo di ottimizzazione successivo. Nei modelli linguistici, una configurazione nota combina fine-tuning supervisionato, confronti umani, addestramento di una ricompensa e ottimizzazione tramite apprendimento per rinforzo. PPO è un possibile algoritmo per quest’ultima fase, non un requisito di tutte le tecniche basate sulle preferenze umane.
Per definire correttamente il metodo, occorre distinguere il segnale umano dalla procedura che lo elabora. La preferenza osservata è un dato, il modello di ricompensa è un’approssimazione appresa e la politica ottimizzata è il sistema che si vuole modificare. Confondere questi elementi porta a sopravvalutare ciò che il metodo dimostra: migliorare un punteggio appreso non prova, di per sé, che il modello sia veritiero, sicuro o rappresentativo delle preferenze di tutte le persone.
Il flusso tecnico: dai dati alla politica
In un flusso frequente per i modelli linguistici, il processo parte da una politica iniziale capace di generare risposte. La politica può derivare da un modello preaddestrato e può essere sottoposta prima a fine-tuning supervisionato, durante il quale impara a imitare risposte dimostrative. Dimostrazioni e preferenze hanno funzioni diverse: le prime mostrano esempi di comportamento, le seconde permettono di confrontare le risposte candidate.
Il sistema genera quindi diverse risposte alla stessa istruzione. Gli annotatori umani le confrontano o le classificano secondo criteri definiti per il progetto. Un confronto a coppie può indicare che, per una determinata domanda, la risposta A è preferibile alla B. Si tratta di un giudizio riferito a un contesto specifico, che non necessariamente ne esplicita tutte le ragioni né rappresenta l’accordo di tutti i valutatori.
I confronti vengono usati per addestrare un modello di ricompensa. Nel caso comune delle preferenze a coppie, il modello impara ad assegnare punteggi in modo che la risposta scelta tenda a ottenere un punteggio superiore a quella scartata. Successivamente, la politica genera nuove risposte e viene ottimizzata per ottenere punteggi elevati secondo la ricompensa appresa. Algoritmi come PPO possono aggiornare la politica; in alcune configurazioni si limita anche la distanza da un modello di riferimento.
Ogni fase produce artefatti diversi: dimostrazioni per il fine-tuning supervisionato, coppie o classifiche annotate, un modello di ricompensa e una politica ottimizzata. Tenerli distinti facilita la verifica dei segnali introdotti nel sistema e delle trasformazioni applicate. Se si salta una fase — per esempio, usando direttamente dimostrazioni per l’addestramento — non si dovrebbe descrivere automaticamente il processo come il flusso classico di RLHF con un modello di ricompensa esplicito.
Questo schema è un riferimento, non una specifica universale. Esistono configurazioni con altre forme di feedback o metodi di ottimizzazione diversi. Alcuni approcci di ottimizzazione delle preferenze, inoltre, evitano di addestrare una ricompensa separata e di applicarla poi in un ciclo convenzionale di apprendimento per rinforzo. Perciò conviene indicare il metodo concreto, anziché presumere che ogni tecnica di allineamento basata sulle preferenze segua gli stessi passaggi.
Fasi tipiche e relativi risultati
La sequenza seguente riassume una configurazione frequente per un modello linguistico; i dettagli cambiano da un’implementazione all’altra.
- 01Preparare una politica iniziale e, se opportuno, affinarla con dimostrazioni supervisionate.
- 02Generare diverse risposte per le istruzioni selezionate.
- 03Raccogliere confronti, classifiche o altre valutazioni umane secondo criteri definiti.
- 04Addestrare un modello di ricompensa che approssimi le preferenze osservate.
- 05Ottimizzare la politica usando tale ricompensa, con un algoritmo di apprendimento per rinforzo se lo richiede il progetto.
- 06Valutare separatamente il modello ottenuto: la ricompensa usata nell’addestramento non sostituisce una valutazione indipendente.
Esempi applicativi
In un assistente conversazionale, ai valutatori si possono mostrare due risposte alla stessa domanda. Potrebbero preferire quella che risponde direttamente, distingue i fatti dalle incertezze ed evita contenuti irrilevanti. I confronti servono ad apprendere una ricompensa orientata a questi criteri e, in seguito, a ottimizzare la politica. L’esempio illustra il meccanismo, ma non afferma che uno specifico assistente sia stato addestrato in questo modo.
Nella moderazione dei contenuti, i valutatori potrebbero confrontare le decisioni del sistema sullo stesso brano: consentire la pubblicazione, rimuoverlo o sottoporlo a revisione. Il feedback può riflettere regole e priorità definite per uno specifico contesto. Prima di usarlo per ottimizzare una politica, occorre precisare quale danno si intende ridurre, quali sono i costi dei falsi positivi e dei falsi negativi e quali procedure di ricorso sono disponibili. La preferenza di un gruppo di annotatori, da sola, non costituisce una norma sociale universale.
In un sistema di raccomandazione, una persona può preferire un risultato a un altro in una situazione precisa: per esempio, un’opzione pertinente a una ricerca specifica invece di una popolare ma poco adatta alla richiesta. Il confronto potrebbe alimentare un modello di ricompensa che ordina i risultati. Tuttavia, un clic o una scelta osservata non esprimono sempre soddisfazione: possono dipendere dalla posizione nella pagina, dall’interfaccia o da informazioni incomplete. Prima di tradurre quel comportamento in feedback, bisogna chiarire quale obiettivo si vuole approssimare.
Nei tre casi, il principio è lo stesso — usare giudizi per costruire un segnale di ottimizzazione — ma cambiano l’unità valutata, le persone che esprimono il giudizio e le conseguenze degli errori. Per descrivere un’applicazione è quindi necessario distinguere un esempio concettuale da ciò che è documentato per un sistema reale.
RLHF e concetti affini
Il fine-tuning supervisionato diretto addestra un modello con dimostrazioni: viene fornita un’input e una risposta di riferimento, e il modello impara a produrre una risposta simile. Questo non richiede necessariamente di apprendere una ricompensa dai confronti né di ottimizzare poi la politica tramite apprendimento per rinforzo. Può costituire una fase iniziale del flusso RLHF, ma non è sinonimo dell’intero procedimento.
L’apprendimento per rinforzo senza feedback umano usa una ricompensa definita in altro modo, per esempio tramite un punteggio automatico o una condizione verificabile. È comunque apprendimento per rinforzo, ma non diventa RLHF solo perché il sistema ottimizza una ricompensa. Al contrario, la presenza di una persona nell’annotazione non basta a dimostrare che sia stato addestrato un modello di ricompensa o che sia stato applicato l’apprendimento per rinforzo.
L’apprendimento in contesto si verifica quando un modello usa istruzioni ed esempi presentati durante la richiesta per produrre una risposta, senza che per questo i suoi parametri vengano aggiornati con il processo di addestramento descritto. Può influire sul comportamento osservato nella conversazione, ma non è, da solo, RLHF.
Questi metodi non sono sempre alternative che si escludono a vicenda. Un sistema può usare dimostrazioni supervisionate prima di raccogliere preferenze e combinare più forme di valutazione durante il suo sviluppo. Tecniche di ottimizzazione diretta delle preferenze come DPO usano dati sulle preferenze senza seguire necessariamente il ciclo esplicito di addestramento di una ricompensa separata e di successiva ottimizzazione tramite un algoritmo di RL. L’etichetta più precisa dipende dai componenti effettivamente utilizzati.
Come distinguere i metodi
La presenza di feedback umano non basta a identificare tutte le fasi dell’addestramento.
| Metodo | Segnale principale | Cosa non implica, di per sé |
|---|---|---|
| RLHF tipico | Preferenze umane usate per apprendere una ricompensa e orientare la politica | Non garantisce veridicità, sicurezza o consenso universale |
| Fine-tuning supervisionato diretto | Dimostrazioni di input e output desiderati | Non richiede un modello di ricompensa né ottimizzazione tramite RL |
| Apprendimento per rinforzo senza feedback umano | Ricompensa automatica, programmata o verificabile | Non è RLHF se il segnale non deriva da feedback umano |
| Apprendimento in contesto | Istruzioni ed esempi forniti nella richiesta | Non implica l’aggiornamento dei parametri del modello |
| Ottimizzazione diretta delle preferenze | Coppie o classifiche di preferenze usate direttamente nell’affinamento | Non richiede necessariamente il ciclo esplicito ricompensa più RL |
Cosa permette di concludere una preferenza e cosa no
Un confronto umano registra una scelta in condizioni specifiche: chi ha valutato, quali alternative ha visto, con quali istruzioni e in quale momento. Può aiutare ad addestrare un sistema a imitare le preferenze di quel gruppo, ma non dimostra che la scelta rappresenti l’intera popolazione o rifletta valori stabili in contesti diversi.
Il modello di ricompensa è un sostituto appreso dei giudizi ricevuti. Può generalizzare male a istruzioni o risposte che non rientrano nei dati osservati, confondere un segnale superficiale con la qualità desiderata o assegnare punteggi incoerenti. Se la politica viene ottimizzata intensamente rispetto a quel segnale, può trovare risultati che ottengono un punteggio elevato senza raggiungere l’obiettivo umano sottostante. Questo rischio è spesso chiamato sfruttamento o sovraottimizzazione della ricompensa.
Influiscono anche le scelte fatte durante il processo: come sono formulati i criteri, quali alternative vengono generate, quali profili di annotatori partecipano, come si risolvono i disaccordi e quale distribuzione di istruzioni viene usata. Una scarsa varietà può lasciare preferenze o situazioni poco rappresentate. Una maggiore ottimizzazione non corregge automaticamente il problema: la qualità del segnale e la copertura della valutazione restano determinanti.
Per questi motivi, RLHF non certifica da solo sicurezza o veridicità. Un modello può sembrare più utile ai valutatori e continuare a commettere errori fattuali. Le proprietà desiderate richiedono test specifici, valutazioni al di fuori dei dati di addestramento, analisi dei malfunzionamenti e, negli usi ad alto rischio, adeguate misure operative e supervisione. La ricompensa va intesa come un obiettivo di addestramento, non come un certificato del comportamento del sistema.
Errori frequenti e criteri pratici
Un errore frequente è dire che «gli esseri umani insegnano direttamente i valori al modello». In un flusso tipico, le persone forniscono giudizi circoscritti e un modello di ricompensa impara a prevederli. La politica viene poi ottimizzata rispetto a questa approssimazione. Il risultato dipende da come sono stati definiti i criteri, da chi ha annotato i dati e da come sono stati addestrati e valutati i componenti.
Un altro errore è considerare equivalenti dimostrazioni, confronti e punteggi. Una dimostrazione fornisce un esempio di output; un confronto indica quale tra più opzioni è preferita; un punteggio assegna una valutazione secondo una scala. Sono segnali diversi e richiedono interpretazioni e procedure di addestramento differenti. Inoltre, non si dovrebbe chiamare RLHF qualsiasi affinamento successivo al preaddestramento senza aver verificato l’uso di preferenze umane e il meccanismo adottato.
È opportuno evitare anche affermazioni come «il metodo allinea il modello ai valori umani» senza specificare di chi siano i giudizi e come sia stato misurato il risultato. Una formulazione più precisa indica il compito, la popolazione dei valutatori, il tipo di feedback e i limiti della valutazione. Se si tratta soltanto di un esempio illustrativo, va presentato come scenario ipotetico, non come risultato osservato.
Per esaminare un’affermazione sull’RLHF, chiediti: che cosa è stato valutato? Chi lo ha valutato? Quale segnale è stato prodotto? È stato addestrato un modello di ricompensa separato? Quale algoritmo ha modificato la politica? Quale valutazione indipendente sostiene la conclusione? Queste domande aiutano a distinguere una descrizione tecnica concreta da un’affermazione generale sull’allineamento.
Questa scheda si concentra sui metodi di apprendimento automatico e, in particolare, sul flusso tipico applicato ai modelli linguistici. Il testo tecnico di Nathan Lambert offre un’esposizione ampia dei metodi e delle fasi dell’RLHF, ma la pagina consultata presenta il libro in una versione su arXiv: sulla sola base delle informazioni disponibili non è possibile affermare che sia stato sottoposto a revisione paritaria. La documentazione esplicativa di AWS integra la descrizione del flusso, ma non sostituisce gli articoli primari relativi alle singole implementazioni.
Lista di controllo prima di descrivere un sistema
Usa queste domande per non confondere una fase, un segnale nei dati e una garanzia di prestazione.
| Domanda | Che cosa chiarire |
|---|---|
| Quale feedback è stato raccolto? | Confronti, classifiche, punteggi, correzioni o dimostrazioni |
| Chi ha valutato? | Popolazione, competenze, istruzioni e procedura per gestire i disaccordi |
| Come è stato usato? | Fine-tuning supervisionato, addestramento di una ricompensa, ottimizzazione diretta o altro |
| Quale affermazione si vuole sostenere? | Preferenza osservata, qualità, sicurezza, veridicità o altro risultato |
| Quali prove la sostengono? | Valutazioni specifiche, esterne all’addestramento e adeguate al contesto |