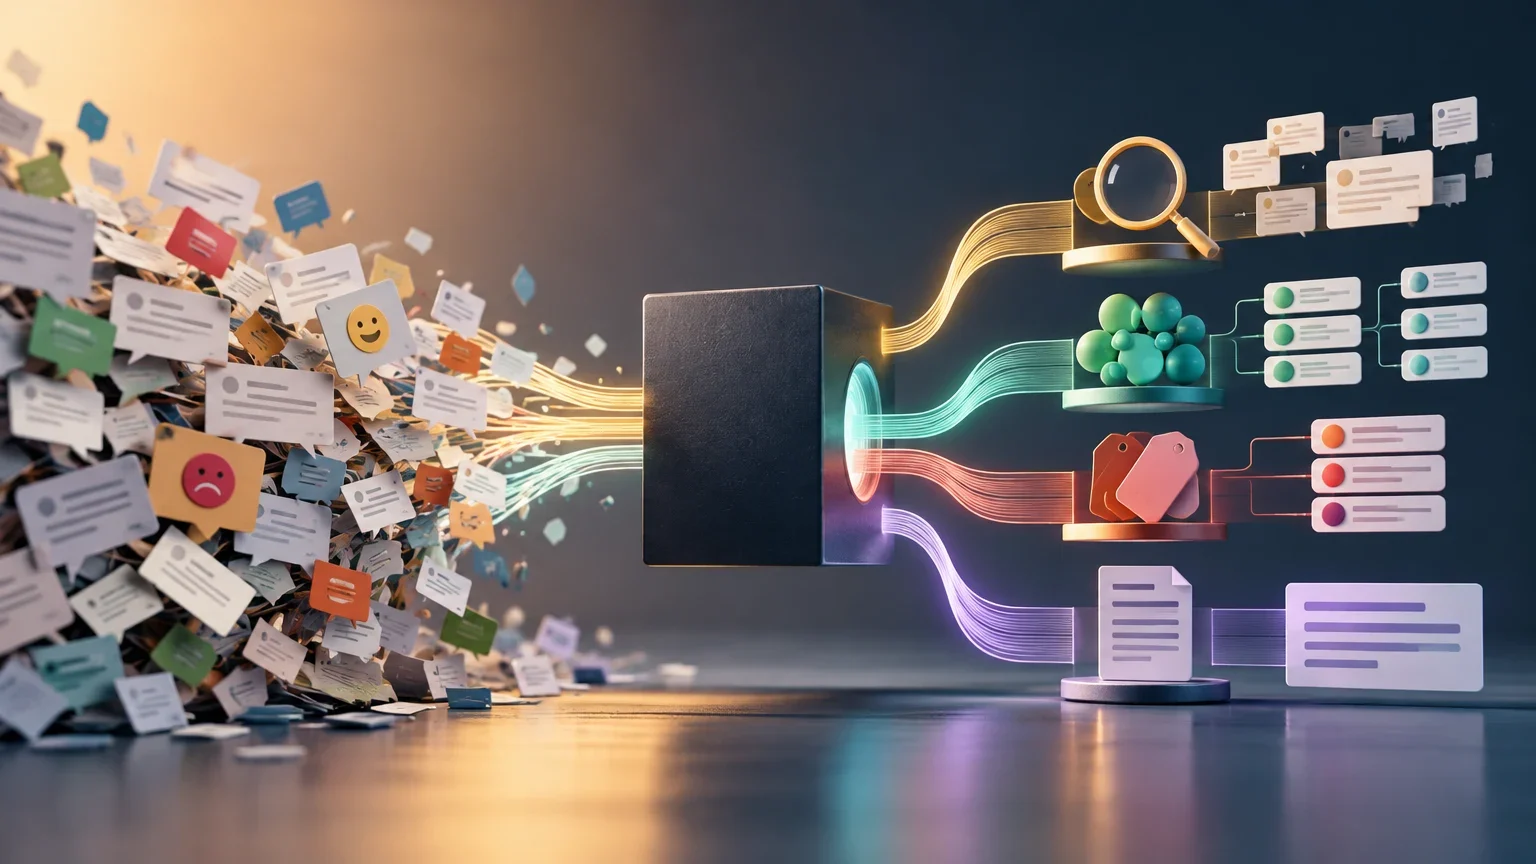
Delimitar o problema: quatro tarefas distintas
O primeiro passo para escolher uma ferramenta de análise de feedback é identificar o que precisa ser feito com os dados. Não é a mesma coisa encontrar um comentário específico do que descobrir padrões ocultos ou redigir um resumo executivo. Confundir essas tarefas leva a implementar soluções caras para problemas simples ou, ao contrário, a usar métodos rudimentares para necessidades complexas.
Existem quatro necessidades principais: localizar comentários relevantes por meio de busca, agrupar temas por meio de descoberta exploratória, medir categorias conhecidas por meio de classificação supervisionada e redigir uma síntese por meio de geração assistida. Cada uma requer uma abordagem técnica diferente e tem implicações distintas em termos de custo, precisão e manutenção.
A distinção entre essas quatro tarefas não é apenas teórica, mas operacional, pois cada uma impõe requisitos específicos de infraestrutura e competência técnica. A busca, por exemplo, prioriza a velocidade de resposta e a relevância lexical ou semântica, enquanto a descoberta exploratória exige ciclos iterativos de análise onde o resultado inicial é sempre um rascunho sujeito a refinamento humano. A classificação, por sua vez, demanda um esforço contínuo de manutenção da taxonomia, pois o vocabulário dos clientes evolui e novas categorias podem emergir, tornando o sistema estático rapidamente obsoleto. Já a geração assistida coloca o foco na qualidade narrativa e na coesão lógica do texto final, o que requer mecanismos robustos de verificação de fatos para garantir que a síntese não invente detalhes ausentes no corpus original.
Confundir essas fronteiras leva a ineficiências significativas. Utilizar um modelo de geração para uma tarefa de busca simples resulta em custos computacionais desnecessários e latência elevada, sem ganho proporcional em utilidade. Da mesma forma, aplicar regras rígidas de classificação a um corpus onde os temas ainda não estão definidos força o modelo a encaixar dados em categorias inadequadas, gerando ruído analítico. A clareza na definição da tarefa primária permite dimensionar corretamente o investimento em recursos de computação e tempo de equipe, evitando a sobrecarga de sistemas complexos para necessidades que poderiam ser resolvidas com abordagens mais simples e transparentes.
Diferenças entre as quatro tarefas de análise
Tabela que contrasta o objetivo, a entrada típica e a saída esperada de cada tarefa.
| Tarefa | Objetivo principal | Entrada típica | Saída esperada |
|---|---|---|---|
| Busca | Localizar comentários específicos | Consulta textual ou semântica | Lista de comentários relevantes |
| Descoberta | Identificar temas sem rótulos prévios | Corpus de texto não rotulado | Grupos de comentários semelhantes |
| Classificação | Atribuir categorias conhecidas | Texto e taxonomia definida | Rótulos por comentário |
| Geração | Redigir uma síntese | Corpus completo ou filtrado | Texto narrativo resumo |
Entradas e restrições do corpus
Antes de comparar técnicas, é necessário auditar as características do conjunto de dados. Os comentários de clientes raramente são homogêneos: provêm de pesquisas, tickets de suporte, avaliações públicas e redes sociais, cada um com seu próprio formato, comprimento e nível de estrutura.
Fatores críticos incluem o volume total de comentários, a diversidade de idiomas, a frequência com que novos dados chegam e a presença de informações pessoais. Um corpus pequeno e estável pode ser gerenciado com regras simples, enquanto um fluxo contínuo multilíngue exige modelos capazes de generalizar e se atualizar com frequência.
A heterogeneidade das fontes de dados impõe desafios técnicos específicos que vão além do simples volume de texto. Comentários de pesquisas estruturadas tendem a ser mais longos e reflexivos, enquanto avaliações públicas em lojas de aplicativos são frequentemente curtas, emocionais e repletas de gírias ou abreviações. Tickets de suporte, por outro lado, contêm contexto técnico detalhado e histórico de interações, o que exige que o modelo de análise seja capaz de distinguir entre a queixa inicial e as tentativas de resolução anteriores. Ignorar essas diferenças de formato e intenção leva a interpretações distorcidas, onde o tom de uma avaliação pública pode ser erroneamente atribuído a um ticket técnico ou vice-versa.
A presença de dados pessoais adiciona uma camada de complexidade regulatória e técnica que deve ser tratada antes de qualquer processamento analítico. A anonimização não é apenas uma etapa de limpeza, mas um requisito de design que influencia a escolha das ferramentas. Alguns modelos de linguagem avançados podem reidentificar indivíduos com base em padrões sutis de escrita ou detalhes específicos, mesmo após a remoção de nomes e e-mails. Portanto, a estratégia de minimização de dados deve ser integrada ao pipeline desde o início, garantindo que as features extraídas para análise não contenham identificadores diretos ou indiretos que violem a privacidade dos clientes, alinhando a eficiência analítica com a conformidade legal.
Comparação de alternativas técnicas
Para a tarefa de localização, a busca literal é suficiente se as consultas forem exatas, mas a busca semântica permite encontrar comentários relacionados conceitualmente, mesmo que não compartilhem palavras-chave. Para a descoberta de temas, o agrupamento exploratório (clustering) identifica padrões sem a necessidade de rótulos prévios, embora exija interpretação humana para nomear os grupos.
A classificação supervisionada é a opção mais robusta quando se dispõe de uma taxonomia definida e exemplos rotulados. Permite medir a precisão e corrigir erros de forma sistemática. A geração assistida, por sua vez, é útil para sintetizar grandes volumes, mas deve ser usada com cautela para evitar alucinações ou resumos que não reflitam fielmente as fontes.
A busca semântica representa um avanço significativo em relação à busca literal, pois permite capturar a intenção por trás das palavras, mesmo quando a terminologia exata não é utilizada. Isso é particularmente útil em cenários onde os clientes descrevem o mesmo problema de maneiras diferentes, utilizando sinônimos ou metáforas. No entanto, essa flexibilidade vem com o risco de retornar resultados que são conceptualmente próximos, mas factualmente irrelevantes para a necessidade específica de triagem. Por isso, a calibração dos limiares de similaridade é crucial para equilibrar a recall (capacidade de encontrar todos os itens relevantes) e a precisão (capacidade de excluir itens irrelevantes), evitando sobrecarregar a equipe de suporte com falsos positivos.
O agrupamento exploratório, embora poderoso para descobrir padrões ocultos, produz resultados que são inerentemente instáveis e dependentes dos parâmetros do algoritmo. Pequenas variações no corpus ou nos hiperparâmetros podem levar a uma reorganização significativa dos clusters, dificultando a comparação temporal dos resultados. A interpretação humana é, portanto, um componente não opcional, mas essencial, para validar a coerência dos grupos identificados. Sem essa validação, há o risco de atribuir significados errados a agrupamentos estatísticos que não correspondem a temas reais de negócio, levando a decisões estratégicas baseadas em artefatos matemáticos em vez de insights genuínos sobre a experiência do cliente.
Matriz de decisão para escolher a abordagem
A escolha final depende de cruzar o resultado requerido com as condições operacionais da equipe. Se não houver rótulos prévios e for necessário descobrir temas, o agrupamento exploratório é o ponto de partida. Se as categorias estiverem definidas e houver exemplos rotulados, a classificação supervisionada oferece maior controle e rastreabilidade.
O orçamento, a latência aceitável e a capacidade de revisão humana são fatores determinantes. Um sistema em tempo real exige infraestrutura mais cara do que um por lotes. Além disso, a tolerância ao erro varia conforme o uso: um erro na classificação de uma reclamação de segurança é mais grave do que um erro na categorização de um elogio.
A classificação supervisionada oferece a vantagem de permitir a quantificação objetiva do desempenho do sistema através de métricas como precisão, recall e F1-score. Isso cria um ciclo de feedback claro onde os erros podem ser identificados, analisados e corrigidos de forma sistemática. No entanto, essa robustez depende criticamente da qualidade e representatividade dos dados de treino. Se a taxonomia inicial for mal definida ou se os exemplos rotulados não capturarem a diversidade do vocabulário dos clientes, o modelo aprenderá padrões limitados e falhará em generalizar para novos tipos de feedback. A manutenção contínua da taxonomia e a reetiquetagem periódica de exemplos são, portanto, atividades operacionais essenciais para manter a relevância do sistema ao longo do tempo.
A geração assistida, ao sintetizar grandes volumes de dados, transforma dados brutos em narrativas acionáveis, facilitando a comunicação de insights para stakeholders que não possuem expertise técnica. Contudo, a natureza probabilística dos modelos generativos introduz o risco de alucinação, onde o sistema pode inventar detalhes ou distorcer o tom original dos comentários. Para mitigar esse risco, é fundamental implementar mecanismos de verificação que rastreiem cada afirmação na síntese de volta aos comentários de origem. Essa rastreabilidade não apenas aumenta a confiança no resultado final, mas também permite a auditoria e a correção de erros, garantindo que a narrativa gerada seja uma representação fiel e verificável da realidade expressa pelos clientes.
Matriz de decisão simplificada
Guia rápido para selecionar a técnica inicial conforme a disponibilidade de rótulos e a necessidade de atualização.
| Condição | Abordagem recomendada | Consideração-chave |
|---|---|---|
| Sem rótulos prévios | Agrupamento exploratório | Exige interpretação humana dos clusters |
| Com rótulos e exemplos | Classificação supervisionada | Permite medir precisão e corrigir |
| Necessidade de síntese | Geração assistida | Verificar fidelidade às fontes |
| Busca pontual | Busca semântica | Menor custo que modelos complexos |
Erros relevantes e verificações operativas
Os erros mais custosos nem sempre são os mais visíveis. Omitir um sinal crítico, como uma reclamação de segurança, pode ter consequências graves. Atribuir uma categoria incorreta pode levar a ações inadequadas. Produzir uma síntese que não esteja respaldada por comentários identificáveis erosiona a confiança no sistema.
Antes de implementar, é essencial verificar que cada rótulo ou afirmação da síntese possa ser rastreado até os comentários de origem. Deve existir um processo de correção quando uma pessoa detecta um erro e um mecanismo de encaminhamento para revisão humana para casos ambíguos ou de alto impacto. A rastreabilidade e a capacidade de auditoria são tão importantes quanto a precisão do modelo.
A tolerância ao erro não é uniforme em todas as tarefas de análise de feedback. Em contextos de alta criticidade, como a detecção de falhas de segurança ou problemas de conformidade regulatória, o custo de um falso negativo (não detectar um problema real) é significativamente maior do que o de um falso positivo (detectar um problema inexistente). Isso exige que a configuração do sistema priorize a sensibilidade, mesmo que isso resulte em um maior volume de alertas que precisam ser revisados manualmente. Por outro lado, em tarefas de categorização de elogios ou sugestões de melhoria, a tolerância ao erro pode ser maior, permitindo otimizações que priorizem a velocidade e a automação em detrimento de uma precisão absoluta.
A implementação de mecanismos de correção e revisão humana não deve ser vista como uma falha do sistema, mas como um componente integral do design. A capacidade de um operador humano de corrigir um rótulo incorreto e de fornecer esse feedback ao modelo para aprendizado contínuo é o que diferencia um sistema estático de um ecossistema de análise adaptativo. Além disso, a documentação clara dos critérios de decisão e dos processos de escalonamento para casos ambíguos garante a transparência e a auditabilidade, elementos essenciais para manter a confiança interna na ferramenta e para responder a questionamentos sobre a origem e a validade dos insights gerados.
Processo de validação prévia à implementação
Passos para garantir que a abordagem escolhida atenda às condições reais da equipe.
- 01Definir a tarefa principal: busca, descoberta, classificação ou geração.
- 02Auditar o corpus: volume, idiomas, estrutura e dados pessoais.
- 03Verificar disponibilidade de rótulos e exemplos representativos.
- 04Avaliar orçamento, latência e capacidade de revisão humana.
- 05Estabelecer mecanismo de rastreabilidade e correção de erros.
Questões em aberto
- Não se dispõe de dados comparativos independentes de custo ou desempenho entre as técnicas para um mesmo corpus.
- A eficácia dos modelos generativos para síntese fiel depende da qualidade das instruções e da verificação humana, sem métricas padrão universais.
- O impacto da latência na satisfação do cliente varia conforme o setor e não é quantificado nas fontes fornecidas.
Continue a explorar
Fontes consultadas
Correções e transparência
Se encontrar informação incorreta ou desatualizada, envie-nos a página e a fonte que devemos rever.
Propor uma correção