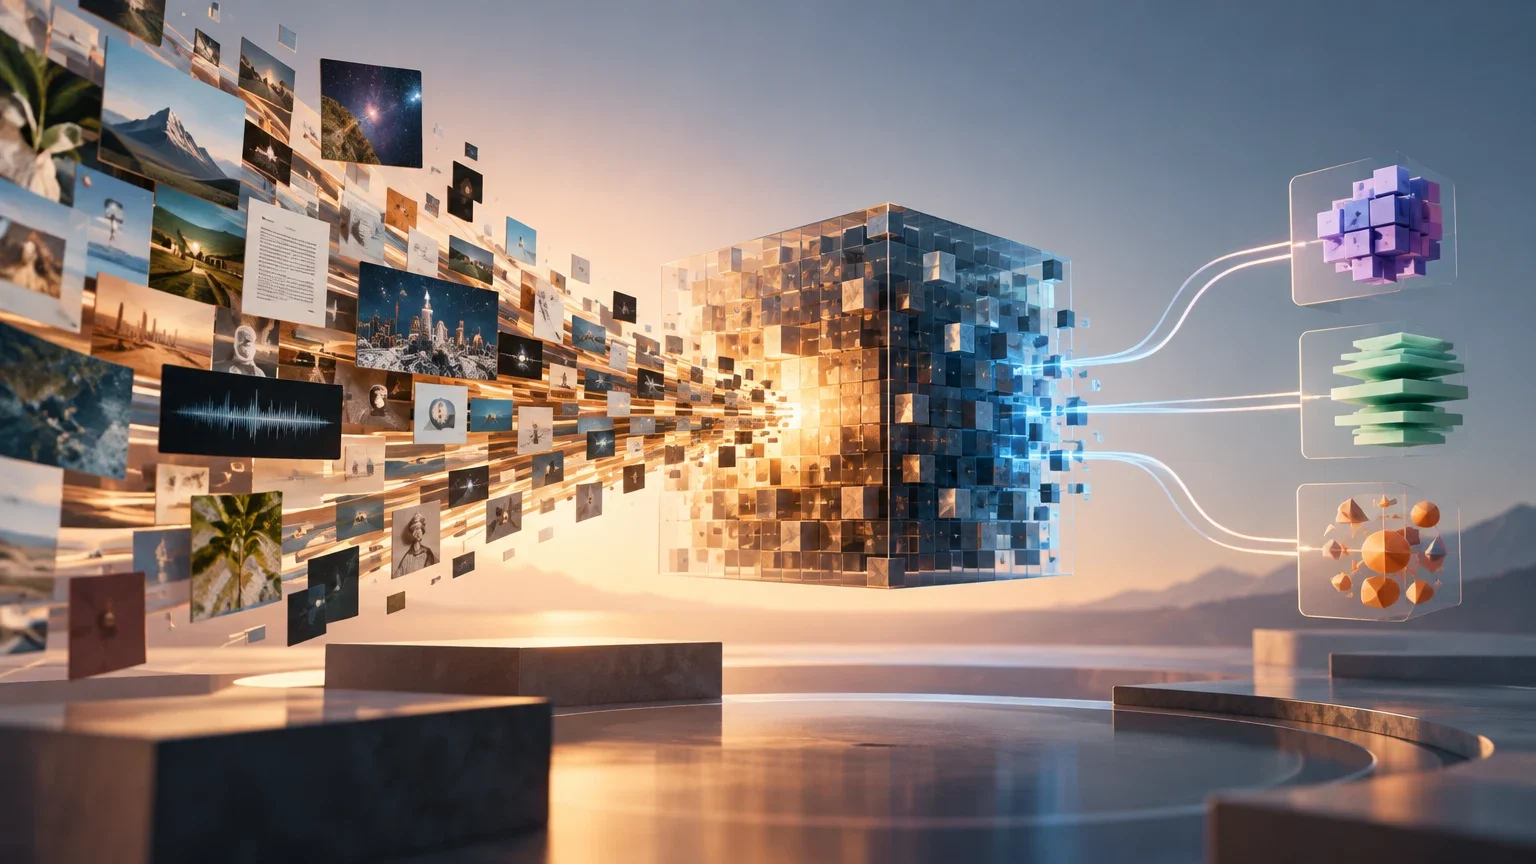
Definição numa frase
Fase inicial de entrenamiento a gran escala que aprende patrones generales antes de ajustes o usos especializados.
Definição: o que significa pré-treinar
O pré-treinamento é uma etapa de treinamento na qual um modelo é ajustado antes de ser usado em determinadas tarefas ou adaptado para um uso posterior. A palavra “prévio” descreve sua posição em relação a uma etapa ou finalidade subsequente; não significa que esse seja sempre o primeiro treinamento recebido pelo sistema, nem que exista uma única sequência obrigatória para todos os modelos.
O glossário do Instituto Nacional de Padrões e Tecnologia dos Estados Unidos (NIST) define o pré-treinamento, em aprendizado de máquina, como uma etapa de treinamento de um modelo de uso geral com dados disponíveis publicamente; acrescenta que, às vezes, esse modelo é chamado de modelo fundacional. É uma definição concisa e útil, mas não descreve todas as variantes possíveis nem estabelece que todo pré-treinamento use dados públicos. Também não permite concluir que “modelo fundacional” e “pré-treinamento” sejam sinônimos: um termo pode designar o modelo, e o outro, uma fase de seu treinamento.
Em termos simples, um sistema recebe dados e é treinado de acordo com um objetivo determinado. O resultado pode ser um modelo reutilizado, adaptado ou avaliado em uma tarefa. Os dados, o objetivo, a arquitetura e a forma de reutilização variam entre projetos. Por isso, dizer que um modelo é “pré-treinado” informa algo sobre seu histórico de treinamento, mas não basta para saber o que ele aprendeu, com quais dados, com que qualidade ou para quais situações serve.
Esquema geral: dados, objetivo e reutilização
Uma maneira prática de entender essa fase é separar quatro perguntas. Primeiro: que dados são apresentados ao modelo? Segundo: que objetivo de aprendizagem orienta o treinamento? Terceiro: que mudança se pretende obter no modelo? E, por fim: o que será feito com esse resultado? Responder a essas perguntas ajuda a evitar tratar “pré-treinamento” como se fosse o nome de um algoritmo específico.
Em alguns sistemas, o objetivo pode se basear em prever ou reconstruir partes dos dados; em outros, pode-se aprender uma representação que depois será aproveitada de outra forma. Essas são possibilidades gerais, não uma lista completa nem a afirmação de que todos os pré-treinamentos funcionem assim. O trabalho sobre pré-treinamento generativo não supervisionado de linguagem, por exemplo, apresenta uma estratégia específica para esse domínio; seu título e sua descrição não justificam transformá-la na definição de toda a área.
O resultado pode servir de ponto de partida para uma adaptação posterior, uma avaliação ou outras etapas de treinamento. Também pode haver pré-treinamento contínuo ou multimodal: um guia da NeurIPS trata expressamente do pré-treinamento multimodal contínuo. Isso traz uma nuance ao esquema didático de “uma fase inicial e, depois, um ajuste fino”: trata-se de uma possibilidade, não de uma cronologia obrigatória.
O processo simplificado a seguir é um mapa conceitual. Ele não especifica hiperparâmetros, tamanhos de conjuntos de dados nem uma sequência técnica aplicável a todos os modelos.
Mapa conceitual, não receita
A sequência representa decisões que costumam ser descritas quando se fala em pré-treinamento. Em um sistema real, algumas delas podem se repetir, mudar de ordem ou nem sequer ocorrer.
- 01Definir a família de dados e a capacidade que se deseja aprender ou aprimorar.
- 02Escolher um objetivo de treinamento adequado à arquitetura e ao uso previsto.
- 03Treinar o modelo e avaliar o resultado; a duração do treinamento ou a quantidade de dados, por si sós, não demonstram qualidade.
- 04Decidir se o modelo será reutilizado, adaptado em outra etapa ou empregado em uma avaliação ou aplicação específica.
Três exemplos para entender o termo
Os exemplos a seguir são cenários explicativos: ajudam a entender como a descrição muda conforme a modalidade, mas não pretendem documentar um conjunto de dados específico nem atribuir uma receita a determinado projeto. As evidências fornecidas para esta ficha respaldam um exemplo de linguagem e a existência de pesquisas sobre pré-treinamento clínico e multimodal; não trazem detalhes suficientes para reconstruir os procedimentos de cada caso.
Pré-treinamento, modelo fundacional e ajuste fino
Pré-treinamento designa uma fase ou um processo de treinamento. Modelo fundacional costuma se referir a um modelo de uso geral que pode servir de base para usos posteriores. O NIST observa que, às vezes, um modelo de uso geral treinado em uma etapa de pré-treinamento recebe o nome de modelo fundacional; o “às vezes” é importante: a formulação não estabelece uma equivalência absoluta entre os dois termos.
O ajuste fino, ou *fine-tuning*, é uma forma de adaptação posterior do modelo por meio de treinamento adicional. Uma sequência frequente consiste em partir de um modelo pré-treinado e continuar seu treinamento para direcioná-lo a uma tarefa ou contexto mais específico. No entanto, nem todo modelo pré-treinado precisa passar por ajuste fino, e nem todo processo posterior deve necessariamente ser descrito com esse nome. A fonte secundária da Lenovo apresenta o pré-treinamento como treinamento com dados amplos e menciona a adaptação posterior, mas essa explicação não basta para estabelecer uma definição técnica universal.
Aprendizado autossupervisionado também não é sinônimo de pré-treinamento. “Pré-treinamento” indica a posição ou a função de uma fase; “autossupervisionado” caracteriza uma família de métodos que constroem sinais de aprendizagem a partir dos próprios dados, em vez de depender necessariamente de rótulos preparados para cada exemplo. Um sistema pode ser descrito pelos dois termos quando isso for pertinente, mas um não decorre automaticamente do outro. O exemplo de linguagem generativa não supervisionada documenta uma abordagem específica, não uma regra válida para todas as modalidades.
Inferência é o uso de um modelo já treinado para obter uma saída a partir de uma entrada, por exemplo, gerar uma resposta ou produzir uma previsão. Não equivale a treinar: durante a inferência, o objetivo imediato é usar o modelo, não atualizá-lo por meio de uma nova etapa de aprendizagem. Na prática, um produto pode combinar inferência com ferramentas, recuperação de informações ou outros componentes; portanto, observar uma resposta, por si só, não revela como o modelo foi pré-treinado.
Como distinguir conceitos próximos
A tabela resume a diferença funcional entre os termos. Um sistema específico pode combinar várias etapas; para classificá-lo corretamente, é necessário consultar sua documentação técnica.
| Termo | O que descreve | Pergunta útil |
|---|---|---|
| Pré-treinamento | Uma fase de treinamento anterior a uma finalidade ou adaptação posterior. | Que objetivo e que dados foram utilizados nessa fase? |
| Modelo fundacional | Um modelo de uso geral que pode servir de base; o termo, por si só, não designa uma receita. | Que capacidades e usos são documentados pelas avaliações? |
| Ajuste fino | Treinamento adicional para adaptar um modelo a uma tarefa ou contexto. | O que mudou durante a adaptação e com que evidências foi avaliado? |
| Aprendizado autossupervisionado | Uma maneira de obter sinais de aprendizagem a partir dos dados; não é, por definição, uma etapa cronológica. | De onde vêm os sinais que orientam a aprendizagem? |
| Inferência | Uso do modelo para produzir uma saída a partir de uma entrada, sem que isso signifique que ele esteja sendo treinado. | Que entrada recebeu e quais componentes participaram da saída? |
O que o pré-treinamento não permite concluir
O fato de um modelo ser pré-treinado não garante que ele responda corretamente, seja seguro, funcione em qualquer idioma ou modalidade, nem que seja adequado a um contexto específico. “Pré-treinado” descreve um histórico ou uma etapa de desenvolvimento; não é um selo de qualidade. A utilidade precisa ser avaliada com testes pertinentes ao uso previsto e com informações sobre o comportamento do modelo.
Também não é possível inferir a qualidade apenas pelo tamanho do conjunto de dados, pela duração do treinamento ou pelo fato de os dados serem públicos. A definição do NIST menciona dados disponíveis publicamente, mas isso não demonstra que toda etapa use esse tipo de dado nem que a disponibilidade garanta representatividade, autorização de uso, ausência de erros ou bom desempenho. Essas questões exigem evidências específicas sobre os dados e o sistema.
A construção do conjunto de dados pode influenciar os resultados. Um artigo da Association for Computational Linguistics sobre a construção de conjuntos de dados para pré-treinamento aborda, entre outros temas, deduplicação e filtragem. Isso justifica considerar a preparação dos dados uma questão relevante, mas não permite afirmar que exista uma receita universal de filtragem ou deduplicação capaz de garantir resultados melhores em todos os projetos.
Também é prudente evitar a afirmação de que o pré-treinamento produz automaticamente competência geral. O artigo da JMLR sobre o papel do pré-treinamento investiga justamente a função que ele desempenha na aprendizagem contínua. A existência desse trabalho na literatura é motivo para não transformar uma intuição em garantia: capacidades e limitações devem ser estabelecidas com evidências relativas ao modelo e à tarefa em questão.
Erros frequentes e critérios práticos
Um erro frequente é chamar de “pré-treinamento” qualquer aprendizagem anterior sem esclarecer em relação a que etapa ela é prévia. Outro é supor que todos os modelos seguem o mesmo percurso: treinamento inicial, ajuste fino e uso. A pesquisa sobre pré-treinamento multimodal contínuo mostra que também são estudados processos que não se encaixam sem ressalvas nesse esquema linear.
Escala e qualidade também são confundidas: um conjunto grande não comprova, por si só, que os dados sejam adequados ou que o modelo generalize. Da mesma forma, um objetivo de treinamento não deve ser confundido com uma garantia de capacidade. Afirmações sobre resultados devem ser sustentadas por avaliações, não deduzidas apenas do nome da técnica.
Ao ler a ficha de um modelo ou comparar modelos-base, vale verificar o que “pré-treinado” significa naquele caso específico. Procure informações sobre a modalidade e o tipo de dados descritos; o objetivo de aprendizagem; se a etapa é única ou contínua; quais adaptações posteriores foram realizadas; e que avaliações sustentam as capacidades anunciadas. Se essas informações não estiverem disponíveis, a conclusão responsável é que não se pode determinar o procedimento com base apenas no rótulo.
Em resumo, o pré-treinamento pode criar uma base reutilizável, mas sua função específica depende do projeto e das evidências disponíveis. Distinguir fase, objetivo, modelo e uso posterior evita atribuir ao termo mais informações do que ele realmente oferece.
Fontes e escopo desta ficha
A definição introdutória se baseia no glossário do NIST. Para contextualizar a construção de dados, considera-se o trabalho acadêmico da Association for Computational Linguistics; para o exemplo de linguagem, o artigo de Radford e colaboradores; e, para discutir limites e variantes, os trabalhos da JMLR e da NeurIPS incluídos entre as fontes verificadas. O artigo sobre pré-treinamento com relevância clínica sustenta que há pesquisa biomédica nessa área, mas as informações fornecidas para esta ficha não bastam para detalhar seu procedimento.
Por esse motivo, o exemplo de visão é apresentado expressamente como ilustração conceitual, não como um caso documentado. Também não são atribuídos aos artigos resultados, conjuntos de dados ou mecanismos que não estejam respaldados pelas informações verificadas disponíveis. Esse cuidado é especialmente importante ao comparar modelos: uma fonte sobre uma técnica específica não demonstra que ela seja universal.