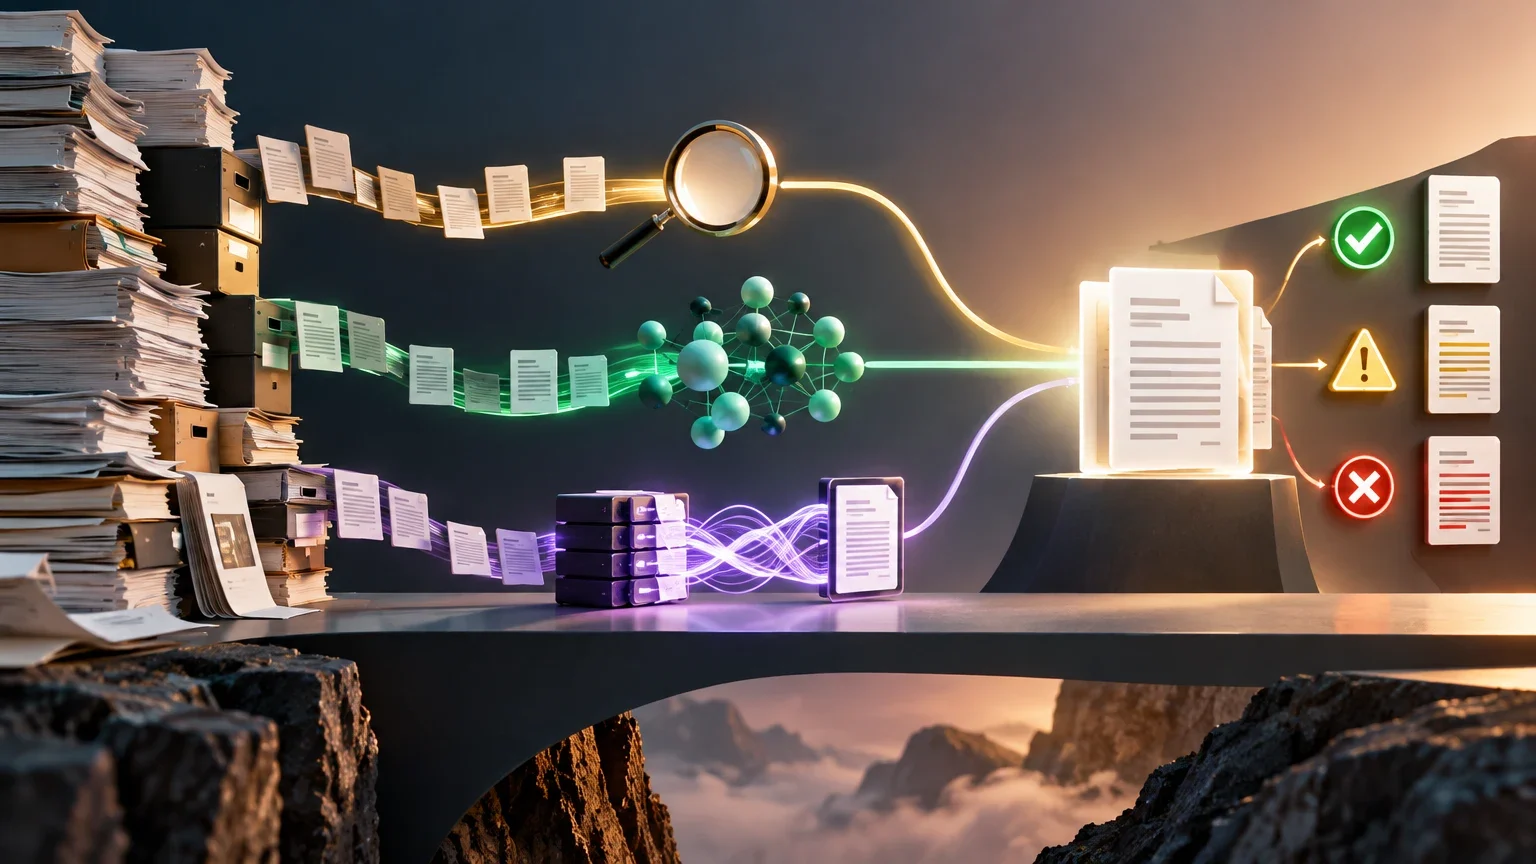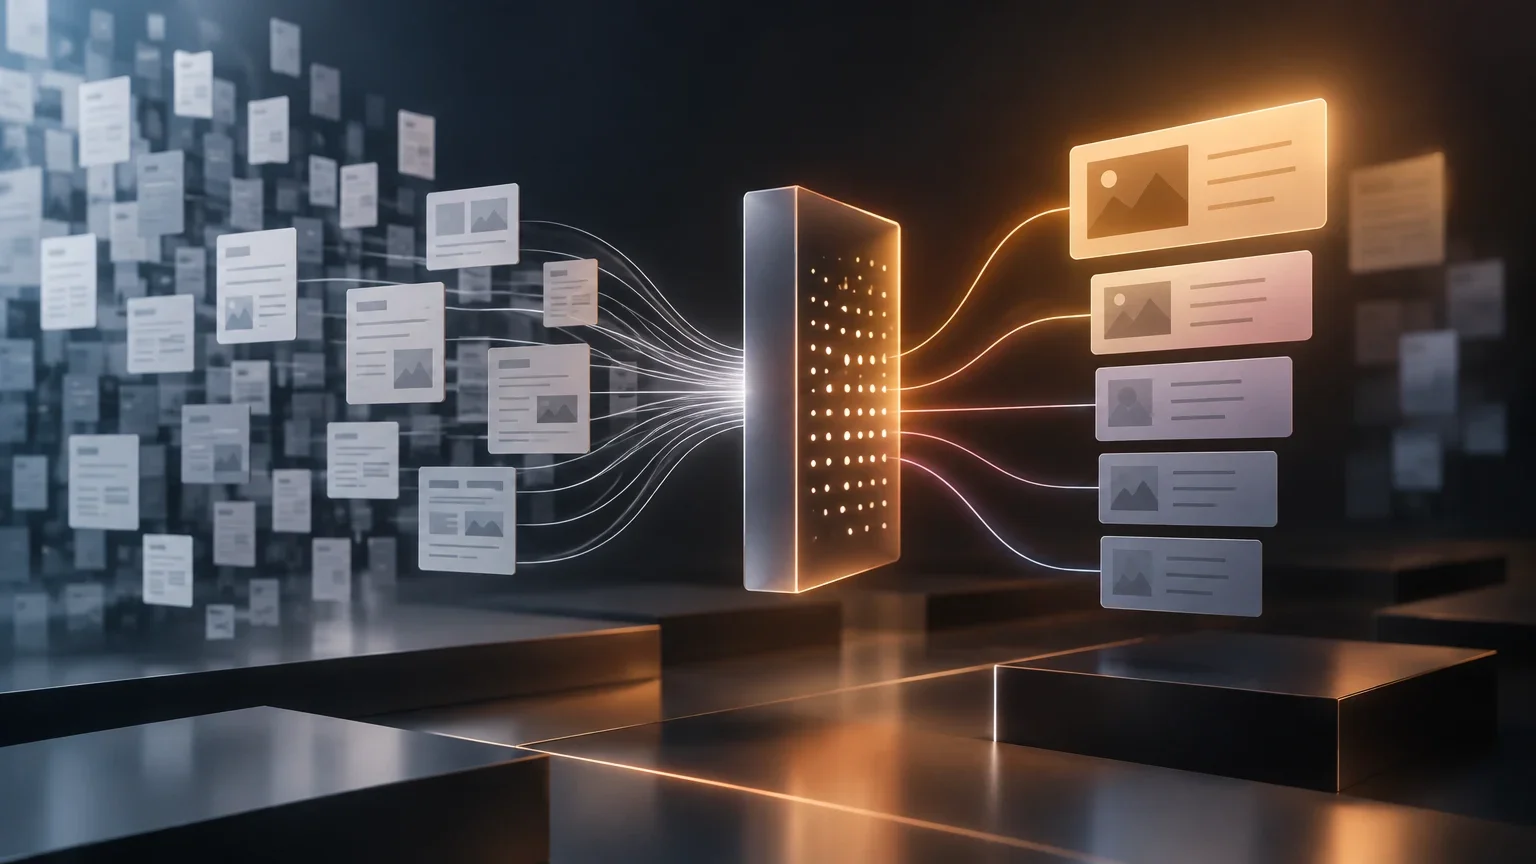
Definição numa frase
Segunda etapa que vuelve a puntuar candidatos recuperados para colocar primero los más relevantes para la consulta.
Definição precisa: Reranking como segunda etapa de pontuação
O reranking, ou reordenação de resultados, é uma técnica de recuperação de informação que atua como uma segunda etapa de filtragem e pontuação. Diferente da busca inicial, que busca capturar a maior quantidade possível de documentos relevantes (alto recall), o reranking se concentra em refinar essa lista para garantir que os documentos mais pertinentes apareçam nas primeiras posições (alta precisão).
Em sistemas de Geração Aumentada por Recuperação (RAG), esta etapa é crítica porque o grande modelo de linguagem (LLM) só pode processar uma quantidade limitada de contexto. Se a recuperação inicial retornar documentos irrelevantes ou ruidosos, a qualidade da resposta gerativa se degrada. O reranking intervém avaliando a relação semântica profunda entre a consulta específica do usuário e cada documento candidato, reordenando a lista para que o LLM receba apenas a informação mais valiosa.
A separação entre as duas etapas reflete um compromisso arquitetural entre cobertura e profundidade. A primeira etapa opera em um espaço vetorial de alta dimensionalidade, onde a distância geométrica serve como proxy para a relevância, mas não captura nuances contextuais. O reranking, por sua vez, atua como um filtro semântico que interpreta a intenção da consulta em relação ao conteúdo específico de cada documento, corrigindo falhas de correspondência superficial que a similaridade vetorial não consegue resolver.
Em pipelines de RAG, essa distinção é vital para gerenciar a janela de contexto do LLM. Como o modelo de linguagem possui uma capacidade finita de tokens, a inclusão de documentos irrelevantes não apenas desperdiça recursos computacionais, mas também introduz ruído que pode levar a alucinações ou respostas imprecisas. O reranking atua como um mecanismo de curadoria, garantindo que apenas os fragmentos de informação com maior densidade de relevância sejam injetados no prompt, otimizando assim a relação entre o custo de inferência e a qualidade da resposta final.
Funcionamento técnico: Bi-encoders vs. Cross-encoders
A distinção fundamental no reranking reside em como a consulta e o documento são processados. Os modelos da primeira etapa costumam ser bi-encoders (ou modelos de embeddings), que transformam a consulta e os documentos em vetores independentes. Isso permite pré-calcular os vetores dos documentos e realizar comparações rápidas por meio de similaridade cosseno, mas implica uma perda de informação ao comprimir o significado em um único vetor.
Os rerankers costumam ser cross-encoders. Esses modelos processam a consulta e o documento simultaneamente como uma única entrada de texto. Isso permite ao modelo capturar interações finas entre as palavras da consulta e as do documento, alcançando uma pontuação de relevância muito mais precisa. O custo é computacional: os resultados não podem ser pré-calculados, portanto, o modelo deve ser executado em tempo real para cada par (consulta, documento), o que introduz latência.
A perda de informação inerente aos bi-encoders ocorre porque a compressão de um texto inteiro em um único vetor força a média das características semânticas, diluindo detalhes específicos que podem ser cruciais para consultas precisas. Em contraste, o cross-encoder mantém a granularidade token a token, permitindo que o modelo de atenção identifique correspondências exatas ou contradições sutis entre a pergunta e o documento. Essa capacidade de interação direta é o que confere ao reranking sua superioridade em precisão, embora exija um custo computacional proporcional ao número de pares analisados.
A impossibilidade de pré-calcular as pontuações dos cross-encoders impõe uma restrição de arquitetura: o modelo deve ser executado em tempo real para cada nova consulta. Isso significa que, diferentemente dos embeddings de documentos que podem ser indexados uma única vez, o reranking exige inferência dinâmica a cada requisição. Essa característica torna o processo mais caro em termos de latência, mas essencial para cenários onde a precisão da resposta é mais crítica do que a velocidade de resposta, especialmente em aplicações de alto valor ou com requisitos rigorosos de acurácia.
Comparativo de arquiteturas de pontuação
Resumo das diferenças operacionais entre a recuperação inicial e a reordenação.
| Característica | Bi-encoder (Etapa 1) | Cross-encoder (Etapa 2 / Reranking) |
|---|---|---|
| Processamento | Vetores independentes | Par (consulta + documento) |
| Pré-calculável | Sim (embeddings de documentos) | Não (depende da consulta) |
| Velocidade | Muito rápida (milissegundos) | Lenta (requer inferência por par) |
| Precisão | Média (perda de contexto) | Alta (interação direta de tokens) |
Exemplos aplicados em diferentes domínios
Na documentação técnica corporativa, o reranking resolve ambiguidades de termos. Por exemplo, se uma consulta busca 'feature scaling' em machine learning, a busca vetorial pode retornar documentos sobre 'feature scaling' em edição de imagens ou design de produto. Um cross-encoder lê o contexto completo e descarta os documentos irrelevantes, elevando ao topo os textos que explicam a normalização de variáveis em algoritmos como SVM ou k-means.
Na recuperação de código, o reranking ajuda a selecionar snippets específicos. Ao buscar uma função de autenticação, a recuperação inicial pode trazer centenas de arquivos. O reranking identifica quais fragmentos de código contêm a lógica exata solicitada, filtrando definições de variáveis ou comentários genéricos que não agregam valor à geração de código pelo LLM.
A capacidade do reranking de desambiguar termos técnicos é particularmente valiosa em domínios onde a mesma terminologia possui significados distintos dependendo do contexto. Ao processar a consulta e o documento juntos, o cross-encoder consegue inferir a intenção subjacente do usuário, distinguindo, por exemplo, entre o escalonamento de variáveis numéricas em estatística e o redimensionamento de imagens em processamento gráfico. Essa discriminação fina evita que o LLM seja exposto a informações que, embora lexicalmente semelhantes, são semanticamente irrelevantes para a tarefa específica.
No contexto de recuperação de código, a seleção de snippets específicos é crucial para a geração de código funcional. A recuperação inicial pode retornar arquivos inteiros ou módulos grandes que contêm a lógica desejada, mas também incluem dependências, comentários e código auxiliar que não são necessários. O reranking identifica os fragmentos exatos que contêm a implementação solicitada, filtrando o ruído estrutural. Isso permite que o LLM foque na lógica central, reduzindo o risco de erros de sintaxe ou lógica na geração do código final e melhorando a eficiência do processo de desenvolvimento assistido.
Confusões frequentes e conceitos próximos
Um erro comum é confundir o reranking com o scoring de similaridade cosseno. A similaridade cosseno é a métrica utilizada na primeira etapa para comparar vetores pré-calculados. O reranking é um processo posterior que utiliza um modelo de linguagem (geralmente um transformer) para atribuir uma pontuação de relevância binária ou probabilística a cada par. Não são a mesma coisa: um é uma comparação geométrica rápida, o outro é uma inferência semântica profunda.
Outra confusão é assumir que recuperar mais documentos sempre melhora a resposta. Devido à limitação da janela de contexto dos LLMs e ao fenômeno de 'perda no meio' (lost in the middle), saturar o contexto com documentos irrelevantes pode degradar o desempenho do modelo. O reranking permite recuperar muitos documentos (alto recall), mas enviar apenas os melhores (alta precisão) ao LLM.
A distinção entre a métrica de similaridade cosseno e o scoring do reranking é fundamental para entender a arquitetura de sistemas de busca híbridos. A similaridade cosseno é uma operação algébrica rápida que mede o ângulo entre vetores, adequada para triagem inicial em grandes bases de dados. O reranking, por outro lado, é uma inferência de modelo de linguagem que avalia a relevância contextual, capturando nuances que a geometria vetorial não consegue expressar. Confluir esses dois conceitos leva a erros de design, como a tentativa de usar um cross-encoder para indexação em massa, o que é computacionalmente inviável.
O fenômeno de 'perda no meio' (lost in the middle) destaca a importância de não apenas recuperar documentos relevantes, mas também de posicioná-los corretamente no contexto do LLM. Modelos de linguagem tendem a prestar mais atenção ao início e ao fim do prompt, negligenciando informações no meio. O reranking não apenas filtra documentos irrelevantes, mas também reordena os relevantes para maximizar a probabilidade de que o LLM os processe adequadamente. Essa otimização da ordem dos documentos é tão importante quanto a seleção dos documentos em si, pois impacta diretamente a capacidade do modelo de integrar a informação recuperada na resposta gerada.
Limites operacionais: Latência e escalabilidade
O principal limite do reranking é a latência. Como o cross-encoder deve processar cada documento candidato individualmente, o tempo de resposta cresce linearmente com o número de candidatos. Processar milhões de documentos com um reranker é inviável; por isso, essa técnica só é aplicada a um subconjunto pequeno (top-k) dos resultados da primeira etapa.
Em grandes escalas, o custo computacional pode ser significativo. Se for utilizado um modelo de reranking hospedado na nuvem, cada consulta gera um custo adicional por token processado. Os arquitetos devem equilibrar o número de candidatos a reordenar (por exemplo, recuperar 50 e reordenar para 5) para manter a latência dentro dos limites aceitáveis para a aplicação, especialmente em sistemas em tempo real.
A escalabilidade do reranking é limitada pela natureza sequencial do processamento dos pares consulta-documento. Como cada par requer uma inferência completa do modelo, o tempo total de processamento é a soma dos tempos de inferência individuais. Isso torna o reranking impraticável para conjuntos de candidatos muito grandes, limitando sua aplicação a um subconjunto reduzido dos resultados da primeira etapa. A escolha do tamanho do top-k é, portanto, um parâmetro crítico que deve ser ajustado com base no trade-off entre a precisão desejada e a latência aceitável para a aplicação.
Em ambientes de nuvem, o custo do reranking é diretamente proporcional ao número de tokens processados, o que pode se tornar significativo em sistemas de alta escala. Cada consulta que passa pelo reranker gera um custo adicional, que deve ser considerado no orçamento total de inferência. Os arquitetos devem monitorar a relação entre o ganho de precisão e o custo computacional, ajustando o número de candidatos a reordenar para manter a eficiência econômica do sistema. Em sistemas em tempo real, onde a latência é um requisito estrito, o reranking pode ser aplicado seletivamente, apenas para consultas complexas ou de alto valor, enquanto consultas simples podem ser atendidas apenas pela recuperação vetorial inicial.
Fluxo de decisão para implementar Reranking
Passos para determinar se o reranking é necessário no seu pipeline.
- 01Avaliar a precisão atual da recuperação inicial (top-5).
- 02Se a precisão for baixa e a latência atual for baixa, adicionar reranking.
- 03Limitar o top-k da recuperação inicial (ex.: 20-50 documentos).
- 04Aplicar o reranker para selecionar o top-n final (ex.: 3-5 documentos).
- 05Medir a latência total e ajustar o top-k se exceder os SLAs.