Definição numa frase
Familia de métodos que usa preferencias humanas para entrenar señales de recompensa y orientar el comportamiento de un modelo.
O que é RLHF
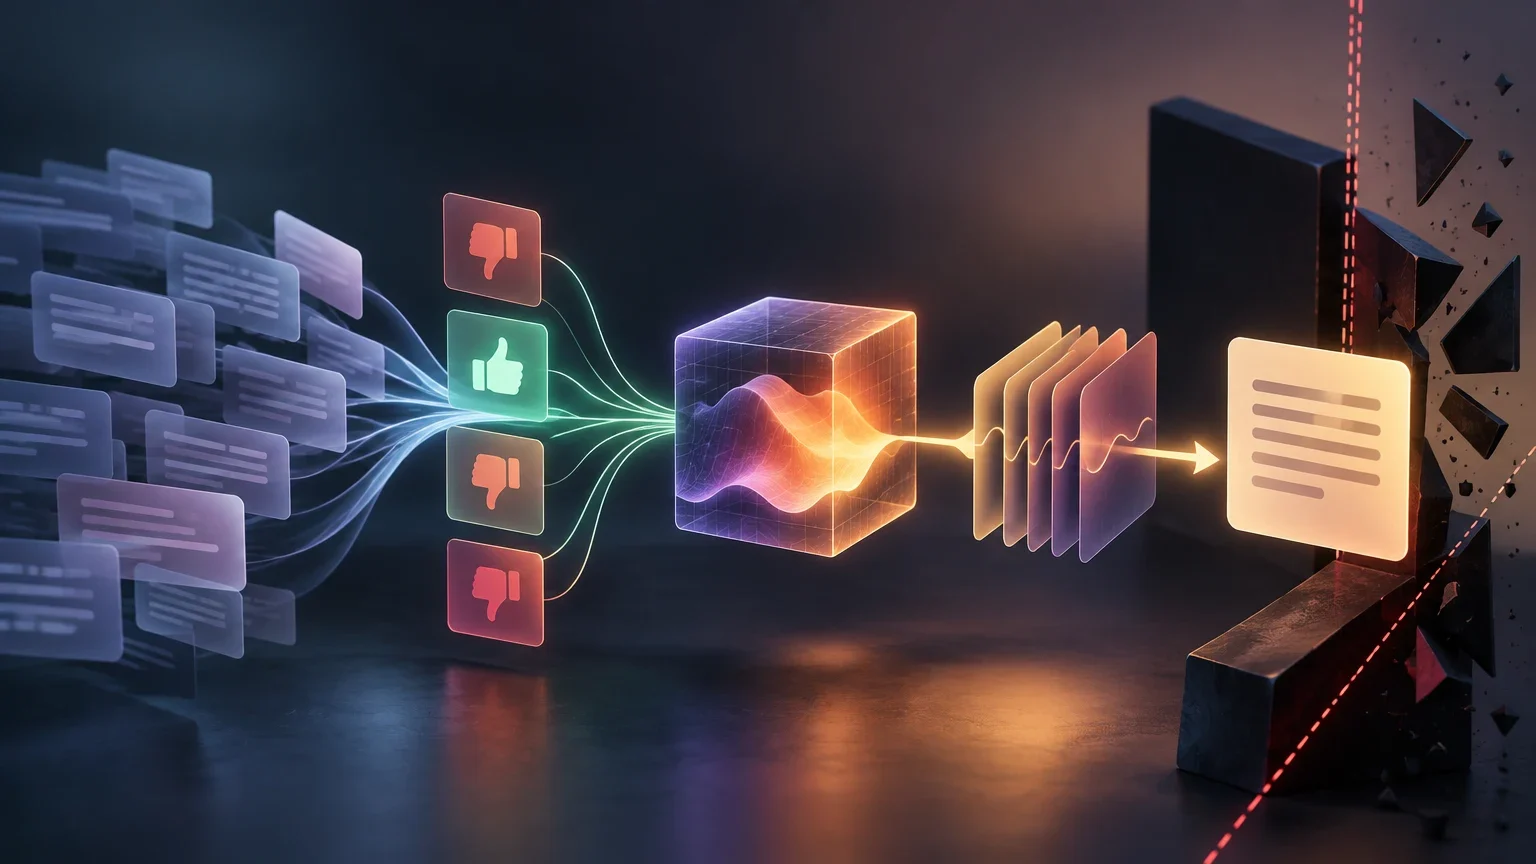
O aprendizado por reforço a partir de feedback humano — RLHF, na sigla em inglês — é uma família de métodos que utiliza avaliações ou preferências humanas para construir um sinal de recompensa e orientar a otimização de um modelo. Em uma implementação comum, pessoas comparam várias respostas possíveis; essas comparações são usadas para treinar um modelo de recompensa, que depois pontua respostas geradas pela política em ajuste.
A abordagem é útil quando é mais fácil julgar qual de dois resultados é preferível do que escrever uma regra matemática completa para definir o resultado ideal. Uma pessoa pode, por exemplo, avaliar se uma resposta é clara, pertinente ou cautelosa. O modelo de recompensa aproxima esses julgamentos com base nos dados disponíveis; não transforma, por si só, critérios subjetivos em uma definição universal de qualidade.
RLHF não designa uma receita única e invariável. O tipo de feedback, a forma de coletá-lo, o modelo utilizado para aprender as preferências e o método de otimização posterior podem variar. Em modelos de linguagem, uma configuração conhecida combina ajuste fino supervisionado, comparações humanas, treinamento de uma recompensa e otimização por aprendizado por reforço. PPO é uma opção para essa última etapa, não um requisito de toda técnica baseada em preferências humanas.
A definição também exige separar o sinal humano do procedimento que o processa. A preferência observada é um dado, o modelo de recompensa é uma aproximação aprendida e a política otimizada é o sistema que se pretende modificar. Confundir esses elementos leva a exagerar o que o método demonstra: melhorar uma pontuação aprendida não prova, por si só, que o modelo seja verdadeiro, seguro ou representativo das preferências de todas as pessoas.
O fluxo técnico, dos dados à política
Em um fluxo frequente para modelos de linguagem, o processo começa com uma política inicial capaz de produzir respostas. Essa política pode vir de um modelo pré-treinado e passar antes por um ajuste fino supervisionado, no qual aprende a imitar respostas de demonstração. Demonstrações e preferências cumprem funções diferentes: as primeiras mostram exemplos de comportamento; as segundas permitem comparar alternativas.
Em seguida, o sistema gera várias respostas para a mesma instrução. Anotadores humanos comparam ou classificam essas respostas segundo critérios definidos para o projeto. Uma comparação em pares pode indicar que, diante de uma pergunta específica, a resposta A é preferível à B. O julgamento registra uma decisão contextual, não necessariamente o motivo completo nem o acordo de todos os avaliadores.
As comparações são usadas para treinar um modelo de recompensa. No caso comum de preferências em pares, ele aprende a atribuir pontuações de modo que a resposta escolhida tenda a receber uma nota maior do que a rejeitada. Depois, a política gera novas respostas e é otimizada para obter pontuações altas segundo essa recompensa aprendida. Algoritmos como PPO podem atualizar a política; em algumas configurações, também se limita o quanto ela pode se afastar de um modelo de referência.
Cada etapa produz artefatos diferentes: demonstrações para o ajuste supervisionado, pares ou classificações anotados, um modelo de recompensa e uma política ajustada. Mantê-los separados facilita auditar qual sinal entrou no sistema e qual transformação foi aplicada. Se uma etapa for omitida — por exemplo, se o modelo for ajustado diretamente com demonstrações —, isso não deve ser descrito automaticamente como o fluxo clássico de RLHF com um modelo de recompensa explícito.
Esse esquema é uma referência, não uma especificação universal. Há projetos que usam outras formas de feedback ou métodos diferentes de otimização. Também existem abordagens de otimização de preferências que dispensam o treinamento de uma recompensa separada seguido por um ciclo convencional de aprendizado por reforço. Por isso, é melhor nomear o método específico em vez de presumir que toda técnica baseada em preferências segue exatamente as mesmas etapas.
Etapas habituais e seus resultados
A sequência abaixo resume uma configuração frequente para um modelo de linguagem; os detalhes variam entre implementações.
- 01Preparar uma política inicial e, se aplicável, ajustá-la com demonstrações supervisionadas.
- 02Gerar várias respostas para instruções selecionadas.
- 03Coletar comparações, classificações ou outras avaliações humanas com critérios definidos.
- 04Treinar um modelo de recompensa que aproxime as preferências observadas.
- 05Otimizar a política com essa recompensa, usando um algoritmo de aprendizado por reforço quando o projeto exigir.
- 06Avaliar o modelo resultante separadamente: a recompensa usada no treinamento não substitui uma avaliação independente.
Exemplos de aplicação
Em um assistente conversacional, avaliadores podem receber duas respostas à mesma pergunta. Eles talvez prefiram a que responde diretamente, distingue fatos de incertezas e evita conteúdo irrelevante. As comparações ajudam a aprender uma recompensa voltada a esses critérios e, depois, a ajustar a política. O exemplo ilustra o mecanismo, mas não afirma que um assistente específico tenha sido treinado dessa maneira.
Na moderação de conteúdo, os avaliadores podem comparar decisões do sistema sobre um mesmo trecho: permitir, remover ou encaminhar para análise. O feedback pode refletir regras e prioridades definidas para um contexto específico. Antes de usá-lo para otimizar uma política, é preciso especificar qual dano se pretende reduzir, qual é o custo de falsos positivos e falsos negativos e quais são as possibilidades de contestação. A preferência de um grupo de anotadores, por si só, não constitui uma norma social universal.
Em um sistema de recomendação, uma pessoa pode preferir um resultado a outro em uma situação concreta: por exemplo, uma opção relevante para uma busca específica em vez de outra popular, mas pouco relacionada à consulta. Essa comparação poderia alimentar um modelo de recompensa usado para ordenar resultados. No entanto, um clique ou uma escolha observada nem sempre expressa satisfação: pode depender da posição do item, da interface ou de informações incompletas. Antes de transformar esse comportamento em feedback, é preciso esclarecer qual objetivo se pretende aproximar.
Nos três casos, o princípio é o mesmo — usar julgamentos para construir um sinal de otimização —, mas mudam a unidade avaliada, as pessoas que julgam e as consequências de um erro. Portanto, ao descrever uma aplicação, é preciso separar um exemplo conceitual do que está documentado sobre um sistema real.
RLHF e conceitos próximos
O ajuste fino supervisionado direto treina um modelo com demonstrações: fornece-se uma entrada e uma resposta de referência, e o modelo aprende a produzir algo parecido. Isso não exige necessariamente aprender uma recompensa a partir de comparações nem otimizar a política depois por meio de aprendizado por reforço. O ajuste supervisionado pode fazer parte do fluxo de RLHF como etapa inicial, mas não é sinônimo do procedimento inteiro.
O aprendizado por reforço sem feedback humano utiliza uma recompensa definida por outra via, como uma pontuação automática ou uma condição verificável. Continua sendo aprendizado por reforço, mas não se torna RLHF apenas porque o sistema otimiza uma recompensa. Da mesma forma, a participação de uma pessoa em uma anotação não basta para demonstrar que houve treinamento de um modelo de recompensa ou aplicação de aprendizado por reforço.
O aprendizado em contexto ocorre quando um modelo usa instruções e exemplos apresentados na consulta para produzir uma resposta, sem que, por isso, seus parâmetros sejam atualizados pelo treinamento descrito. Esse método pode influenciar o comportamento observado durante uma conversa, mas não é, por si só, RLHF.
Esses métodos nem sempre são alternativas mutuamente excludentes. Um sistema pode usar demonstrações supervisionadas antes de coletar preferências e combinar várias formas de avaliação durante seu desenvolvimento. Técnicas de otimização direta de preferências, como DPO, usam dados de preferência sem necessariamente seguir o ciclo explícito de treinar uma recompensa separada e otimizá-la por um algoritmo de aprendizado por reforço. A denominação mais precisa depende dos componentes realmente utilizados.
Como distinguir os métodos
A presença de feedback humano não basta para identificar todas as etapas do treinamento.
| Método | Principal sinal | O que isso não implica por si só |
|---|---|---|
| RLHF habitual | Preferências humanas usadas para aprender uma recompensa e orientar a política | Não garante veracidade, segurança ou consenso universal |
| Ajuste supervisionado direto | Demonstrações de entradas e saídas desejadas | Não exige um modelo de recompensa nem otimização por aprendizado por reforço |
| Aprendizado por reforço sem feedback humano | Recompensa automática, programada ou verificável | Não é RLHF se o sinal não vier de feedback humano |
| Aprendizado em contexto | Instruções e exemplos fornecidos na consulta | Não implica atualizar os parâmetros do modelo |
| Otimização direta de preferências | Pares ou classificações de preferências usados diretamente no ajuste | Não exige necessariamente o ciclo explícito de recompensa seguida de aprendizado por reforço |
O que uma preferência permite concluir — e o que não permite
Uma comparação humana registra uma escolha em condições específicas: quem avaliou, quais alternativas viu, que instruções recebeu e em que momento. Ela pode ajudar a treinar um sistema para imitar padrões de preferência daquele conjunto, mas não demonstra que a escolha represente toda a população nem que expresse valores estáveis em outros contextos.
O modelo de recompensa é um substituto aprendido dos julgamentos que recebeu. Ele pode generalizar mal para instruções ou respostas fora de sua cobertura, confundir um sinal superficial com a qualidade desejada ou atribuir pontuações inconsistentes. Se a política for otimizada intensamente com base nesse sinal, poderá encontrar resultados que recebem notas altas sem cumprir o objetivo humano subjacente. Esse risco costuma ser chamado de exploração ou sobre-otimização da recompensa.
As decisões tomadas durante o processo também influenciam o resultado: como os critérios são redigidos, quais alternativas são geradas, quais perfis de anotadores participam, como os desacordos são resolvidos e qual distribuição de instruções é usada. A falta de diversidade pode deixar algumas preferências ou situações pouco representadas. Mais otimização não corrige automaticamente esse problema; a qualidade do sinal e a abrangência da avaliação continuam sendo determinantes.
Por esses motivos, o RLHF não certifica, por si só, segurança ou veracidade. Um modelo pode parecer mais útil para os avaliadores e continuar cometendo erros factuais. As propriedades desejadas exigem testes específicos, avaliações fora dos dados de treinamento, análise de falhas e, em usos de maior risco, salvaguardas operacionais e supervisão adequadas. A recompensa deve ser interpretada como um objetivo de treinamento, não como um certificado de comportamento.
Erros frequentes e critérios práticos
Um erro frequente é dizer que «os humanos ensinam diretamente seus valores ao modelo». Em um fluxo habitual, as pessoas fornecem julgamentos limitados, e um modelo de recompensa aprende a prevê-los. A política é ajustada depois com base nessa aproximação. O resultado depende de como os critérios foram definidos, de quem fez as anotações e de como os componentes foram treinados e avaliados.
Outro erro é tratar demonstrações, comparações e pontuações como equivalentes. Uma demonstração oferece um exemplo de resposta; uma comparação indica qual de várias opções é preferida; uma pontuação atribui uma avaliação segundo uma escala. São sinais diferentes e exigem interpretações e procedimentos de treinamento distintos. Também não se deve chamar qualquer ajuste posterior ao pré-treinamento de RLHF sem verificar se houve participação de preferências humanas e qual mecanismo foi usado.
Convém evitar também afirmar que o método «alinha o modelo aos valores humanos» sem especificar de quem são os julgamentos e como o resultado foi medido. Uma formulação mais precisa identifica a tarefa, o grupo de avaliadores, o tipo de feedback e o alcance da avaliação. Se houver apenas um exemplo ilustrativo, ele deve ser apresentado como cenário hipotético, não como resultado observado.
Para analisar uma afirmação sobre RLHF, pergunte: o que foi avaliado? Quem avaliou? Que sinal foi produzido? Treinou-se um modelo de recompensa separado? Qual algoritmo modificou a política? Que avaliação independente sustenta a conclusão? Essas perguntas ajudam a distinguir uma descrição técnica específica de uma afirmação geral sobre alinhamento.
Esta ficha se concentra em modelos de aprendizado de máquina e, em especial, no fluxo habitual aplicado a modelos de linguagem. O livro técnico de Nathan Lambert apresenta uma discussão ampla dos métodos e das etapas de RLHF, mas, na página consultada, o livro aparece em uma versão disponível no arXiv. Essa evidência, por si só, não permite afirmar que a obra tenha passado por revisão por pares. A documentação explicativa da AWS oferece uma descrição complementar do fluxo, mas não substitui os artigos primários de cada implementação.
Lista de verificação antes de descrever um sistema
Use estas perguntas para evitar confundir uma etapa, um sinal de dados e uma garantia de desempenho.
| Pergunta | O que esclarecer |
|---|---|
| Que feedback foi coletado? | Comparações, classificações, pontuações, correções ou demonstrações |
| Quem avaliou? | Grupo, especialização, instruções e procedimento para lidar com divergências |
| Como o feedback foi usado? | Ajuste supervisionado, treinamento de recompensa, otimização direta ou outra abordagem |
| Que afirmação se pretende fazer? | Preferência observada, qualidade, segurança, veracidade ou outro resultado |
| Que evidência a sustenta? | Avaliação específica, externa ao treinamento e adequada ao contexto |
Fontes e escopo
A descrição do fluxo habitual se apoia em referências técnicas sobre RLHF e em documentação explicativa sobre suas etapas. Uma configuração comum para modelos de linguagem inclui ajuste supervisionado, coleta de preferências, treinamento de um modelo de recompensa e otimização da política. Essa sequência é uma referência útil, não uma definição rígida que se aplique a todas as implementações.
As limitações descritas — variação entre avaliadores, cobertura incompleta de preferências e possibilidade de explorar a recompensa aprendida — são riscos do método que dependem dos dados e das escolhas de projeto. Não indicam que todos os sistemas apresentem os mesmos problemas, nem quantificam o desempenho de um sistema específico. Os exemplos de conversação, moderação e recomendação são cenários ilustrativos, não relatos de aplicações documentadas.
O livro técnico de Nathan Lambert apresenta uma discussão ampla dos métodos e das etapas de RLHF, mas a página consultada o identifica como uma versão disponível no arXiv. Com as evidências disponíveis, não é possível estabelecer seu status de revisão por pares. A documentação explicativa da AWS complementa a descrição técnica, mas não substitui os artigos primários sobre implementações específicas.