Was Liquid AI angekündigt hat
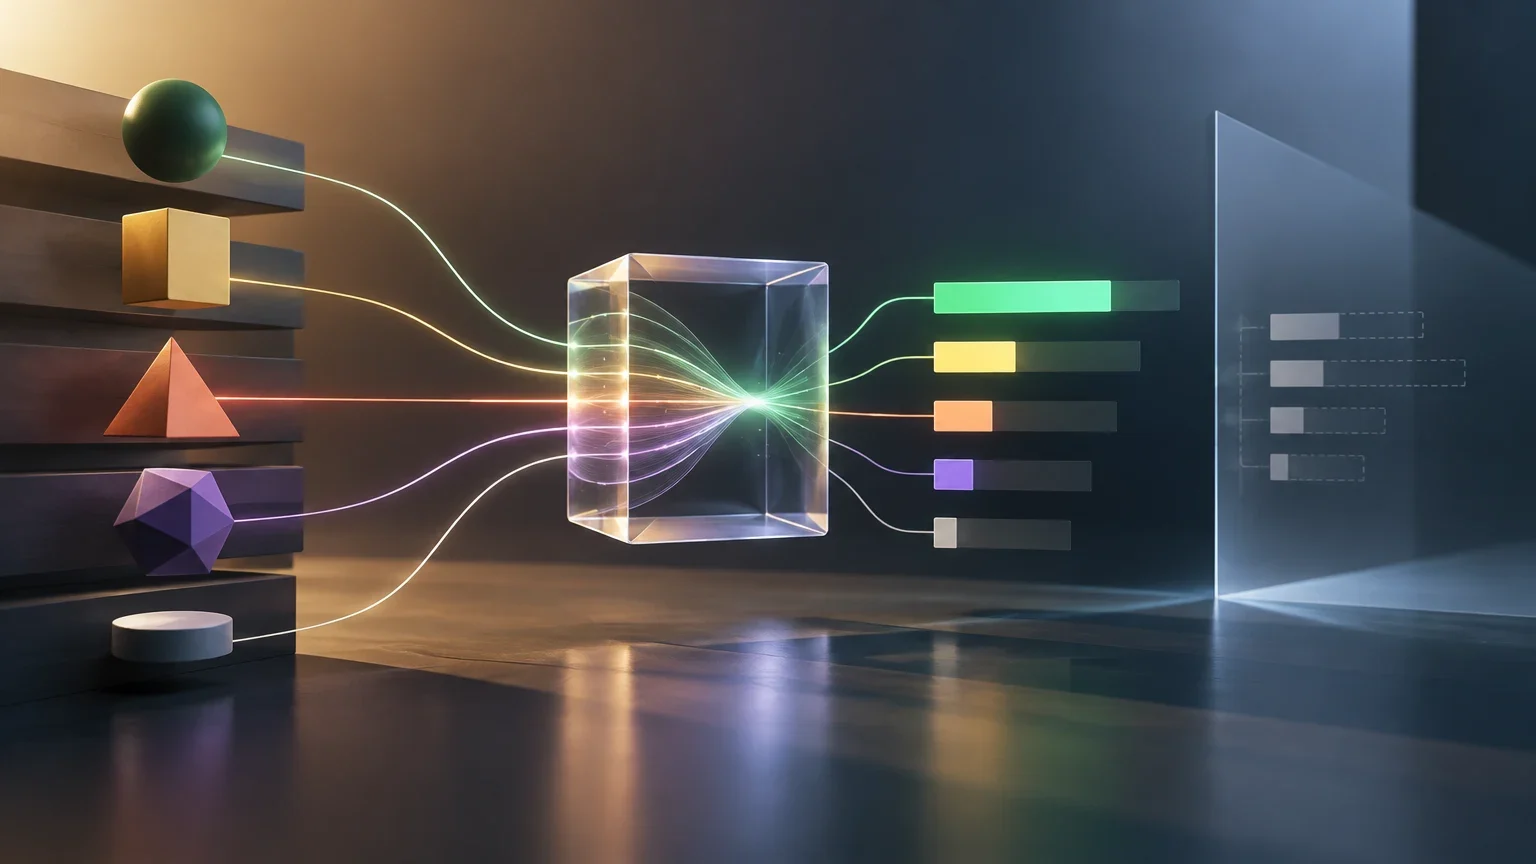
Liquid AI stellt d1 als Entscheidungsmodell vor: Statt eine frei formulierte Antwort zu schreiben, bewertet es eine Eingabe und liefert strukturierte Ergebnisse für eine klar abgegrenzte Entscheidung. Die Dokumentation beschreibt drei Modelle der Familie: d1-3B, ein multimodales Modell für Text und Bilder; d1-omni-600M, das Text, Bilder oder Audio verarbeitet; sowie d1Hosted, das über die Liquid-AI-API verfügbar ist.
Der Anbieter sieht solche Modelle für Klassifizierung, Priorisierung, Moderation, die Zuweisung von Anfragen und andere Aufgaben mit vorab festgelegten Ergebnissen vor. Der Unterschied ist praktisch: Muss ein System ein Label oder einen Wert auswählen, kann es in einem begrenzten Format antworten. Soll es dagegen erklären, zusammenfassen oder schreiben, ist eine generative Fähigkeit erforderlich. Die Dokumentation nennt offene Textgenerierung ausdrücklich als Anwendungsfeld für ein Sprachmodell.
Die in der Dokumentation beschriebene Verfügbarkeit bedeutet nicht, dass jede Modalität, Schnittstelle oder jedes Modell in allen Umgebungen bereitsteht. Vor einer Integration sollte geprüft werden, welches konkrete Modell verfügbar ist, welche Eingaben es akzeptiert und welche API sowie Nutzungsbedingungen aktuell gelten. Im Ankündigungspost erhebt Liquid AI auch eigene Vergleichsergebnisse mit Jev. Diese sind als Aussagen des Anbieters zu lesen, nicht als unabhängige Validierung.
Wie das Modell Entscheidungen ausgibt
Die Dokumentation unterscheidet drei Abfragearten. Choice wählt aus Kategorien ohne feste Reihenfolge und gibt eine Wahrscheinlichkeitsverteilung über die benannten Optionen zurück. Score ordnet die Antwort auf einer festgelegten Skala ein, etwa einer Schweregradskala. Noul stellt eine binäre Frage und liefert eine Wahrscheinlichkeit zwischen 0 und 1 – zum Beispiel dafür, dass eine Nachricht Spam ist.
So lässt sich nicht nur die wahrscheinlichste Option erkennen, sondern auch, wie viel Unsicherheit zwischen den Alternativen besteht. Erhält ein System für zwei Abteilungen ähnlich hohe Wahrscheinlichkeiten, kann es den Fall zur Prüfung weiterleiten, statt das erstplatzierte Label als Gewissheit zu behandeln. Eine probabilistische Ausgabe beweist jedoch nicht automatisch, dass die Wahrscheinlichkeiten gut kalibriert sind. Das muss mit repräsentativen Daten gemessen werden.
Liquid AI zufolge erzeugt d1 keine Antwort-Tokens und liefert eine Entscheidung in einem einzigen Aufruf. Die Formulierung „null generierte Tokens“ beschreibt nach Angaben des Anbieters die Art der Ausgabe. Sie sagt für sich genommen nichts über sämtliche Abrechnungsbestandteile aus, etwa die Verarbeitung der Eingabe, den API-Preis oder Infrastrukturkosten. Ebenso wenig belegt sie, dass eine Aufgabe immer schneller oder günstiger ist als mit einem generativen Modell.
Wo das Modell in Unternehmen passen könnte
Besonders geeignet erscheint der Ansatz, wenn die möglichen Antworten klar begrenzt sind und eine Entscheidung häufig wiederholt wird. Zu den von Liquid AI genannten Anwendungsfällen gehören die Klassifizierung von Nachrichten, die Weiterleitung von Tickets, Moderation, Dringlichkeitsbewertungen, binäre Sicherheitsprüfungen und die Genehmigung von Tool-Aufrufen. Für Bildeingaben nennt das Unternehmen visuelle Inspektion und Bildklassifizierung; für Audio die Erkennung von Absichten und die Weiterleitung von Sprachbefehlen mit dem Modell, das diese Modalität unterstützt.
Ein operatives Beispiel ist die Erstbewertung eingehender Anfragen: Das System weist bekannten Kategorien Wahrscheinlichkeiten zu und leitet mehrdeutige Fälle an einen Menschen weiter. Ein anderes Beispiel ist eine Kontrollstufe, die prüft, ob ein extrahiertes Ergebnis eine Vorgabe erfüllt, bevor es akzeptiert wird. In beiden Fällen hängt der Nutzen davon ab, ob der Optionskatalog die tatsächlichen Fälle abdeckt und ob es einen sicheren Umgang mit neuen, unvollständigen oder außerhalb der Verteilung liegenden Eingaben gibt.
D1 ersetzt nicht automatisch ein LLM. Die Dokumentation empfiehlt generative Modelle für freies Schreiben, Gespräche, Zusammenfassungen, Code, offene Fragen und komplexes mehrstufiges Denken. Eine Architektur kann beide Ansätze verbinden: Ein Entscheidungsmodell übernimmt eine klar eingegrenzte Klassifizierung; wenn eine Erklärung oder eine offene Antwort benötigt wird, kommt ein generatives Modell oder ein Mensch zum Einsatz.
Strukturierte Entscheidung oder generative Ausgabe?
| Anforderung | Möglicher Ansatz | Was zu prüfen ist |
|---|---|---|
| Eine Anfrage einer festen Kategorie zuordnen | Entscheidungsmodell, etwa Choice | Abdeckung der Kategorien, mehrdeutige Fälle und Möglichkeit zur Enthaltung oder menschlichen Prüfung |
| Schweregrad nach einer definierten Skala bewerten | Entscheidungsmodell, etwa Score | Eindeutige Definition der Skala und Übereinstimmung mit menschlichen Bewertungen |
| Eine Erklärung schreiben oder einen Fall zusammenfassen | Generatives Modell | Textqualität, Treue zur Eingabe und Sicherheitskontrollen |
| Eine offene Frage beantworten oder ein Gespräch führen | Generatives Modell | Erforderliche Schlussfolgerungen, Kontext und Bedarf an Rückfragen |
| Eine Aktion anhand binärer Kriterien genehmigen oder ablehnen | Entscheidungsmodell, etwa Noul | Kosten falsch positiver und falsch negativer Entscheidungen, Schwellenwert und Aufsicht |
Was für die Bewertung des Vergleichs mit Jev noch fehlt
Liquid AI zufolge übertrifft d1 Jev im Decision Index von Hugging Face. Das Unternehmen hebt außerdem Ergebnisse bei mehrsprachigen Tests, der Verarbeitung langer Eingaben und der Abwehr von Prompt-Injection hervor. Eine Aussage des Herstellers lässt sich jedoch nicht als unabhängig bestätigte Tatsache behandeln. Für eine Einordnung braucht es die genaue Benchmark-Version, die Aufgaben, die ausgewerteten Daten, das Testprotokoll, die verglichenen Modelle und die Ausführungsbedingungen.
Außerdem sollte ein aggregierter Gesamtwert von den Ergebnissen einzelner Aufgaben unterschieden werden. Ein Index, der verschiedene Prüfungsarten zusammenfasst, kann einen Vergleich erleichtern. Er sagt aber nicht automatisch voraus, wie gut ein System in einem Unternehmen Rechnungen klassifiziert, Nachrichten moderiert oder Tickets weiterleitet. Die Leistung kann sich je nach Sprache, Eingabelänge, Label-Design und Häufigkeit von Ausnahmefällen unterscheiden.
Die vorliegenden Quellen belegen keinen unabhängigen Vergleich von Genauigkeit, Kalibrierung, Latenz und Kosten gegenüber Jev oder generativen Modellen unter gleichwertigen Bedingungen. Um die Aussage, d1 „übertreffe“ Jev, belastbar zu wiederholen, müssten die Modellversionen, der Testsatz und die Methodik dokumentiert werden. Zudem müsste sich das Ergebnis außerhalb der vom Anbieter angekündigten Bewertung reproduzieren lassen.
Mindestprüfung vor der Modellwahl
Eine repräsentative Aufgabe testen und die Alternativen nach demselben Protokoll vergleichen.
- 01Die Entscheidung, die zulässigen Optionen und die Kosten einer Fehlentscheidung festlegen.
- 02Einen Testsatz vorbereiten, der von Beispielen getrennt ist, mit denen Anweisungen oder Schwellenwerte angepasst wurden.
- 03Sprachen, lange Eingaben, Formatfehler und Fälle ohne passende Kategorie einbeziehen.
- 04Qualität je Klasse, Kalibrierung der Wahrscheinlichkeiten und Anteil der an Menschen weitergeleiteten Fälle messen.
- 05Latenz und Gesamtkosten mit einer generativen Alternative auf derselben Infrastruktur und bei gleichem Volumen vergleichen.
- 06Die Bewertung wiederholen, wenn sich Daten, Konfiguration, Modellversion oder Dienstbedingungen ändern.
Grenzen und praktische Auswahlkriterien
Wahrscheinlichkeiten sind nur dann hilfreich, wenn sie für den konkreten Anwendungsfall die tatsächliche Trefferhäufigkeit angemessen widerspiegeln. Ein hoher Wert darf nicht automatisch als Garantie gelten. Außerdem können die Folgen von Fehlern je nach Einsatzbereich unterschiedlich sein: Bei der Moderation haben ein falscher Alarm und das Übersehen schädlicher Inhalte nicht dieselben Kosten. Kalibrierung und Schwellenwerte sollten anhand relevanter Daten geprüft und bei veränderten Eingaben erneut bewertet werden.
Auch der Umgang mit irrelevanten Informationen, bösartigen Anweisungen, unbekannten Kategorien und unvollständigen Eingaben sollte untersucht werden. Die Aussage des Unternehmens, das Modell sei widerstandsfähiger gegen Prompt-Injection, macht eigene Sicherheitstests nicht überflüssig. Bei sensiblen Aufgaben sind menschliche Prüfung, klare Handlungsgrenzen und ein Verfahren zur Weiterleitung unsicherer Fälle sinnvolle Schutzmaßnahmen.
Als Faustregel lohnt sich ein Test von d1, wenn das erwartete Ergebnis in eine festgelegte Struktur passt und sich anhand repräsentativer Beispiele bewerten lässt. Ein generatives LLM eignet sich besser, wenn die Aufgabe offene Antworten oder ausformulierte Texte erfordert. Vermischt ein Prozess beide Anforderungen, kann eine hybride Pipeline erprobt und vor einer Änderung des Produktivsystems hinsichtlich Qualität, Latenz und Gesamtkosten verglichen werden.
Offene Fragen
- Die verfügbaren Quellen enthalten keine unabhängige Bestätigung des Leistungsvergleichs mit Jev oder aller dafür geltenden Bedingungen.
- Es liegen keine vergleichbaren Ergebnisse zu Genauigkeit, Kalibrierung, Latenz und Kosten bei realen Unternehmensaufgaben vor.
- Es ist nicht geklärt, ob „null generierte Tokens“ eine konkrete Änderung der Abrechnung bedeutet; dies muss anhand der API-Bedingungen geprüft werden.
- Verfügbarkeit, Modalitäten und Schnittstellen können je nach Modell und Umgebung variieren; ihr aktueller Stand sollte vor einer Integration bestätigt werden.
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen