Der Vorschlag in Kürze
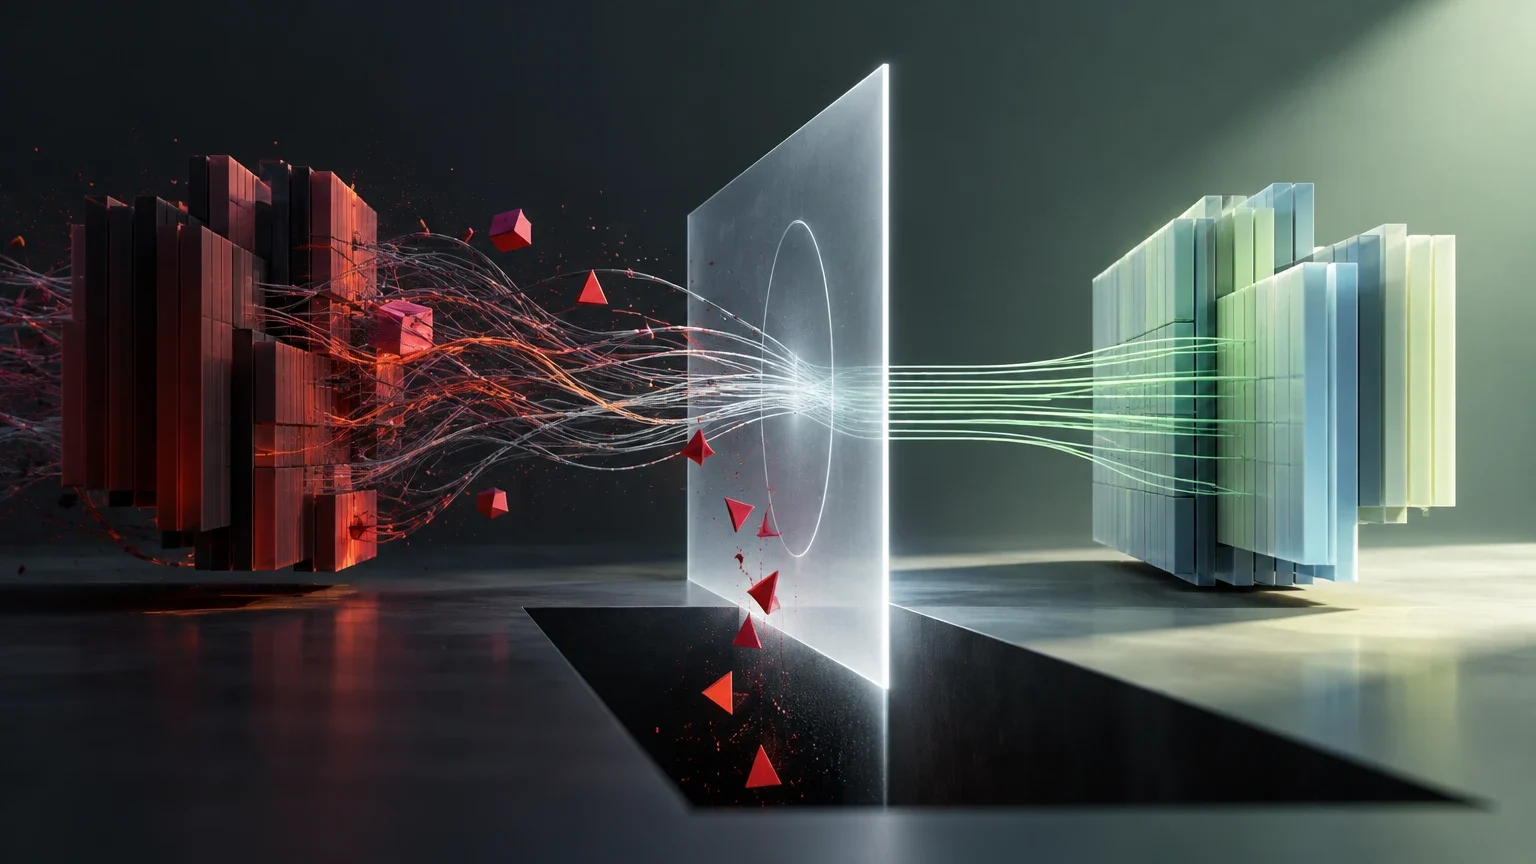
Ein Preprint mit dem Titel „Backdoor Purification for LoRA-Tuned LLMs via Null-Space Projection“ stellt ein Verfahren vor, mit dem Backdoor-Verhalten in per LoRA angepassten Sprachmodellen reduziert werden soll. Dem vorliegenden Abstract zufolge projiziert der Eingriff die LoRA-Updates auf orthogonale Nullräume, die für die Ein- und Ausgabekanäle jeder Schicht oder jedes Attention-Heads konstruiert werden. So soll sich die Angriffserfolgsrate senken lassen, ohne die verdächtigen Parameter anschließend neu zu trainieren.
Das Abstract behauptet außerdem, dass das Verfahren auf einige Voraussetzungen verzichtet, die nach Ansicht der Autoren bisherige Methoden einschränken: die vorherige Kenntnis des Triggers, den Zugriff auf saubere Referenzdaten oder ein aggressives Retraining. Berichtet wird eine Verringerung der Angriffserfolgsrate von nahezu 100 Prozent auf unter 10 Prozent. Zugleich soll die Methode die Benign-Leistung des Basismodells und die vom Adapter erlernten Fähigkeiten erhalten.
Diese Zahlen und Schlussfolgerungen sind Aussagen aus dem Abstract und lassen sich anhand der hier verfügbaren Informationen nicht unabhängig überprüfen. Das vollständige Paper, die experimentellen Tabellen, der Code und die Daten liegen in den bereitgestellten Materialien nicht vor. Der Beitrag kann daher den Vorschlag und die von den Autoren berichteten Ergebnisse beschreiben, aber nicht belegen, dass das Verfahren auch bei anderen Modellen, Angriffen oder Einsatzbedingungen funktioniert.
Warum LoRA einen besonderen Fall darstellt
LoRA ist eine Methode zur Modellanpassung, bei der zusätzliche Parameter eingeführt werden, statt sämtliche Parameter des Basismodells zu verändern und erneut zu speichern. Die bereitgestellte allgemeine Dokumentation beschreibt LoRA als leichtgewichtiges Fine-Tuning-Verfahren; andere Plattformempfehlungen unterscheiden LoRA von Varianten wie QLoRA. Dieser Kontext hilft zu verstehen, warum die Arbeit Adapter in den Mittelpunkt stellt: Sie soll auf den beim Fine-Tuning hinzugefügten Teil einwirken, statt notwendigerweise das gesamte Modell erneut zu trainieren.
Eine Backdoor ist allgemein ein an eine bestimmte Bedingung geknüpftes Verhalten: Taucht ein konkretes Signal oder ein Trigger auf, reagiert das System auf eine vom Urheber der Manipulation vorgesehene Weise. Bei gewöhnlichen Eingaben kann es dagegen normal zu funktionieren scheinen. Das Abstract des Preprints behandelt solche Angriffe, doch die bereitgestellten Informationen nennen weder konkrete untersuchte Trigger noch die Art, wie sie eingefügt wurden. Daraus lässt sich nicht schließen, dass die Arbeit alle Möglichkeiten abdeckt, Backdoors in ein angepasstes Modell einzubringen.
Als Ziel nennt die Arbeit, zwei Dinge zugleich zu bewahren: die allgemeinen Fähigkeiten des Basismodells und die neuen Fertigkeiten, die der Adapter für eine nachgelagerte Aufgabe hinzugefügt hat. Diese doppelte Anforderung ist wichtig. Eine Abwehrmaßnahme, die zwar das bösartige Verhalten beseitigt, zugleich aber die Anpassung unbrauchbar macht, würde das praktische Ziel der Arbeit verfehlen.
Wie die von den Autoren beschriebene Projektion funktioniert
Das Abstract skizziert einen Ablauf auf hoher Ebene. Zunächst würden die Autoren durch sorgfältige Datenauswahl und Feature-Approximation Richtungen extrahieren, die mit der Backdoor verbunden sind. Anschließend würden sie für jede Schicht oder jeden Head orthogonale Nullräume in den Ein- und Ausgabekanälen konstruieren. Zum Schluss würden sie die LoRA-Updates auf diese Räume projizieren.
Anschaulich soll die Projektion eines Updates auf einen Raum Komponenten entfernen, die an bestimmten Richtungen ausgerichtet sind, und Komponenten außerhalb dieser Richtungen erhalten. In diesem Fall sollen die betreffenden Richtungen mit dem bösartigen Verhalten zusammenhängen, das unterdrückt werden soll. Diese Erklärung ist eine allgemeine Interpretation des im Abstract beschriebenen Mechanismus. Sie ersetzt weder eine mathematische Spezifikation noch ermöglicht sie, den genauen Algorithmus nachzubilden.
Die Idee, eine Projektion statt eines weiteren Trainingsdurchlaufs einzusetzen, entspricht dem Anspruch, direkt auf die angepassten Parameter einzuwirken. Ohne das vollständige Paper lässt sich nicht feststellen, welche Daten zur Approximation der Features verwendet werden, wie die Richtungen ausgewählt werden, welche Schwellenwerte gelten oder wie stark sich das ursprüngliche Update verändert. Ebenso wenig lässt sich bestätigen, ob alle Schritte ohne indirekte Informationen über den Angriff ausgeführt werden.
Der im Abstract beschriebene Ablauf
- 01Daten auswählen und Features approximieren, um mit der Backdoor verbundene Richtungen zu extrahieren.
- 02Orthogonale Nullräume für die Ein- und Ausgabekanäle jeder Schicht oder jedes Heads konstruieren.
- 03Die LoRA-Updates auf diese Räume projizieren, um das bösartige Verhalten zu verringern.
- 04Messen, ob der Angriffserfolg sinkt und ob die benignen Fähigkeiten des Modells und des Adapters erhalten bleiben.
Was es bedeutet, ohne bekannte Trigger oder saubere Referenzdaten zu arbeiten
Das Abstract stellt das Verfahren als Antwort auf Abwehrmethoden dar, die häufig mindestens eine starke Voraussetzung haben – darunter die vorherige Kenntnis des Triggers oder den Zugriff auf saubere Referenzdaten. Im üblichen Verständnis bedeutet ein bekannter Trigger, dass das Signal verfügbar ist, das das Backdoor-Verhalten auslöst. Saubere Referenzdaten sind Beispiele, die als nicht kontaminiert gelten und zur Erkennung oder Bewertung herangezogen werden können.
Die Formulierung im Abstract besagt, dass die Autoren diese Abhängigkeiten vermeiden wollen. Die bloße Wiederholung dieser Aussage reicht jedoch nicht aus, um festzustellen, welche Informationen das Verfahren tatsächlich benötigt. Das Abstract erwähnt selbst Datenauswahl und Feature-Approximation, erläutert aber nicht, welche Daten gesammelt werden, ob sie als sauber gelten, wie sie beschafft werden oder ob sie indirekt Hinweise auf den Trigger enthalten. „Ohne saubere Referenzdaten“ sollte deshalb als eine Eigenschaft verstanden werden, die die Arbeit nach eigenen Angaben adressiert – nicht als eine für alle Szenarien bereits verifizierte Bedingung.
Ebenso wenig lässt sich daraus schließen, dass das Verfahren ohne jegliche Annahmen über den Angriff funktioniert. Um das beurteilen zu können, müsste man wissen, welchen Zugriff auf das Modell die Abwehr voraussetzt, welche Daten das Verfahren verwendet, welche Informationen während der Bereinigung verfügbar sind und welche Trigger-Varianten getestet wurden. Das Abstract führt diese Punkte nicht aus.
Die Aussagen vorsichtig einordnen
| Aussage im Abstract | Was sich anhand der verfügbaren Informationen sagen lässt | Was zur Überprüfung fehlt |
|---|---|---|
| Der Trigger muss nicht vorab bekannt sein. | Die Arbeit erklärt, dass sie auf dieses Vorwissen verzichten will. | Die Liste der Trigger und die konkreten Testbedingungen. |
| Es werden keine sauberen Referenzdaten benötigt. | Das Abstract stellt diese Unabhängigkeit als Ziel des Verfahrens dar. | Die Herkunft der Daten und eine operationale Definition von „sauber“. |
| Die verdächtigen Parameter müssen nicht nachträglich neu trainiert werden. | Der vorgeschlagene Eingriff wird als Projektion der LoRA-Updates beschrieben. | Der vollständige Ablauf und eine Bestätigung, welche Schritte als Retraining gelten. |
Berichtete Ergebnisse und notwendige Prüfungen
Das Abstract gibt an, dass die Angriffserfolgsrate von nahezu 100 Prozent auf unter 10 Prozent sinkt. Außerdem sollen die Benign-Leistung des Basismodells und die durch den Adapter erlernten Fähigkeiten erhalten bleiben. Das sind drei relevante Aspekte: die Reaktion auf den Angriff, die normale Funktionsweise des Modells und der Nutzen der Anpassung. Eine überzeugende Evaluation müsste jeden davon getrennt ausweisen und ausreichend Metriken, Testdatensätze und Vergleiche bereitstellen, um die Zielkonflikte nachvollziehen zu können.
Die vorliegende Quelle erwähnt Ablationsstudien und eine schrittweise Ausweitung von einer einzelnen Schicht in einer Textklassifikationsaufgabe auf ein Sprachmodell mit allen Parametern in einer generativen Aufgabe. Das gibt einen Hinweis auf den Umfang der Tests, spezifiziert jedoch nicht, welche Modelle verwendet wurden, wie viele Adapter evaluiert wurden, welche Aufgaben sie abbildeten, welche Angriffe zum Einsatz kamen oder wie die Benign-Leistung gemessen wurde. Ohne weitere Informationen lassen sich diese Details nicht ergänzen, ohne sie zu erfinden.
Wichtig ist auch, ob die Projektion unter vergleichbaren Bedingungen mit bestehenden Abwehrmaßnahmen verglichen wurde. Das bereitgestellte Material enthält keine Angaben zu solchen Vergleichen. Ebenso wenig lassen sich Schwankungen zwischen Durchläufen, Unsicherheitsintervalle, die Empfindlichkeit gegenüber Implementierungsentscheidungen oder die Übertragbarkeit auf andere als die getesteten Angriffe prüfen.
Reichweite und offene Fragen
Der Vorschlag behandelt ein relevantes Sicherheitsproblem bei Modellen, die mit Adaptern angepasst wurden: Wie lässt sich bösartiges Verhalten verringern, ohne den Nutzen des Fine-Tunings zu opfern? Das im Abstract beschriebene Merkmal ist die Kombination aus der Extraktion Backdoor-bezogener Richtungen und der orthogonalen Projektion der LoRA-Updates – ohne nachträgliches Retraining der verdächtigen Parameter.
Die verfügbare Evidenz ist jedoch vorläufig. Bei der Originalquelle handelt es sich um einen Preprint; das bereitgestellte Material umfasst das Abstract, nicht das vollständige Paper. Auf dieser Grundlage lässt sich weder behaupten, das Verfahren sei begutachtet worden, noch dass reproduzierbare Implementierungen vorliegen oder Code, Gewichte und Daten verfügbar sind. Auch ein Vergleich mit früheren Abwehrmethoden unter gleichen Bedingungen ist nicht bestätigt.
Die derzeit präziseste Einordnung lautet: Die Autoren legen einen Vorschlag vor und berichten vielversprechende Ergebnisse, doch allein anhand des Abstracts lässt sich dessen Reichweite nicht umfassend bewerten. Vor einem Einsatz in der Produktion wären methodische Einzelheiten, reproduzierbare Tests, Evaluationen über unterschiedliche Modelle und Aufgaben hinweg sowie Analysen möglicher Fähigkeitsverluste erforderlich. Ob sich das Verfahren auf nicht untersuchte Adapter, Trigger und Einsatzumgebungen übertragen lässt, bleibt offen.
Was für eine Bewertung der Arbeit zu prüfen ist
- 01Das vollständige Paper heranziehen und die Annahmen sowie den Projektionsalgorithmus prüfen.
- 02Modelle, Adapter, Trigger, Daten und Aufgaben ermitteln, die in den Tests enthalten waren.
- 03Die Metriken für Angriffserfolg, Benign-Leistung und die Fähigkeiten des Adapters getrennt betrachten.
- 04Vergleiche mit bestehenden Abwehrmethoden sowie die Verfügbarkeit von Code, Daten oder Artefakten zur Reproduktion der Ergebnisse überprüfen.
- 05Untersuchen, ob die Schlussfolgerungen über die getesteten Szenarien hinaus gelten und welche Fähigkeiten sich verschlechtern könnten.
Offene Fragen
- Das vollständige Preprint und die experimentellen Tabellen wurden nicht bereitgestellt.
- Die vorliegenden Informationen nennen keine konkreten Modelle, Adapter, Datensätze, Aufgaben oder Trigger.
- Die vollständigen Metriken zur Erhaltung benigner Fähigkeiten und der mit LoRA erlernten Fertigkeiten werden nicht spezifiziert.
- Es ist nicht bekannt, ob direkte Vergleiche mit anderen Abwehrmethoden unter denselben Bedingungen durchgeführt wurden.
- Die Verfügbarkeit von Code, Gewichten, Daten oder ausreichenden Anweisungen zur Reproduktion der Ergebnisse ist nicht bestätigt.
- Das Abstract erklärt nicht, wie das Fehlen sauberer Referenzdaten operationalisiert wird oder welche Daten die Feature-Approximation verwendet.
- Die Übertragbarkeit des Verfahrens auf andere Angriffe, Modelle oder Umgebungen als die untersuchten lässt sich nicht bestimmen.
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen