Definition in einem Satz
Técnica de ajuste eficiente que entrena pequeñas matrices adicionales en lugar de modificar todos los parámetros del modelo.
Was ist LoRA?
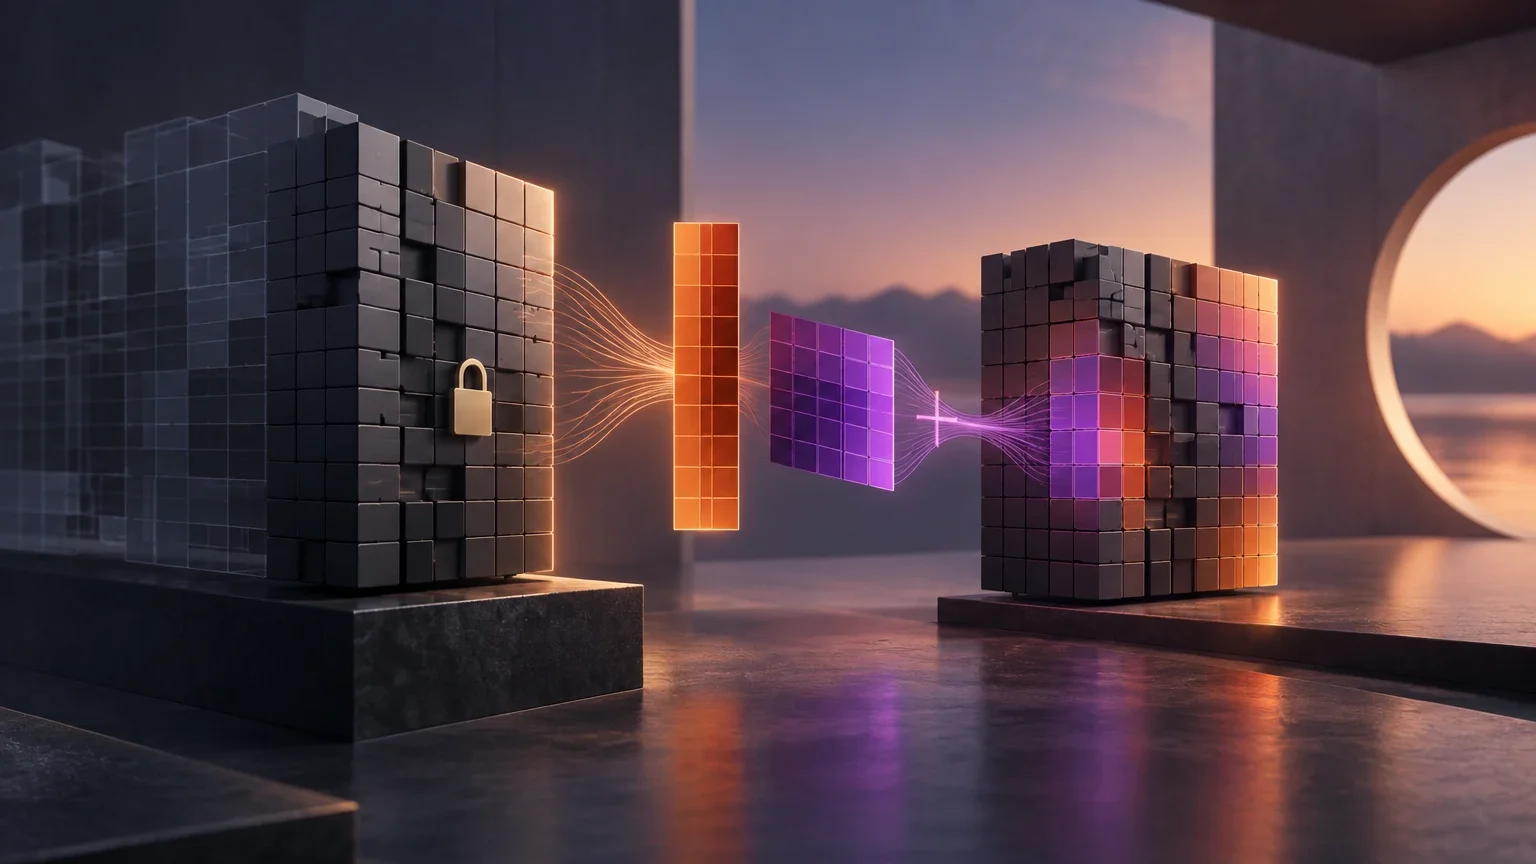
LoRA steht für Low-Rank Adaptation, auf Deutsch etwa Anpassung niedrigen Rangs. Die Technik dient dazu, ein vortrainiertes Modell an eine Aufgabe oder einen bestimmten Kontext anzupassen, ohne sämtliche ursprünglichen Modellgewichte zu aktualisieren. Statt den gesamten Parametersatz des Modells zu verändern, bleiben diese Gewichte eingefroren; hinzu kommen trainierbare Matrizen niedrigen Rangs. Während der Anpassung werden die zusätzlich eingeführten Matrizen optimiert.
Die Grundidee besteht darin, das im Vortraining Gelernte von den Änderungen zu trennen, die für eine konkrete Aufgabe benötigt werden. Das Ausgangsmodell behält seine ursprünglichen Parameter. Die Anpassung wird durch kleinere zusätzliche Komponenten dargestellt. In der ursprünglichen Arbeit wird LoRA als Methode beschrieben, die vortrainierte Gewichte einfriert und trainierbare Matrizen zur Rangzerlegung einführt.
LoRA kommt infrage, wenn ein Modell angepasst werden soll und dabei weniger Parameter trainiert werden sollen, als es beim Aktualisieren sämtlicher Gewichte der Fall wäre. Das beschreibt zunächst nur den Aufbau des Verfahrens. Daraus folgt nicht automatisch, dass LoRA in jedem System günstiger ist, bessere Antworten liefert oder für jede Aufgabe geeignet ist.
So funktioniert es: eingefrorene Gewichte und trainierbare Matrizen
Zum Verständnis des Mechanismus kann man sich eine Transformation im Modell vorstellen, die durch eine vortrainierte Gewichtsmatrix dargestellt wird. Wir nennen sie W₀. Beim herkömmlichen Fine-Tuning aller Gewichte kann das Training W₀ verändern. In der konzeptionellen Beschreibung von LoRA bleibt W₀ eingefroren. Die Anpassung wird stattdessen als zusätzliche Aktualisierung ΔW ausgedrückt, die durch das Produkt zweier kleinerer Matrizen angenähert wird: ΔW = B × A.
Vereinfacht ausgedrückt: Wenn W₀ Vektoren der Dimension d_Eingabe in Vektoren der Dimension d_Ausgabe überführt, kann A die Dimensionen r × d_Eingabe und B die Dimensionen d_Ausgabe × r haben. Der Wert r bezeichnet den Rang, der in dieser Darstellung verwendet wird, und ist üblicherweise kleiner als die vollständigen Dimensionen der Transformation. Die resultierende Operation lässt sich als W₀ + ΔW beschreiben. Die konkrete Umsetzung kann jedoch variieren, etwa darin, wie diese Komponenten angeordnet, skaliert oder angewendet werden.
Das Modell selbst wird durch die Anpassung nicht überflüssig: Seine Gewichte liefern weiterhin die im Vortraining erlernten Repräsentationen. Während des Fine-Tunings werden die zusätzlichen Matrizen trainiert. Wenn es also heißt, LoRA „trainiere weniger Parameter“, bezieht sich das auf die Parameter, die in diesem Prozess aktualisiert werden. Gemeint sind damit nicht zwingend sämtliche Ressourcen, die ein Lauf benötigt, oder die Größe des gesamten Systems im Produktivbetrieb.
Die vorstehende mathematische Darstellung ist eine vereinfachte Erläuterung des Ansatzes mit Matrizen niedrigen Rangs und keine universelle Spezifikation für jede Implementierung. Wer ein konkretes Ergebnis reproduzieren möchte, muss die zugehörige technische Konfiguration prüfen: Welche Komponenten erhalten Adapter? Welcher Rang wird gewählt? Und wie wird die Aktualisierung mit dem Modell verbunden?
Konzeptioneller Ablauf einer Anpassung mit LoRA
- 01Ein vortrainiertes Modell und eine konkrete Anpassungsaufgabe auswählen.
- 02Die vortrainierten Gewichte im beschriebenen LoRA-Verfahren eingefroren lassen.
- 03Trainierbare Matrizen niedrigen Rangs als Anpassungskomponenten hinzufügen.
- 04Diese Matrizen anhand aufgabenrelevanter Daten trainieren, ohne anzunehmen, dass beliebige Daten ausreichend oder geeignet sind.
- 05Das angepasste Modell mit repräsentativen Beispielen bewerten und seine Grenzen prüfen, bevor über den vorgesehenen Einsatz entschieden wird.
Drei Anwendungsbeispiele
Die folgenden Fälle sind Beispiele zur Veranschaulichung. Sie beschreiben mögliche Vorgehensweisen bei einer Anpassung, keine beobachteten Ergebnisse und keine Empfehlung, dass LoRA die richtige Wahl wäre. In jedem Fall hängt die Entscheidung vom verfügbaren Modell, den Daten, den Bewertungsmaßstäben und den Projektbedingungen ab.
blocks
Abgrenzung zu verwandten Verfahren
LoRA wird häufig mit anderen Möglichkeiten verglichen, Modelle zu personalisieren oder anzupassen. Diese Verfahren verändern jedoch nicht zwangsläufig dieselben Modellbestandteile und verfolgen auch nicht immer dasselbe Ziel. Die folgenden Abgrenzungen sind konzeptionell. In einer konkreten Implementierung können Verfahren kombiniert werden. Deshalb sollte vor einem Vergleich geprüft werden, was im jeweiligen Fall tatsächlich eingesetzt wurde.
blocks
Was sich bei den verschiedenen Ansätzen ändert
Die Tabelle fasst allgemeine Unterschiede zusammen. Sie behauptet weder, dass ein Ansatz überlegen ist, noch, dass alle Implementierungen identisch funktionieren.
| Ansatz | Was angepasst oder verändert wird | Nützliche Frage |
|---|---|---|
| LoRA | Die vortrainierten Gewichte bleiben eingefroren; zusätzliche Matrizen niedrigen Rangs werden trainiert. | Funktioniert für die Aufgabe eine Anpassung, die durch diese Komponenten dargestellt wird? |
| Vollständiges Fine-Tuning | Beim Training werden Gewichte des Modells selbst aktualisiert, statt das Training auf LoRA-Matrizen zu beschränken. | Müssen die Modellgewichte umfassend angepasst werden, und sind die nötigen Ressourcen und Kontrollen vorhanden? |
| Quantisierung | Das Modell wird mit verringerter numerischer Präzision dargestellt oder gespeichert. Für sich genommen legt Quantisierung keine Anpassungsaufgabe fest. | Sollen Anforderungen an Darstellung oder Ausführung reduziert werden, und welche Auswirkungen hat das auf die Qualität? |
| In-Context Learning | Anweisungen oder Beispiele in der Eingabe steuern die Antwort. Das bedeutet nicht, dass dabei die Gewichte trainiert werden. | Reicht eine Änderung des Eingabekontexts aus, um das gewünschte Verhalten zu erreichen? |
Was LoRA nicht garantiert und häufige Missverständnisse
Ein häufiges Missverständnis ist, „weniger trainierbare Parameter“ mit „geringeren Gesamtkosten“ gleichzusetzen. Im Vergleich zu einem Fine-Tuning, das alle Gewichte verändert, verringert das Design von LoRA die Zahl der aktualisierten Parameter. Die Gesamtkosten hängen jedoch auch von der Konfiguration, den Daten, der Hardware, dem Training, der Bewertung und der Bereitstellung des Modells ab. Ohne diese Bedingungen zu messen, lässt sich nicht ableiten, wie viel ein bestimmtes Projekt tatsächlich einspart.
Ebenso wenig folgt daraus, dass das Modell genauer sein wird. Die Qualität hängt von der Aufgabe, dem Ausgangsmodell, der Qualität und Repräsentativität der Daten, der Konfiguration und der Bewertungsmethode ab. Eine Anpassung kann nützliche Muster lernen, bei neuen Fällen aber schlecht verallgemeinern oder in den Beispielen vorhandene Verzerrungen verstärken. Die Anzahl der Parameter ersetzt keine Vergleichstests.
LoRA sollte auch nicht mit einem vollständig neuen Modell verwechselt werden. In der hier beschriebenen Form wird die Anpassung zum vortrainierten Modell hinzugefügt, dessen Gewichte eingefroren bleiben. Wie nützlich die angepasste Komponente ist, hängt davon ab, wie sie sich zum Basismodell verhält und wie sie angewendet wird. Aus dem Umstand, dass sich trainierte Matrizen aufbewahren und vom ursprünglichen Modell trennen lassen, folgt nicht, dass sie ein selbstständiges System bilden.
Schließlich beweist eine geringere Zahl trainierter Parameter nicht, dass der Prozess sicher ist. Sicherheit setzt voraus, Risiken zu bestimmen, Daten verantwortungsvoll aufzubereiten, unerwünschtes Verhalten zu prüfen und geeignete Kontrollen für den Nutzungskontext einzurichten. Ein Anpassungsverfahren beschreibt einen Teil des technischen Ablaufs; es ersetzt diese Aufgaben nicht.
Praktische Kriterien für die Frage, ob LoRA infrage kommt
Am Anfang steht eine präzise Beschreibung der Aufgabe. „Ein Modell personalisieren“ ist zu allgemein. Es sollte klar sein, welches Verhalten sich ändern und welches erhalten bleiben soll, wer das System nutzen wird und welche Fehler besonders wichtig wären. Lässt sich das Problem mit Anweisungen, Beispielen im Kontext oder einer Dokumentensammlung lösen, ist eine Anpassung der Modellparameter möglicherweise nicht nötig.
Anschließend ist zu prüfen, ob geeignete Daten vorhanden sind, mit denen sich das gewünschte Verhalten trainieren und bewerten lässt. Beispiele einfach nur zu sammeln, reicht nicht. Sie sollten typische und relevante Fälle abdecken, mit den Einsatzbedingungen vereinbar sein und eine unabhängige Bewertung ermöglichen. Hängt die Aufgabe von Informationen ab, die sich häufig ändern, belegt eine Anpassung des Modells nicht, dass es aktuelle Daten kennt.
Ein Vergleich sollte eine klare Referenz einschließen, etwa das nicht angepasste Modell oder eine passende Alternative, und die Ergebnisse anhand derselben Kriterien messen. Neben einer Gesamtkennzahl empfiehlt es sich, Fehlerarten, Grenzfälle und Unterschiede zwischen Teilgruppen oder Betriebsbedingungen zu untersuchen. Geht es darum, Kosten oder Anforderungen an die Ausführung zu reduzieren, müssen auch die tatsächlichen Ressourcen gemessen werden.
Zum Schluss sollte die konkrete Konfiguration dokumentiert werden: Ausgangsmodell, Daten, Anpassungsparameter, Bewertungsverfahren und bekannte Einschränkungen. LoRA ist eine technische Option, die unter diesen Bedingungen geprüft werden kann. Eine Entscheidung für oder gegen das Verfahren lässt sich nicht allein anhand der Modellgröße oder einer allgemeinen Effizienzbehauptung treffen.
Checkliste für eine verantwortungsvolle Bewertung
- 01Das gewünschte Verhalten und die zu vermeidenden Fehler festlegen.
- 02Prüfen, ob Anweisungen, Beispiele im Kontext oder eine einfachere Lösung ausreichen.
- 03Sicherstellen, dass die Anpassungsdaten relevant sind und die Bewertung Fehler sichtbar machen kann.
- 04LoRA anhand gleichwertiger Kriterien und Bedingungen mit einer Referenz vergleichen.
- 05Qualität und Ressourcen im vorgesehenen Einsatzumfeld messen; sie nicht allein aus der Zahl trainierbarer Parameter ableiten.
- 06Einschränkungen dokumentieren und das Verhalten prüfen, bevor der Einsatz ausgeweitet wird.
Verwandte Begriffe und Grenzen der verfügbaren Informationen
LoRA gehört zur Familie effizienter Modellanpassungsverfahren. Das Merkmal, das die konsultierte Primärquelle für LoRA nennt, ist das Einfrieren der vortrainierten Gewichte und das Hinzufügen trainierbarer Matrizen zur Rangzerlegung. „Fine-Tuning“ ist ein breiterer Begriff für die Anpassung eines Modells durch Training und bedeutet nicht zwangsläufig, dass LoRA verwendet wurde. „Quantisierung“ betrifft einen anderen Aspekt: die numerische Darstellung des Modells. Beim In-Context Learning wiederum werden die Eingabeinformationen verändert; allein durch das Einfügen von Beispielen werden nicht die Gewichte verändert.
Diese Kategorien können in realen Systemen kombiniert werden. Um eine Aussage zu einem Modell zu verstehen, sollte man deshalb fragen, welche Gewichte aktualisiert wurden, welche numerische Darstellung zum Einsatz kam, welche Informationen in der Eingabe bereitgestellt wurden und welche Bewertung das Ergebnis stützt. Die bloße Nennung einer Technik reicht nicht aus, um die konkrete Konfiguration zu rekonstruieren oder ihr eine bestimmte Leistung zuzuschreiben.
Die für diesen Eintrag geprüften Informationen stützen die grundlegende Beschreibung von LoRA. Sie reichen jedoch nicht aus, um hier empfohlene Konfigurationen, quantitative Ergebnisse, Verbesserungen gegenüber alternativen Methoden oder allgemeingültige Aussagen zu den rechnerischen Grenzen abzuleiten. Dafür müssten der vollständige technische Text und die Dokumentation einer konkreten Implementierung geprüft werden. Die Vergleiche in diesem Eintrag dienen daher der begrifflichen Abgrenzung und sind keine Ergebnisse eines Leistungsvergleichs.