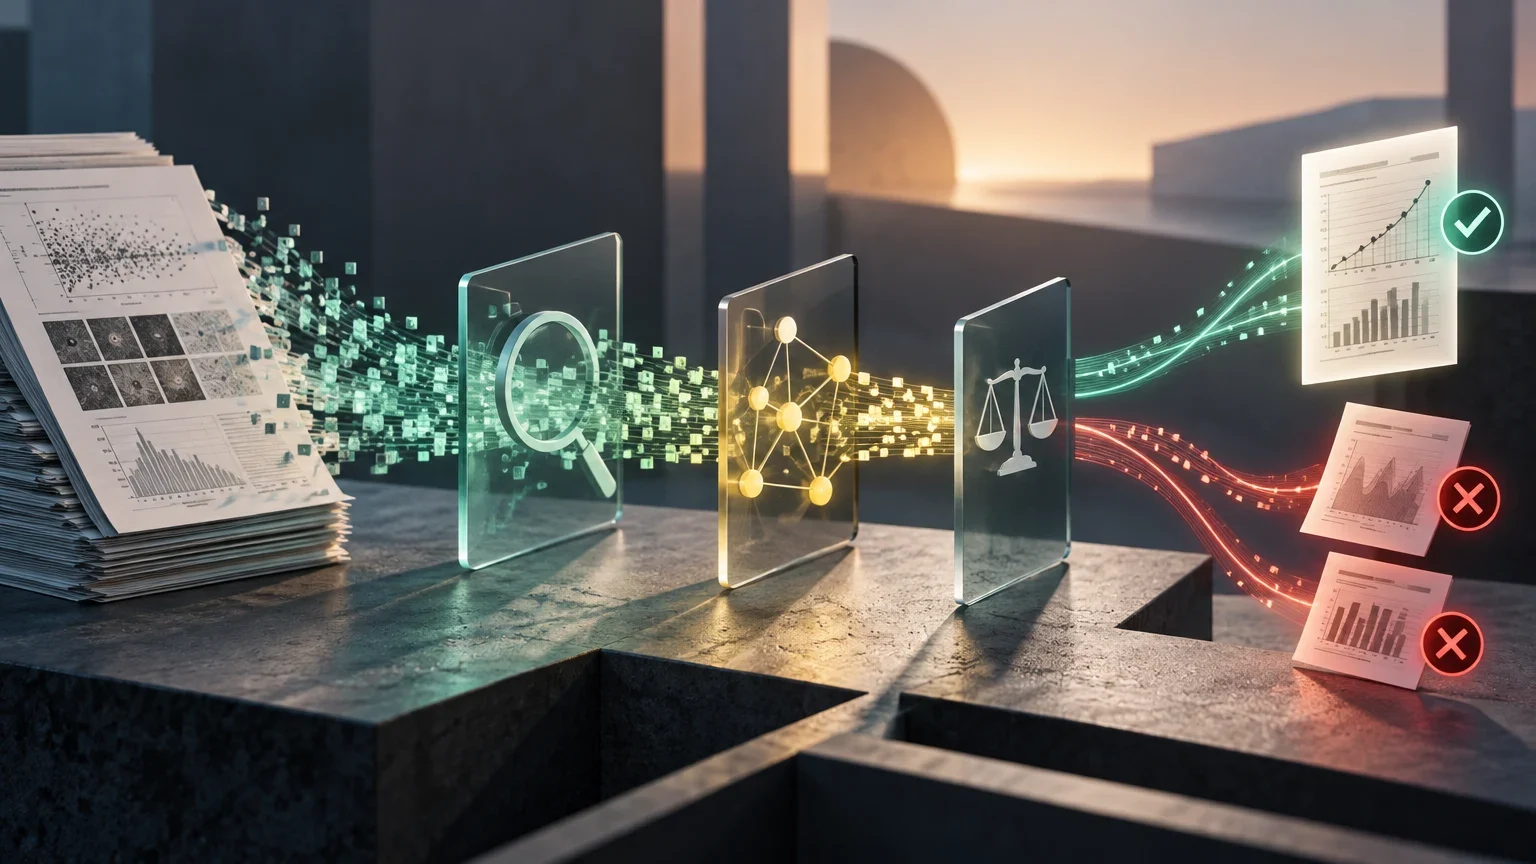
Il problema della sovrainterpretazione e la validità interna
Nella letteratura sull'intelligenza artificiale, è frequente che la conclusione finale di un articolo superi la portata dei dati sperimentali presentati. Questa sovrainterpretazione non implica sempre mala fede, ma deriva spesso dalla complessità dei sistemi valutati e dalla pressione di comunicare risultati d'impatto. Per il ricercatore o l'ingegnere che deve prendere decisioni di design, distinguere tra ciò che è stato misurato e ciò che è stato inferito è una competenza critica.
La validità interna si riferisce alla capacità di uno studio di stabilire una relazione causale o di associazione affidabile tra le variabili manipolate e i risultati osservati, controllando i fattori di confusione. A differenza della validità esterna, che affronta la generalizzazione ad altri contesti, la validità interna si concentra sulla coerenza inferenziale all'interno delle specifiche condizioni sperimentali. Un paper può avere un'esecuzione tecnica impeccabile ma mancare di validità interna se la metrica riportata non misura direttamente il costrutto affermato nella conclusione.
Passo 1: Identificare l'osservazione diretta
Il primo passo dell'audit consiste nell'isolare quali dati grezzi o risultati sperimentali vengono presentati nell'articolo. Ciò implica leggere la sezione dei risultati e gli allegati tecnici per determinare esattamente cosa è stato misurato. In molti paper di IA, l'osservazione diretta è un numero: un punteggio in un benchmark, un tasso di errore o una metrica di efficienza computazionale.
È fondamentale verificare come è stata misurata quell'osservazione. È stato utilizzato un set di dati standard o uno proprietario? La metrica è automatica (come l'accuratezza in un task di classificazione) o richiede un giudizio umano (come la valutazione della coerenza di una risposta generativa)? Le guide di verifica sottolineano che la responsabilità di controllare la fonte originale dei dati ricade sul lettore, poiché gli strumenti automatici o i riassunti possono omettere dettagli cruciali sulla provenienza delle informazioni.
Passo 2: Tracciare l'inferenza e i presupposti impliciti
Una volta identificata l'osservazione, il lettore deve tracciare il percorso logico seguito dagli autori per arrivare alla loro interpretazione. È qui che risiedono spesso i presupposti non dichiarati. Ad esempio, se un modello migliora in una metrica di ragionamento logico, gli autori possono inferire che il modello abbia sviluppato una capacità di ragionamento astratto. Tuttavia, è possibile che il modello abbia semplicemente appreso pattern superficiali dai dati di addestramento che coincidono con la struttura delle domande del benchmark.
L'analisi sulla sintesi delle evidenze enfatizza l'importanza della validità di costrutto: la capacità di uno strumento di misurare ciò che intende misurare. Se l'operazionalizzazione (il modo di misurare) non si allinea al costrutto teorico (la capacità affermata), l'inferenza è invalida. Il lettore deve cercare nella sezione di discussione se gli autori riconoscono questi presupposti o se presentano l'inferenza come un fatto dimostrato.
Tipi di inferenza nei paper di IA
Classificazione dei salti logici comuni e del loro livello di rischio.
| Tipo di inferenza | Descrizione | Rischio di sovrainterpretazione |
|---|---|---|
| Correlazione a Causalità | Affermare che A causa B perché A e B variano insieme. | Alto |
| Benchmark a Capacità | Affermare che un punteggio alto implica una comprensione profonda del dominio. | Medio-Alto |
| Efficienza a Robustezza | Affermare che un modello veloce è affidabile in condizioni di produzione. | Medio |
Passo 3: Rilevare spiegazioni alternative
La validità interna è compromessa se esistono spiegazioni alternative plausibili per il risultato osservato che non sono state controllate. Negli esperimenti di IA, queste spiegazioni includono spesso: il caso (variabilità statistica), l'overfitting sui dati di valutazione, o l'influenza di iperparametri non ottimizzati nel modello di controllo.
Per auditare questo passo, il lettore deve verificare se il paper riporta intervalli di confidenza o esegue test di significatività statistica. Se i risultati sono presentati come punti unici senza misure di incertezza, è impossibile determinare se la differenza osservata sia reale o un artefatto del rumore. Inoltre, deve essere verificato se sono state controllate le variabili di confusione, come la temperatura di campionamento o la lunghezza dell'input, che potrebbero influenzare le prestazioni del modello.
Checklist di controllo della confusione
Domande per verificare se le variabili alternative sono state controllate.
- 01Vengono riportati intervalli di confidenza o deviazioni standard?
- 02È stato eseguito un'analisi della varianza (ANOVA) o test t?
- 03È stato controllato il caso nell'inizializzazione dei pesi?
- 04Le prestazioni sono state valutate con più semi casuali?
Passo 4: Verificare la portata dell'affermazione
Il quarto passo consiste nel confrontare la conclusione finale del paper con la portata dei dati presentati. Un'affermazione è valida solo se si limita alle condizioni sperimentali in cui è stato condotto lo studio. Se gli autori generalizzano i loro risultati ad altri domini, dimensioni del modello o tipi di dati senza evidenza aggiuntiva, l'affermazione supera la sua portata.
Il framework RAISE, adottato da Cochrane, Campbell, JBI e CEE, stabilisce che la responsabilità ultima dell'integrità della sintesi ricade sull'autore. Ciò implica che l'autore deve giustificare perché i suoi metodi sono appropriati per il contesto specifico e dichiarare i limiti. Durante l'audit, il lettore deve cercare se la sezione sui limiti è onesta e se le conclusioni sono adeguatamente sfumate. Se la conclusione è assoluta ('il modello X è superiore') mentre i dati mostrano solo un vantaggio marginale in un dominio specifico, c'è una discrepanza tra l'evidenza e l'affermazione.
Passo 5: Formulare domande di verifica
Per integrare questo audit nel flusso di lavoro, il lettore deve applicare una serie di domande di verifica sistematiche. Queste domande permettono di distinguere tra osservazioni dirette, interpretazioni e affermazioni non supportate. Le guide istituzionali sulla verifica dei contenuti di IA sottolineano l'importanza di verificare le fonti e dichiarare l'uso degli strumenti, un principio che si trasferisce alla lettura critica: non dare per valido un dato senza verificarne l'origine e il contesto.
L'applicazione di queste domande non richiede una formazione statistica avanzata, ma esige rigore e pazienza. L'obiettivo non è invalidare il lavoro degli autori, ma comprendere con precisione cosa è stato dimostrato e cosa è stato suggerito. Questa distinzione è vitale per prendere decisioni di design informate e per evitare la propagazione di affermazioni errate nella letteratura e nell'industria.
Checklist di audit della catena di evidenza
Domande chiave da applicare durante la lettura di un paper di IA.
| Domanda di verifica | Cosa cercare nel paper |
|---|---|
| La metrica misura ciò che viene affermato? | Definizione della metrica e allineamento con il costrutto teorico. |
| Sono state controllate le variabili di confusione? | Sezione dei metodi e analisi di sensibilità. |
| Vengono riportate misure di incertezza? | Intervalli di confidenza, deviazioni standard, p-valori. |
| La conclusione supera la portata dei dati? | Sezione delle conclusioni e dei limiti. |
| Esistono spiegazioni alternative? | Discussione dei risultati e analisi degli errori. |
Esempi ipotetici e applicazione pratica
Consideriamo un paper che valuta un agente di IA in un task di pianificazione. Il paper riporta che l'agente raggiunge l'obiettivo nel 90% dei casi, contro il 70% di un modello precedente. L'osservazione diretta è il tasso di successo. L'inferenza degli autori è che il nuovo agente 'ha una migliore capacità di pianificazione'. Tuttavia, durante l'audit, si scopre che il set di dati di valutazione contiene solo task di bassa complessità, dove il modello precedente falliva per errori di sintassi, non per mancanza di pianificazione. La spiegazione alternativa è che il nuovo modello è più robusto agli errori di sintassi, non che pianifica meglio. L'affermazione di 'migliore pianificazione' supera la portata dei dati.
In un altro caso, un paper sui modelli di contesto lungo riporta un miglioramento nella coerenza narrativa. La metrica utilizzata è un punteggio automatico di similarità semantica. L'inferenza è che il modello 'capisce meglio la narrazione'. L'audit rivela che la metrica di similarità semantica non cattura la coerenza causale né la struttura argomentativa, solo la ripetizione di termini. Pertanto, l'osservazione non supporta l'affermazione di 'comprensione narrativa'. Questi esempi illustrano come l'applicazione del protocollo in cinque passi permetta di rilevare sovrainterpretazioni comuni nella letteratura di IA.
Questioni aperte
- Le fonti fornite non offrono un framework specifico per l'audit degli esperimenti di IA, ma linee guida generali di verifica e sintesi delle evidenze.
- L'applicazione del protocollo in cinque passi richiede giudizio esperto e non può essere completamente automatizzata, poiché l'identificazione dei presupposti impliciti dipende dal contesto del dominio.
- Non sono disponibili dati quantitativi sulla frequenza della sovrainterpretazione nella letteratura di IA, quindi la prevalenza di questi errori è una stima qualitativa.
Continua a esplorare
Fonti consultate
Correzioni e trasparenza
Se trovi un dato errato o non aggiornato, inviaci la pagina e la fonte da verificare.
Proponi una correzione