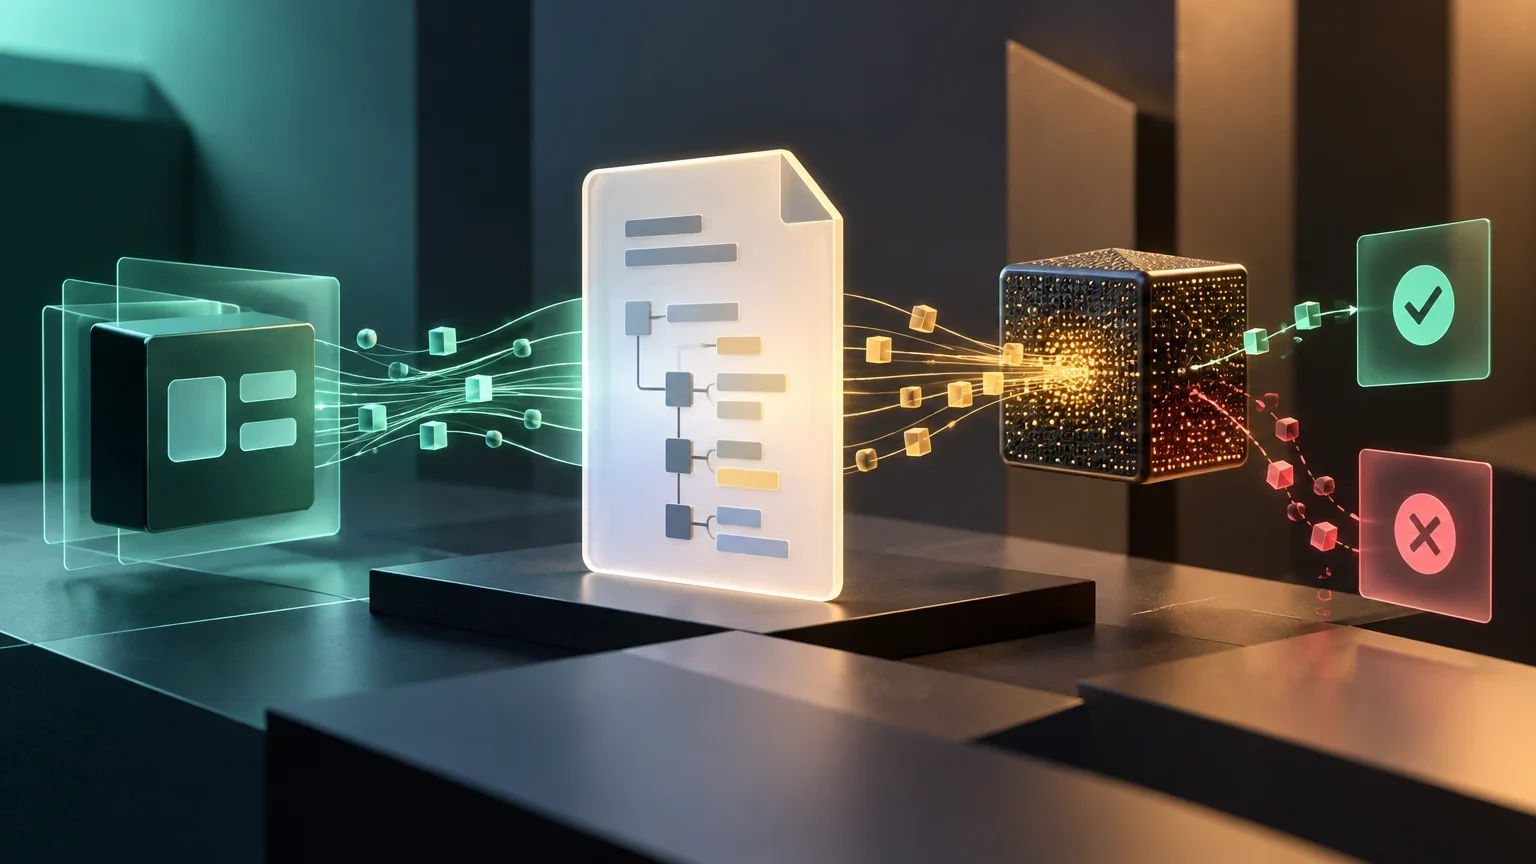
Definizione del contratto di interfaccia: oltre il prompt
Nello sviluppo di applicazioni con IA, l'interfaccia tra la logica di business e il modello non si limita all'istruzione testuale (prompt). Un contratto di interfaccia formale definisce le regole di comunicazione, specificando quali dati entrano, come sono strutturati e cosa ci si aspetta di ricevere in cambio. A differenza di un prompt ad-hoc, che dipende dall'interpretazione del modello, il contratto stabilisce un quadro deterministico che consente la validazione automatica e la rilevazione precoce delle incompatibilità.
La distinzione fondamentale risiede nel separare la specifica di formato dalla specifica di contenuto. Il contratto garantisce che la struttura dei dati sia corretta (tipi, campi obbligatori, vincoli), ma non certifica la veridicità semantica delle informazioni. Questa separazione è critica: un'uscita con struttura corretta non dimostra che il contenuto sia vero, ma consente al sistema di elaborarla senza interrompere il flusso di esecuzione.
L'adozione di un contratto formale trasforma l'integrazione del modello in un componente prevedibile all'interno dell'architettura complessiva. Questo approccio riduce la dipendenza dall'interpretazione contestuale del modello, spostando l'attenzione sulla conformità strutturale dei dati scambiati. Tale separazione consente di isolare i problemi di esecuzione da quelli di generazione, facilitando la manutenzione a lungo termine del sistema e garantendo che le interfacce rimangano stabili anche in presenza di aggiornamenti interni al modello.
La capacità di validare automaticamente la struttura dei dati permette di identificare le incompatibilità prima che queste influenzino la logica di business. Questo meccanismo di difesa non sostituisce la necessità di monitorare la qualità semantica, ma fornisce un livello di sicurezza operativo essenziale. In questo modo, il sistema può gestire in modo deterministico le risposte che rispettano lo schema, mentre isola e segnala quelle che violano le regole di formato, mantenendo l'integrità del flusso di elaborazione.
Differenze tra prompt ad-hoc e contratto formale
Confronto delle caratteristiche chiave per l'integrazione dell'IA.
| Caratteristica | Prompt ad-hoc | Contratto formale |
|---|---|---|
| Validazione | Manuale o inesistente | Automatica e programmatica |
| Struttura | Variabile e imprevedibile | Rigida e definita da schema |
| Manutenzione | Fragile di fronte ai cambiamenti del modello | Versionabile e auditabile |
| Errori | Rilevati in produzione | Rilevati in tempo di esecuzione |
Progettazione della specifica degli input
La specifica degli input deve definire con precisione i dati che il modello riceverà. Ciò include non solo i tipi di dati (interi, stringhe, oggetti), ma anche i vincoli di formato, i valori consentiti e il contesto dinamico. È fondamentale documentare le variabili del prompt affinché qualsiasi sviluppatore possa riprodurre la configurazione senza ambiguità.
Il contesto consentito deve essere delimitato rigorosamente. Il modello non deve ricevere dati fuori ambito o informazioni sensibili non necessarie per il compito specifico. L'identità e l'autorizzazione devono essere gestite in layer deterministici esterni al modello, assicurando che vengano recuperati solo i dati consentiti per la richiesta specifica.
La documentazione dettagliata delle variabili del prompt è fondamentale per garantire la riproducibilità della configurazione da parte di qualsiasi sviluppatore. Questa chiarezza elimina le ambiguità nella definizione dei dati in ingresso, assicurando che ogni istanza del sistema operi con parametri coerenti. La precisione nella specificazione dei tipi di dati e dei vincoli di formato riduce il rischio di errori di configurazione che potrebbero altrimenti manifestarsi solo in fase di esecuzione, rendendo il processo di sviluppo più robusto e controllabile.
La delimitazione rigorosa del contesto consentito assicura che il modello riceva esclusivamente le informazioni necessarie per il compito specifico. Questo approccio minimizza l'esposizione a dati non pertinenti o sensibili, mantenendo l'attenzione del modello focalizzata sull'obiettivo primario. La gestione dell'identità e dell'autorizzazione in layer esterni al modello garantisce che i permessi vengano applicati in modo deterministico, separando la logica di accesso dai processi di inferenza e preservando la sicurezza dei dati.
Progettazione della specifica degli output
La scelta del formato di output (JSON, XML, CSV) deve allinearsi alle esigenze dell'applicazione. JSON è lo standard predominante per la sua leggerezza e compatibilità con la maggior parte dei linguaggi di programmazione. La definizione dello schema di validazione, utilizzando strumenti come JSON Schema o Pydantic, consente di stabilire campi obbligatori, opzionali e vincoli di tipo.
La non determinismo del modello viene gestita all'interno di un contratto deterministico definendo chiaramente quali campi sono invariabili e quali possono variare. I campi opzionali devono essere documentati per evitare che l'assenza di dati venga interpretata come un errore di validazione. L'obiettivo è che il sistema riceva un dato valido e processabile, indipendentemente dalla variabilità semantica del contenuto.
L'allineamento del formato di output alle esigenze dell'applicazione è cruciale per garantire l'efficienza dell'elaborazione successiva. La scelta di JSON come standard predominante si basa sulla sua leggerezza e sulla ampia compatibilità con i linguaggi di programmazione moderni. La definizione precisa dello schema di validazione, attraverso strumenti come JSON Schema o Pydantic, stabilisce chiaramente quali campi sono obbligatori e quali sono opzionali, creando un quadro di riferimento univoco per la verifica della struttura dei dati restituiti dal modello.
La gestione della non determinismo del modello all'interno di un contratto deterministico richiede una chiara distinzione tra campi invariabili e campi variabili. Documentare i campi opzionali è essenziale per evitare che l'assenza di dati venga erroneamente interpretata come un errore di validazione. L'obiettivo finale è garantire che il sistema riceva sempre un dato valido e processabile, indipendentemente dalla variabilità semantica del contenuto, permettendo così una gestione fluida delle risposte del modello senza interruzioni impreviste nel flusso di lavoro.
Implementazione della validazione automatica
La validazione automatica deve essere integrata nel pipeline di inferenza, immediatamente dopo la risposta del modello e prima che i dati raggiungano la logica di business. Questo layer agisce come un filtro che rifiuta qualsiasi uscita che non rispetti lo schema definito, registrando la causa del rifiuto per facilitare la diagnosi.
È cruciale distinguere tra un errore di formato (struttura non valida) e un errore di contenuto (struttura valida ma dati errati). La validazione automatica rileva solo il primo. Il secondo richiede valutazioni di qualità (evals) o revisione umana. Registrare le violazioni dello schema consente di identificare pattern di fallimento nel modello o nella configurazione del prompt.
L'integrazione della validazione automatica nel pipeline di inferenza, immediatamente dopo la risposta del modello, agisce come un filtro critico per la qualità dei dati. Questo layer rifiuta qualsiasi uscita che non rispetti lo schema definito, registrando la causa specifica del rifiuto per facilitare la diagnosi e la risoluzione dei problemi. La registrazione dettagliata delle violazioni dello schema consente di identificare pattern di fallimento ricorrenti, sia nel comportamento del modello sia nella configurazione del prompt, fornendo dati preziosi per l'ottimizzazione continua del sistema.
La distinzione tra errori di formato e errori di contenuto è fondamentale per la corretta gestione delle eccezioni. La validazione automatica rileva esclusivamente i problemi strutturali, mentre gli errori di contenuto richiedono valutazioni di qualità o revisione umana. Questa separazione dei ruoli permette di automatizzare la verifica della struttura, liberando risorse per la valutazione semantica, e garantisce che il sistema possa rispondere in modo appropriato a diverse tipologie di fallimento, mantenendo l'affidabilità dell'intero processo di inferenza.
Flusso di validazione nel pipeline
Passaggi per integrare la validazione degli schemi.
- 01Ricevere la risposta grezza dal modello
- 02Tentare di analizzare la risposta nel formato atteso (es. JSON)
- 03Validare la struttura contro lo schema (JSON Schema/Pydantic)
- 04Se fallisce: registrare l'errore di formato ed eseguire il fallback
- 05Se passa: passare i dati alla logica di business
Test di integrazione dell'interfaccia
I test di integrazione devono verificare la conformità dello schema, non la qualità semantica del contenuto. Ciò implica progettare un insieme di test che includa risposte del modello che rispettino lo schema ma contengano dati assurdi, per verificare che la validazione di formato non si confonda con la validazione di contenuto.
Si consiglia di simulare le risposte del modello per testare la robustezza del validatore. Ciò consente di misurare il tasso di rifiuto per formato e di rilevare vulnerabilità nella definizione del contratto. I test devono essere ripetibili e basati su un dataset rappresentativo che includa casi normali, di bordo e input incompleti.
I test di integrazione focalizzati sulla conformità dello schema, piuttosto che sulla qualità semantica, sono essenziali per verificare la robustezza del validatore. Progettare un insieme di test che includa risposte strutturalmente valide ma semanticamente assurde permette di confermare che la validazione di formato non si confonda con la valutazione del contenuto. Questo approccio assicura che il sistema accetti correttamente i dati conformi allo schema, indipendentemente dalla loro veridicità o coerenza logica, mantenendo la separazione tra i livelli di validazione.
La simulazione delle risposte del modello consente di misurare il tasso di rifiuto per formato e di rilevare eventuali vulnerabilità nella definizione del contratto. L'utilizzo di un dataset rappresentativo, che includa casi normali, di bordo e input incompleti, garantisce che i test siano ripetibili e affidabili. Questa metodologia di testing permette di identificare precocemente le debolezze nell'implementazione della validazione, assicurando che il contratto di interfaccia sia in grado di gestire efficacemente la variabilità delle uscite del modello in condizioni operative reali.
Matrice dei test di validazione
Casi di test per verificare la robustezza del contratto.
| Caso di test | Input simulato | Risultato atteso |
|---|---|---|
| Struttura valida, contenuto assurdo | {"id": 123, "name": "xyz"} | Passa la validazione |
| Campo obbligatorio assente | {"name": "test"} | Fallisce la validazione |
| Tipo di dato errato | {"id": "123"} | Fallisce la validazione |
| JSON malformato | {id: 123} | Fallisce l'analisi |
Gestione delle eccezioni e dei casi di bordo
Il contratto deve definire il comportamento di fronte a uscite non valide. Le opzioni includono il retry limitato, l'uso di un modello alternativo o la derivazione a un processo manuale. Documentare questi limiti è essenziale per la manutenzione e l'operatività del sistema.
La versioning dell'interfaccia consente di gestire i cambiamenti nello schema senza rompere la compatibilità. Quando si aggiorna il modello o il prompt, i test di regressione devono essere eseguiti per verificare che il nuovo comportamento continui a rispettare il contratto. Ciò facilita l'audit dell'integrità dell'interfaccia e la tracciabilità dei cambiamenti.
La definizione chiara del comportamento in caso di uscite non valide è un aspetto cruciale per la resilienza del sistema. Le strategie di gestione delle eccezioni, come il retry limitato, l'uso di un modello alternativo o la derivazione a un processo manuale, devono essere documentate per garantire la continuità operativa. Questa pianificazione proattiva dei casi di bordo assicura che il sistema possa rispondere in modo prevedibile ai fallimenti, minimizzando l'impatto sulla logica di business e mantenendo la stabilità dell'interfaccia anche in condizioni di anomalia.
La versioning dell'interfaccia consente di gestire i cambiamenti nello schema senza compromettere la compatibilità esistente. L'esecuzione di test di regressione durante gli aggiornamenti del modello o del prompt verifica che il nuovo comportamento continui a rispettare il contratto definito. Questo processo facilita l'audit dell'integrità dell'interfaccia e la tracciabilità dei cambiamenti, garantendo che ogni modifica sia documentata e validata, preservando così l'affidabilità e la sicurezza dell'integrazione nel lungo periodo.
Questioni aperte
- L'evidenza non specifica uno standard unico obbligatorio per i contratti di IA, quindi la guida si basa su buone pratiche secondarie e quadri normativi generali.
- Non è stata verificata l'efficacia comparativa di JSON Schema rispetto a Pydantic in ambienti di alta concorrenza per modelli di IA specifici.
Continua a esplorare
Fonti consultate
Correzioni e trasparenza
Se trovi un dato errato o non aggiornato, inviaci la pagina e la fonte da verificare.
Proponi una correzione