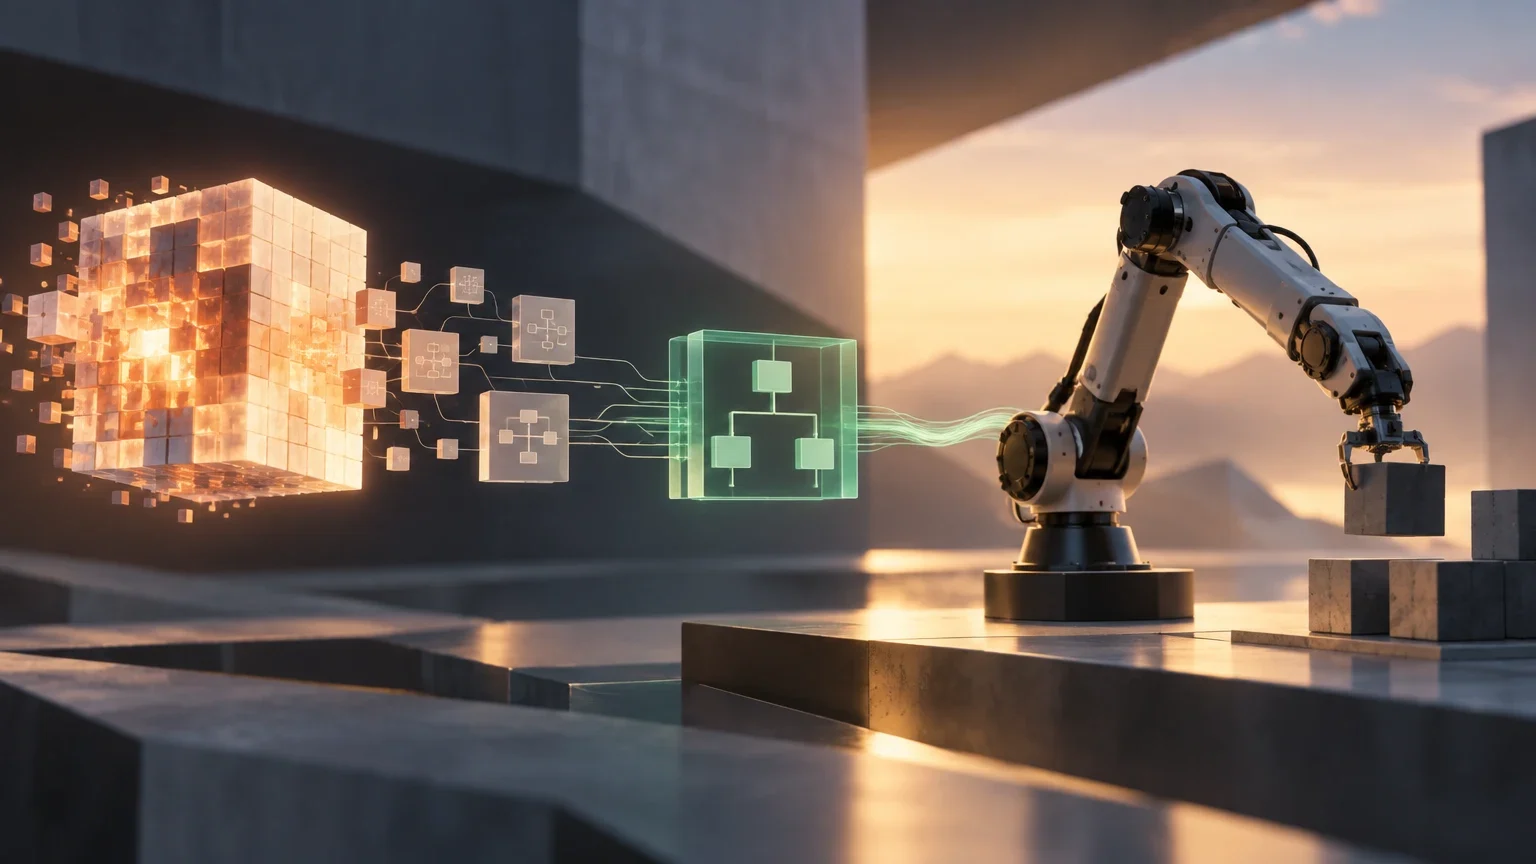
Der Ansatz: Die Arbeit des LLM in die Entwurfsphase verlagern
Wird ein Sprachmodell wiederholt dazu eingesetzt, die nächste Aktion eines Agenten auszuwählen, kann dadurch zusätzliche Latenz entstehen: Jede Entscheidung hängt dann von einer neuen Inferenz ab. Ein anderer Ansatz besteht darin, ein Weltmodell zu erzeugen und damit zu planen. Doch auch dabei kann für jede einzelne Entscheidung eine neue Planung erforderlich sein. Der Preprint Code to Control schlägt eine Alternative vor: Ein LLM erstellt die Struktur eines Controllers, dessen Parameter anschließend anhand von Rückmeldungen aus der Umgebung angepasst werden.
Diese Unterscheidung ist wichtig. Das Sprachmodell wirkt an der Erstellung des Programms mit, muss dem Abstract der Arbeit zufolge aber nicht erneut eingreifen, sobald der Controller gelernt hat. Das Ergebnis ist ein Python-Controller, der direkt als Policy ausgeführt wird: Er erhält die verfügbare Situation und gibt eine Aktion aus. Das ist nicht dasselbe, wie das LLM bei jeder Bewegung erneut um eine Schlussfolgerung zu bitten.
Der Ansatz betrifft damit sowohl den Entwurf als auch die Ausführung. Die Programmstruktur legt fest, welche Operationen oder Zusammenhänge Teil der Policy sein können; die Parameter bestimmen Werte, die für die jeweilige Aufgabe angepasst werden. Aus dem Abstract geht nicht hervor, welche konkreten Strukturen erzeugt werden oder welche Einschränkungen für den Code gelten. Deshalb lässt sich nicht genauer sagen, wie viel der Logik für die Suche offensteht.
Zwei Phasen: das Programm erzeugen und seine Parameter anpassen
In der ersten Phase synthetisiert ein LLM die Struktur des Controllers. In der zweiten Phase passt eine gradientenfreie Suche dessen Parameter für die kontinuierliche Steuerung an und nutzt dazu Rückmeldungen aus der Umgebung. Allgemein gesagt erprobt eine gradientenfreie Suche verschiedene Varianten und verwendet die erhaltene Bewertung, um die Anpassung zu steuern, ohne Ableitungen zu berechnen. Der Abstract nennt weder den konkreten Algorithmus noch das Auswertungsbudget oder die genaue Art, wie Rückmeldungen in eine Bewertung umgewandelt werden.
Die Rückmeldung ist wichtig, weil sie die Anpassung mit dem beobachteten Verhalten verknüpft. Der Controller wird bei Interaktionen mit der Umgebung bewertet, und die Methode verändert seine Parameter anhand dieses Signals. Die vorliegende Beschreibung sagt jedoch nicht, ob es sich bei dem Signal um eine Belohnung, ein Erfolgsmaß oder eine andere Kombination handelt. Auch bleibt offen, wie mit Schwankungen oder Fehlschlägen während der Tests umgegangen wird.
Diese Trennung kann die Abhängigkeit von LLM-Abfragen während der Ausführung verringern, beseitigt aber nicht die Kosten für die Erstellung und das Training des Controllers. Die Programmerzeugung und die Parametersuche finden vor dem gelernten Einsatz statt, den der Abstract beschreibt. Dass der Controller also nicht bei jeder Entscheidung das LLM aufruft, bedeutet nicht, dass der gesamte Prozess sofort oder kostengünstig ist.
Der im Preprint beschriebene Ablauf
- 01Das LLM schlägt die Struktur eines Python-Controllers vor.
- 02Eine gradientenfreie Suche passt dessen Parameter mithilfe von Rückmeldungen aus der Umgebung an.
- 03Der gelernte Controller wird als Policy ausgeführt – dem Abstract zufolge ohne LLM-Inferenz und ohne Planung bei jeder Entscheidung.
Was es bedeutet, ohne Planung bei jedem Schritt auszuführen
Eine reaktive Policy erzeugt eine Aktion auf Grundlage der Situation, die sie erhält. Sie muss also nicht zwingend für jede Bewegung erneut nach einem Plan suchen. Bei Code to Control beschreibt der Abstract die gelernten Controller als direkt ausführbare Policies. Der praktische Vorteil, den die Autoren daraus ableiten, ist, dass Entscheidungen weder einen Aufruf des LLM noch eine Planungsphase für jeden einzelnen Schritt erfordern.
Daraus folgt nicht, dass die Ausführung immer schneller ist als jede denkbare Alternative. Der Abstract berichtet, dass die Aktionsauswahl unter dem verwendeten Messprotokoll schneller ist als bei einer PPO-Policy. PPO ist ein Verfahren des Reinforcement Learning. Der angegebene Vergleich ist als Ergebnis unter diesem Protokoll zu verstehen, nicht als allgemeingültige Aussage über alle Modelle, Geräte, Aufgaben oder Implementierungen.
In den verfügbaren Informationen werden weder die gemessene Zeit noch die Hardware, der Vorbereitungsaufwand oder die nötigen Einzelheiten genannt, um den Vergleich zu reproduzieren. Die Geschwindigkeitsbehauptung ist relevant, doch ohne diese Angaben lässt sich weder ihre Größenordnung einschätzen noch feststellen, wie stark sie von der experimentellen Konfiguration abhängt.
Phasen und ihre Kosten richtig einordnen
| Phase | Zugeschriebene Funktion | Was aus dem Abstract nicht hervorgeht |
|---|---|---|
| Synthese | Das LLM erzeugt die Struktur des Controllers. | Welche Einschränkungen für den Code gelten und wie hoch die Kosten der Generierung sind. |
| Anpassung | Eine gradientenfreie Suche passt Parameter anhand von Rückmeldungen aus der Umgebung an. | Der genaue Algorithmus, das Testbudget und die detaillierte Form des Signals. |
| Gelernte Ausführung | Der Controller handelt direkt, dem Abstract zufolge ohne Aufrufe des LLM und ohne Planung bei jeder Entscheidung. | Die absolute Latenz, die Robustheit und das Verhalten auf physischer Hardware. |
Welche Tests genannt werden und welche Vergleiche berichtet werden
Laut Abstract wurde die Methode in einer Sammlung von Atari-Spielen, in Flappy Bird und bei MuJoCo-Aufgaben evaluiert. Außerdem heißt es, Code to Control übertreffe planungsbasierte Verfahren zur Programmsynthese, bleibe gegenüber Deep Reinforcement Learning konkurrenzfähig und benötige dabei weniger Interaktionen mit der Umgebung. Darüber hinaus wird berichtet, dass die Methode auch bei erheblichen Änderungen der Umgebungsdynamik übertragbar bleibt. Erwähnt werden zudem komplexe Fortbewegungsaufgaben.
Dabei handelt es sich um Aussagen im Abstract des Preprints und nicht um Kennzahlen, die sich anhand der hier bereitgestellten Informationen überprüfen lassen. Die konkreten Spiele, die Anzahl der Aufgaben, die Metriken, die Ergebnisse für einzelne Aufgaben und die Bedeutung von „konkurrenzfähig“ werden nicht aufgeführt. Ebenso fehlen Angaben zum Umfang der Änderungen an der Dynamik, mit denen die Übertragbarkeit geprüft wurde. Daher lässt sich die allgemeine Beschreibung weder in einen quantitativen Vergleich übersetzen noch beurteilen, ob das Ergebnis über alle Aufgaben hinweg einheitlich ausfällt.
Auch die unterschiedlichen Vergleichsgruppen müssen auseinandergehalten werden. Der Abstract unterscheidet einerseits planungsabhängige Verfahren zur Programmsynthese und andererseits Deep Reinforcement Learning. Gegenüber der ersten Gruppe wird ein Vorteil behauptet; gegenüber der zweiten soll die Methode bei weniger Interaktionen konkurrenzfähig sein. Es wird nicht behauptet, dass sie bei allen Metriken jedes Deep-Reinforcement-Learning-Verfahren schlägt.
Um die Evidenz einzuschätzen, wären aufgeschlüsselte Ergebnisse, Angaben zur Konfiguration und detaillierte Evaluationsprotokolle nötig. Die vorliegenden Informationen reichen nicht aus, um zu prüfen, ob der Code, trainierte Controller oder experimentelle Daten verfügbar sind. Die Reproduzierbarkeit bleibt daher unbestätigt.
Der noch ausstehende Schritt: von getesteten Aufgaben zu realen Robotern
Zu den genannten Umgebungen gehören Spiele und MuJoCo-Aufgaben. Aus dem Abstract geht jedoch nicht hervor, dass die Tests mit physischen Robotern durchgeführt wurden. MuJoCo ist der Name der vom Preprint angeführten Aufgaben; die verfügbaren Informationen erlauben weder, hier ein bestimmtes Protokoll zuzuschreiben, noch daraus auf einen Einsatz in der realen Welt zu schließen. Eine Demonstration in Evaluationsumgebungen reicht für sich genommen nicht aus, um ein physisches Steuerungssystem zu zertifizieren.
Der Abstract behauptet zwar, dass die Methode bei erheblichen Änderungen der Umgebungsdynamik übertragbar bleibt. Das ist ein Hinweis auf Generalisierung unter den untersuchten Bedingungen, doch die konkreten Änderungen, die Grenzen der Tests und beobachtete Fehler werden hier nicht beschrieben. Diese Aussage ist nicht mit Robustheit gegenüber beliebigen Störungen, ungenauen Sensoren, Verzögerungen, Verschleiß oder nicht untersuchten Sicherheitsbedingungen gleichzusetzen.
Für einen möglichen physischen Einsatz müsste unter anderem bekannt sein, wie der generierte Code validiert wird, welche Aktionsgrenzen gelten, wie auf unerwartete Situationen reagiert wird und welche Sicherheitstests durchgeführt wurden. Keine dieser Einzelheiten findet sich im bereitgestellten Abstract. Es lässt sich daher weder behaupten, dass die Methode solche Fragen löst, noch dass sie für einen Einsatz bereit ist.
Was sich ändert und worauf es zu achten gilt
Die konzeptionelle Änderung besteht darin, die Synthese des Controllers von seiner wiederholten Nutzung zu trennen. Das LLM hilft beim Erstellen des Programms; eine gradientenfreie Suche passt dessen Parameter mithilfe von Rückmeldungen an; und der daraus hervorgehende Controller handelt der Beschreibung der Arbeit zufolge direkt. Sollte sich dieser Ansatz in reproduzierbaren Tests bestätigen, könnte er für Aufgaben interessant sein, bei denen die Latenz einer Modellabfrage bei jedem Schritt ein Hindernis darstellt.
Vorerst sollte die Schlussfolgerung jedoch begrenzt bleiben. Der Preprint berichtet über Tests mit Spielen, Flappy Bird und MuJoCo-Aufgaben sowie über Vergleiche mit planungsbasierter Synthese und Deep Reinforcement Learning. Die bereitgestellten Informationen erlauben es nicht, die Metriken zu überprüfen, den Geschwindigkeitsvorteil zu beziffern oder die Verfügbarkeit von Code festzustellen. Ebenso wenig belegen sie einen Einsatz auf physischen Robotern.
Wer das Thema weiterverfolgen möchte, sollte diese Meldung von einem allgemeinen Vergleich verschiedener Steuerungsverfahren unterscheiden: Der Abstract präsentiert Ergebnisse zu einem konkreten Ansatz und kein vollständiges Ranking. Auch die Nachrichten und Entdeckungsinhalte können helfen, künftige Veröffentlichungen einzuordnen. Diese weitere Orientierung ist jedoch nicht als zusätzliche experimentelle Evidenz zu verstehen.
Offene Fragen
- Es liegen keine detaillierten Metriken, Ergebnisse einzelner Aufgaben, Hardwareangaben oder absoluten Zeitmessungen vor, anhand derer sich Aussagen zu Leistung und Latenz beurteilen ließen.
- Der Abstract nennt weder den Algorithmus der gradientenfreien Suche noch das Interaktionsbudget oder die genaue Form der Rückmeldung aus der Umgebung.
- Die konkreten Spiele und Aufgaben sowie die Bedingungen der Übertragungstests werden nicht spezifiziert.
- Die bereitgestellten Informationen bestätigen nicht, ob Code, Controller oder Daten zur Reproduktion der Experimente verfügbar sind.
- Es wird nicht belegt, dass Tests mit physischen Robotern durchgeführt wurden; außerdem werden keine Sicherheitsprüfungen für einen realen Einsatz beschrieben.
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen