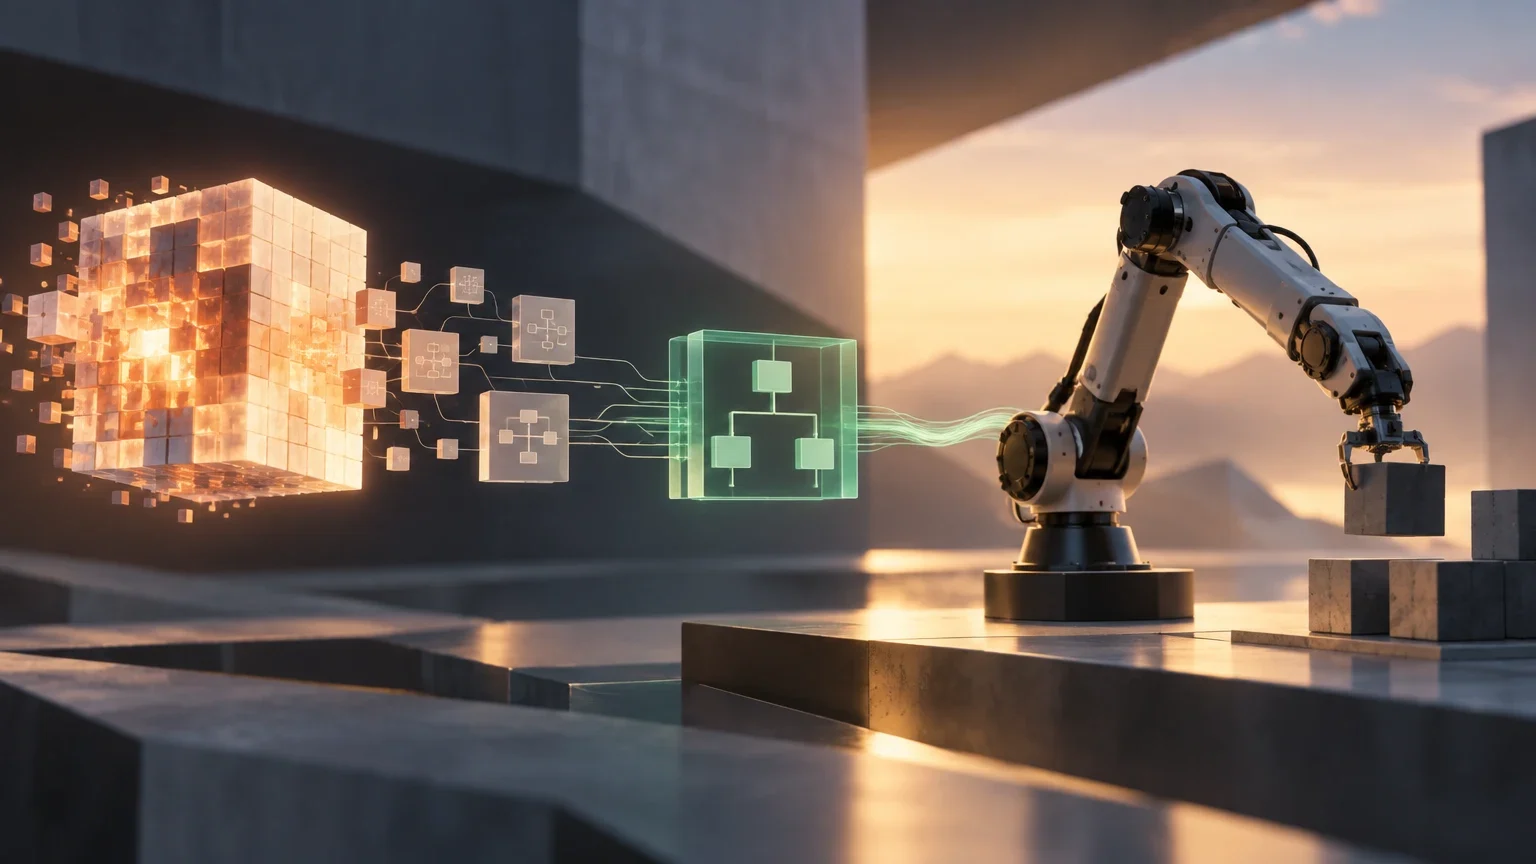
La proposta: spostare il lavoro dell’LLM alla fase di progettazione
Usare un modello linguistico per scegliere ripetutamente l’azione di un agente può introdurre latenza: ogni decisione dipende da una nuova inferenza. Un’altra famiglia di approcci genera un modello del mondo e pianifica al suo interno, ma può richiedere comunque una pianificazione a ogni decisione. Il preprint Code to Control propone un’alternativa: usare l’LLM per creare la struttura di un controllore e poi regolarne i parametri sulla base delle informazioni ottenute dall’ambiente.
La distinzione è importante. Il modello linguistico contribuisce alla costruzione del programma, ma, secondo l’abstract del lavoro, non deve intervenire di nuovo una volta che il controllore è stato appreso. Il risultato è un controllore Python che viene eseguito direttamente come policy: riceve lo stato disponibile e produce un’azione. Non è come chiedere all’LLM di ragionare di nuovo a ogni movimento.
La proposta affronta quindi insieme un problema di progettazione e uno di esecuzione. La struttura del programma definisce quali operazioni o relazioni possono far parte della policy; i parametri determinano i valori regolati per il compito. L’abstract non specifica quali strutture vengano generate né quali vincoli siano imposti al codice. Non è quindi possibile precisare quanta parte della logica resti aperta alla ricerca.
Due fasi: generare il programma e regolarne i parametri
Nella prima fase, un LLM sintetizza la struttura del controllore. Nella seconda, una ricerca senza gradienti ne regola i parametri per il controllo continuo, usando il feedback dell’ambiente. In termini generali, una ricerca senza gradienti prova diverse varianti e usa le valutazioni ricevute per orientare la regolazione senza calcolare derivate. L’abstract non indica l’algoritmo specifico, il budget di valutazioni né il modo esatto in cui il feedback viene convertito in un punteggio.
Il feedback è importante perché collega la regolazione al comportamento osservato. Il controllore viene valutato interagendo con l’ambiente e il metodo modifica i parametri in base al segnale ottenuto. La descrizione disponibile, tuttavia, non specifica se il segnale sia una ricompensa, una misura di successo o un’altra combinazione, né come vengano gestiti la variabilità o i fallimenti durante i test.
Questa separazione può ridurre la dipendenza dalle interrogazioni dell’LLM durante l’esecuzione, ma non elimina il costo di costruzione e addestramento del controllore. La generazione del programma e la ricerca dei parametri avvengono prima dell’uso del controllore appreso descritto nell’abstract. Perciò, affermare che il controllore non interroga l’LLM a ogni decisione non equivale a dire che l’intero processo sia istantaneo o poco costoso.
Flusso descritto nel preprint
- 01L’LLM propone la struttura di un controllore Python.
- 02La ricerca senza gradienti regola i parametri usando il feedback dell’ambiente.
- 03Secondo l’abstract, il controllore appreso viene eseguito come policy senza inferenza dell’LLM né pianificazione a ogni decisione.
Che cosa significa eseguire senza pianificare a ogni passo
Una policy reattiva produce un’azione a partire dallo stato che riceve, anziché dipendere necessariamente da una nuova ricerca di piani per ogni movimento. In Code to Control, l’abstract descrive i controllori appresi come policy eseguibili direttamente. La conseguenza pratica prospettata dagli autori è che le decisioni non richiedono una chiamata all’LLM né una fase di pianificazione a ogni passo.
Questo non consente di concludere che l’esecuzione sia sempre più rapida di qualsiasi alternativa. L’abstract riporta una selezione delle azioni più veloce rispetto a una policy PPO secondo il protocollo di misurazione adottato. PPO è un metodo di apprendimento per rinforzo; il confronto riportato va letto come un risultato ottenuto con quel protocollo, non come una regola universale valida per tutti i modelli, i dispositivi, i compiti o le implementazioni.
Le informazioni disponibili non riportano neppure il tempo misurato, l’hardware, i costi di preparazione o i dettagli necessari per riprodurre il confronto. L’affermazione sulla velocità è rilevante, ma senza questi dati non se ne può stimare l’entità né capire quanto dipenda dalla configurazione sperimentale.
Come interpretare le fasi e i relativi costi
| Fase | Funzione attribuita | Che cosa non è stabilito nell’abstract |
|---|---|---|
| Sintesi | L’LLM genera la struttura del controllore. | I vincoli sul codice e il costo della generazione. |
| Regolazione | Una ricerca senza gradienti adatta i parametri usando il feedback dell’ambiente. | L’algoritmo esatto, il budget di test e il segnale dettagliato. |
| Esecuzione dopo l’apprendimento | Secondo l’abstract, il controllore agisce direttamente senza chiamate all’LLM né pianificazione a ogni decisione. | La latenza assoluta, la robustezza e il comportamento su hardware fisico. |
Quali test menziona e quali confronti riporta
L’abstract colloca la valutazione in una raccolta di giochi Atari, in Flappy Bird e in compiti di MuJoCo. Afferma inoltre che Code to Control supera i metodi di sintesi di programmi basati sulla pianificazione, mantiene risultati competitivi rispetto all’apprendimento per rinforzo profondo usando meno interazioni con l’ambiente e si trasferisce in presenza di cambiamenti sostanziali nella dinamica dell’ambiente. Menziona anche compiti complessi di locomozione.
Si tratta di affermazioni riportate nell’abstract del preprint, non di risultati numerici verificabili sulla base delle informazioni fornite qui. Non vengono specificati i singoli giochi, il numero di compiti, le metriche, i risultati per ciascun compito né la definizione di «competitivo». Non è indicata neppure l’entità dei cambiamenti dinamici usati per valutare il trasferimento. Non è quindi possibile trasformare la descrizione generale in un confronto quantitativo né stabilire se il risultato sia uniforme tra i diversi compiti.
È importante mantenere distinta la natura dei comparatori. Da un lato, l’abstract considera i metodi di sintesi di programmi che richiedono pianificazione; dall’altro, l’apprendimento per rinforzo profondo. Riporta un vantaggio rispetto ai primi e prestazioni competitive rispetto al secondo gruppo con un numero inferiore di interazioni; non afferma che il metodo prevalga su tutti i metodi di apprendimento profondo in ogni metrica.
Per valutare l’evidenza servirebbero risultati suddivisi per compito, dettagli sulla configurazione e protocolli di valutazione. Le informazioni fornite non consentono di verificare se siano disponibili il codice, i controllori addestrati o i dati sperimentali. Di conseguenza, la riproducibilità resta da confermare.
Il passaggio ancora da dimostrare: dai compiti valutati ai robot reali
Tra gli ambienti citati figurano giochi e compiti di MuJoCo, ma l’abstract non afferma che i test siano stati svolti su robot fisici. MuJoCo è il nome della raccolta di compiti menzionata dal preprint; le informazioni disponibili non consentono di attribuirle qui un protocollo specifico né di concludere che i risultati implichino un impiego reale. Una dimostrazione in ambienti di valutazione, da sola, non basta a certificare un sistema di controllo fisico.
L’abstract afferma che il metodo si trasferisce anche in presenza di cambiamenti importanti nella dinamica dell’ambiente. È un’indicazione di generalizzazione nelle condizioni studiate, ma qui non vengono descritti i cambiamenti, i limiti messi alla prova o i malfunzionamenti osservati. Non bisogna confondere questa affermazione con una robustezza garantita di fronte a qualsiasi perturbazione, a sensori imperfetti, ritardi, usura o condizioni di sicurezza non valutate.
Per prendere in considerazione un’applicazione fisica, servirebbe sapere, tra le altre cose, come viene convalidato il codice generato, quali limiti sono imposti alle azioni, come si risponde alle situazioni impreviste e quali test di sicurezza sono stati effettuati. Nessuno di questi dettagli è presente nell’abstract fornito. Non è possibile affermare che il metodo li risolva o che sia pronto per l’impiego.
Che cosa cambia e che cosa conviene osservare
Il cambiamento concettuale consiste nel separare la sintesi del controllore dal suo uso ripetuto. L’LLM contribuisce a costruire il programma; la ricerca senza gradienti ne regola i parametri usando il feedback; infine, secondo la descrizione del lavoro, il controllore risultante agisce direttamente. Se venisse confermata da valutazioni riproducibili, questa architettura potrebbe essere utile nei compiti in cui la latenza di interrogare un modello a ogni passo rappresenta un ostacolo.
Per ora, la conclusione deve restare circoscritta. Il preprint riferisce test su giochi, Flappy Bird e compiti di MuJoCo, oltre a confronti con la sintesi basata sulla pianificazione e con l’apprendimento per rinforzo profondo. Le informazioni fornite non permettono di verificare le metriche, quantificare il vantaggio in velocità o stabilire se il codice sia disponibile. Non dimostrano neppure l’impiego su robot fisici.
Per seguire l’argomento, è utile distinguere questa notizia da un confronto generale tra metodi di controllo: l’abstract presenta i risultati di una proposta specifica, non una classifica completa. È possibile consultare anche le notizie e i contenuti di approfondimento per contestualizzare le pubblicazioni future, senza considerarli ulteriori prove sperimentali.
Questioni aperte
- Non sono disponibili metriche dettagliate, risultati per singolo compito, informazioni sull’hardware o tempi assoluti per valutare le affermazioni su prestazioni e latenza.
- L’abstract non identifica l’algoritmo di ricerca senza gradienti, il budget di interazioni né la forma esatta del feedback dell’ambiente.
- Non sono specificati i singoli giochi, i compiti particolari né le condizioni dei test di trasferimento.
- Le informazioni fornite non confermano che siano disponibili codice, controllori o dati con cui riprodurre gli esperimenti.
- Non è stabilito che i test siano stati svolti su robot fisici e non vengono descritte valutazioni di sicurezza per un impiego reale.
Continua a esplorare
Fonti consultate
Correzioni e trasparenza
Se trovi un dato errato o non aggiornato, inviaci la pagina e la fonte da verificare.
Proponi una correzione