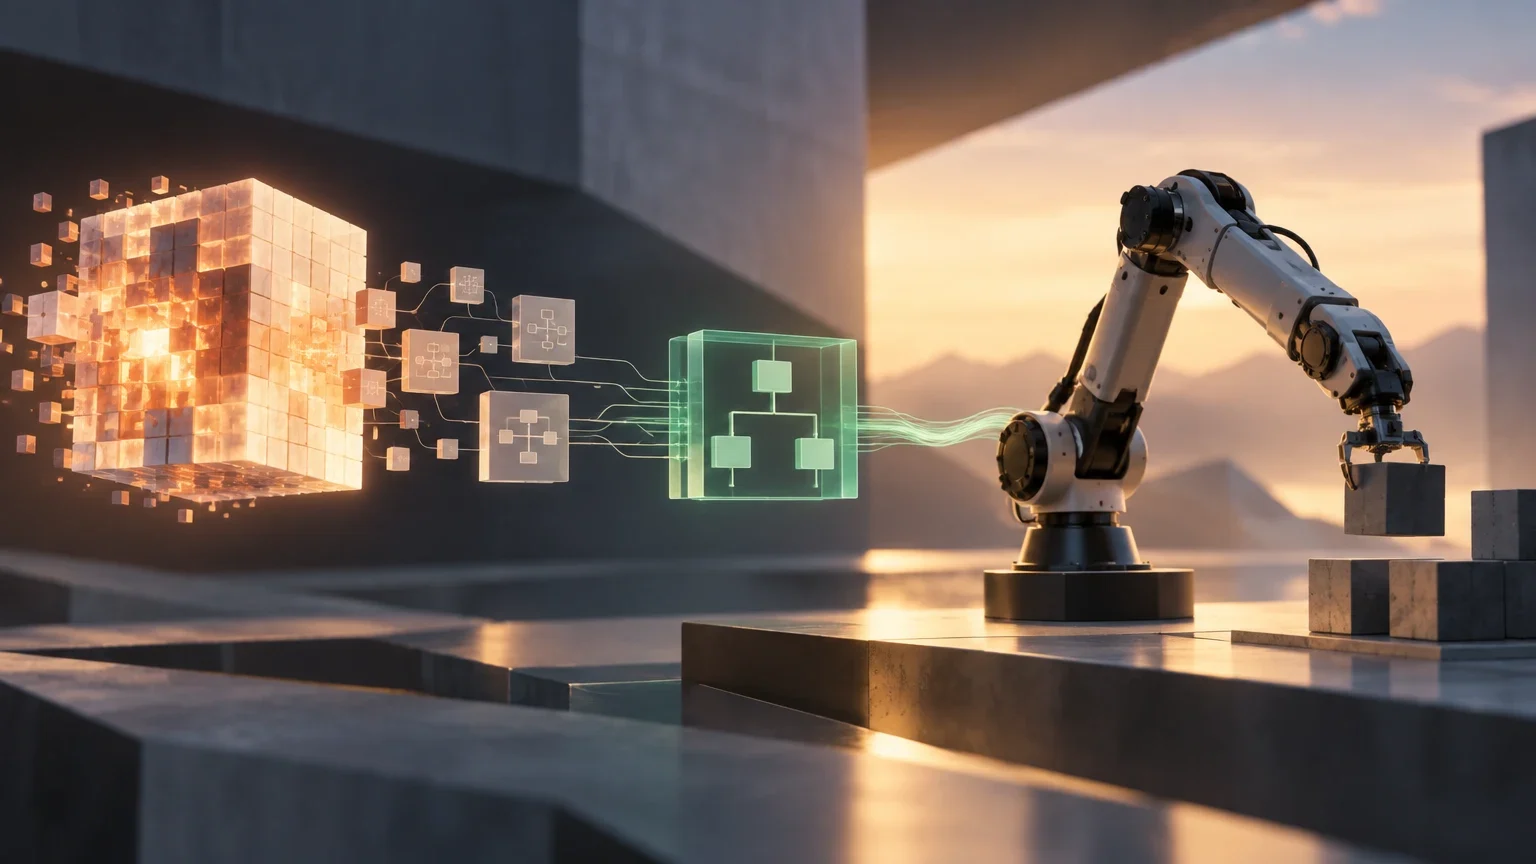
La propuesta: trasladar el trabajo del LLM a la fase de diseño
Usar un modelo de lenguaje para elegir la acción de un agente una y otra vez puede añadir latencia: cada decisión depende de una nueva inferencia. Otra familia de enfoques genera un modelo del mundo y planifica con él, pero también puede requerir planificación en cada decisión. El preprint Code to Control plantea una alternativa: recurrir al LLM para crear la estructura de un controlador y ajustar después sus parámetros con información obtenida del entorno.
La distinción es importante. El modelo de lenguaje participa en la construcción del programa, pero, según el resumen del trabajo, no tiene que volver a intervenir cuando el controlador ya está aprendido. El resultado es un controlador Python que se ejecuta directamente como política: recibe la situación disponible y produce una acción. No es lo mismo que pedirle al LLM que razone de nuevo en cada movimiento.
La propuesta aborda así un problema de diseño y ejecución a la vez. La estructura del programa define qué operaciones o relaciones pueden formar parte de la política; los parámetros determinan valores que se ajustan para la tarea. El resumen no detalla qué estructuras concretas se generan ni qué restricciones se imponen al código, por lo que no se puede precisar cuánto de la lógica queda abierto a la búsqueda.
Dos fases: generar el programa y ajustar sus parámetros
En la primera fase, un LLM sintetiza la estructura del controlador. En la segunda, una búsqueda sin gradientes ajusta sus parámetros para control continuo, utilizando retroalimentación del entorno. En términos generales, una búsqueda sin gradientes prueba variantes y usa la evaluación recibida para orientar el ajuste sin calcular derivadas. El resumen no identifica el algoritmo concreto, su presupuesto de evaluaciones ni el modo exacto de convertir la retroalimentación en una puntuación.
La retroalimentación importa porque conecta el ajuste con el comportamiento observado. El controlador se evalúa al interactuar con el entorno y el método modifica sus parámetros según esa señal. Sin embargo, la descripción disponible no especifica si la señal es una recompensa, una medida de éxito u otra combinación, ni cómo se tratan la variabilidad o los fallos durante las pruebas.
Esta separación puede reducir la dependencia de consultas al LLM durante la ejecución, pero no elimina el coste de construir y entrenar el controlador. La generación del programa y la búsqueda de parámetros ocurren antes del uso aprendido que describe el resumen. Por tanto, decir que el controlador no invoca al LLM en cada decisión no equivale a decir que el proceso completo sea instantáneo o barato.
Flujo descrito en el preprint
- 01El LLM propone la estructura de un controlador Python.
- 02La búsqueda sin gradientes ajusta sus parámetros con retroalimentación del entorno.
- 03El controlador aprendido se ejecuta como política, sin inferencia del LLM ni planificación en cada decisión, según el resumen.
Qué significa ejecutar sin planificar en cada paso
Una política reactiva produce una acción a partir de la situación que recibe, en vez de depender necesariamente de una búsqueda de planes nueva para cada movimiento. En Code to Control, el resumen caracteriza los controladores aprendidos como políticas ejecutables directamente. La consecuencia práctica que proponen los autores es que las decisiones no requieren una llamada al LLM ni una fase de planificación por paso.
Esto no permite concluir que la ejecución sea siempre más rápida que cualquier alternativa. El resumen informa de una selección de acciones más rápida que una política PPO bajo su protocolo de medición. PPO es un método de aprendizaje por refuerzo; la comparación comunicada debe leerse como un resultado bajo ese protocolo, no como una regla universal sobre todos los modelos, equipos, tareas o implementaciones.
Tampoco se proporciona en la información disponible el tiempo medido, el hardware, el coste de preparación ni los detalles necesarios para reproducir la comparación. La afirmación de rapidez resulta relevante, pero sin esos datos no se puede estimar su magnitud ni saber cuánto depende de la configuración experimental.
Cómo interpretar las fases y sus costes
| Fase | Función atribuida | Qué no queda establecido en el resumen |
|---|---|---|
| Síntesis | El LLM genera la estructura del controlador. | Las restricciones del código y el coste de generación. |
| Ajuste | Una búsqueda sin gradientes adapta parámetros con retroalimentación del entorno. | El algoritmo exacto, el presupuesto de pruebas y la señal detallada. |
| Ejecución aprendida | El controlador actúa directamente, sin llamadas al LLM ni planificación en cada decisión, según el resumen. | La latencia absoluta, la robustez y el comportamiento en hardware físico. |
Qué pruebas menciona y qué comparaciones comunica
El resumen sitúa la evaluación en una colección de juegos de Atari, Flappy Bird y tareas de MuJoCo. También afirma que Code to Control supera métodos de síntesis de programas basados en planificación, mantiene resultados competitivos frente al aprendizaje por refuerzo profundo usando menos interacciones con el entorno, y se transfiere ante cambios sustanciales en la dinámica del entorno. Además, menciona tareas complejas de locomoción.
Estas son afirmaciones del resumen del preprint, no cifras que puedan verificarse con los datos suministrados aquí. No se detallan los juegos concretos, la cantidad de tareas, las métricas, los resultados por tarea ni la definición de «competitivo». Tampoco se incluye el tamaño de los cambios dinámicos usados para evaluar la transferencia. Por eso, no es posible convertir la descripción general en una comparación cuantitativa ni saber si el resultado es uniforme entre tareas.
La diferencia entre comparadores también debe conservarse. El resumen distingue los métodos de síntesis de programas que requieren planificación, por un lado, y el aprendizaje por refuerzo profundo, por otro. Señala una ventaja frente a los primeros y competitividad frente al segundo grupo con menos interacciones; no afirma que el método gane en todas las métricas a todos los métodos de aprendizaje profundo.
Para valorar la evidencia harían falta resultados desglosados, detalles de configuración y protocolos de evaluación. La información aportada no permite comprobar si el código, los controladores entrenados o los datos experimentales están disponibles. En consecuencia, la reproducibilidad permanece sin confirmar.
El salto pendiente: de tareas evaluadas a robots reales
Los entornos mencionados incluyen juegos y tareas de MuJoCo, pero el resumen no indica que las pruebas se hayan realizado en robots físicos. MuJoCo es el nombre del conjunto de tareas citado por el preprint; la información disponible no permite atribuirle aquí un protocolo específico ni concluir que los resultados impliquen despliegue real. Una demostración en entornos de evaluación no basta, por sí sola, para certificar un sistema de control físico.
El resumen sí afirma transferencia ante cambios importantes en la dinámica del entorno. Es un indicio sobre generalización dentro de las condiciones estudiadas, pero no se describen aquí los cambios, los límites probados ni los fallos observados. No debe confundirse esa afirmación con robustez frente a cualquier perturbación, sensores imperfectos, retrasos, desgaste o condiciones de seguridad no evaluadas.
Para considerar una aplicación física habría que conocer, entre otros aspectos, cómo se valida el código generado, qué límites de acción tiene, cómo se responde a situaciones imprevistas y qué pruebas de seguridad se realizaron. Ninguno de esos detalles consta en el resumen proporcionado. No se puede afirmar que el método los resuelva ni que esté listo para desplegarse.
Qué cambia y qué conviene vigilar
El cambio conceptual es separar la síntesis del controlador de su uso repetido. El LLM ayuda a construir el programa; la búsqueda sin gradientes adapta sus parámetros con retroalimentación; y el controlador resultante actúa directamente, según la descripción del trabajo. Si se confirma en evaluaciones reproducibles, esa arquitectura podría ser útil en tareas donde la latencia de consultar un modelo en cada paso sea un obstáculo.
Por ahora, la conclusión debe ser acotada. El preprint reporta pruebas en juegos, Flappy Bird y tareas de MuJoCo, además de comparaciones con síntesis basada en planificación y aprendizaje por refuerzo profundo. La información suministrada no permite auditar las métricas, medir la ventaja de velocidad ni establecer disponibilidad de código. Tampoco demuestra despliegue robótico físico.
Para seguir el tema, conviene separar esta noticia de una comparativa general de métodos de control: el resumen presenta resultados de una propuesta concreta, no un ranking completo. También es útil consultar las noticias y los contenidos de descubrimiento para contextualizar futuras publicaciones, sin tomar esa navegación como evidencia experimental adicional.
Qué sigue abierto
- No se dispone de métricas detalladas, resultados por tarea, hardware ni tiempos absolutos para evaluar las afirmaciones de rendimiento y latencia.
- El resumen no identifica el algoritmo de búsqueda sin gradientes, el presupuesto de interacciones ni la forma exacta de la retroalimentación del entorno.
- No se especifican los juegos concretos, las tareas particulares ni las condiciones de las pruebas de transferencia.
- La información aportada no confirma que haya código, controladores o datos disponibles para reproducir los experimentos.
- No se establece que las pruebas se realizaran en robots físicos ni se describen evaluaciones de seguridad para un despliegue real.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección