AutomationBench bewertet, ob ein Agent Abläufe zwischen simulierten SaaS-Anwendungen abschließen und sie in einen überprüfbaren Endzustand überführen kann. Dieser Leitfaden erklärt, was diese Evidenz bedeutet, wie die Metriken zu lesen sind und welche zusätzlichen Prüfungen nötig sind, bevor sich ein Ergebnis auf ein reales Unternehmen übertragen lässt.
Artificial Analysis Intelligence v4.1 führt heterogene Bewertungen in einer einzigen Kennzahl zusammen. Diese Kennzahl kann für eine Vorauswahl dienen, ist aber nur interpretierbar, wenn die genaue Version, die Aufschlüsselung nach Tests und die Ausführungsbedingungen erhalten bleiben. Dieser Leitfaden erläutert, was sich in v4.1 geändert hat, welche Vergleiche einer Prüfung standhalten und warum durchschnittliche Kosten-, Zeit- und Token-Metriken keinem eigenen Budget gleichkommen.
Leitfaden zur Bewertung von Automatisierungen, die Anwendungen und KI-Komponenten verbinden – nach ihrer Testbarkeit, Nachvollziehbarkeit, menschlichen Kontrolle und Wiederherstellbarkeit bei Fehlern. Entscheidend ist nicht, wie viele Konnektoren eine Plattform anbietet, sondern ob sich jede Entscheidung verstehen und begrenzen lässt, bevor sie reale Systeme beeinflusst.
Ein Timeout beweist nicht, dass eine API eine Anfrage nicht verarbeitet hat. Dieser Leitfaden beschreibt identifizierbare Operationen, begrenzte Wiederholungen und Zustandsabgleich, damit sich Modelle und Agenten integrieren lassen, ohne E-Mails, Käufe, Datenänderungen oder Tool-Aufrufe zu duplizieren.
Eine brauchbare Genehmigungsrichtlinie beschränkt sich nicht darauf, einen Button „Genehmigen“ hinzuzufügen. Sie muss festlegen, welche Aktionen angehalten werden, welche Nachweise die prüfende Person erhält, wer entscheiden darf und was bei ausbleibender Antwort geschieht. Dieser Leitfaden bietet eine operative Methode, um einen Agenten-Workflow in überprüfbare und dem Risiko angemessene Kontrollen zu überführen.
SWE-Bench Verified liefert ein nützliches Signal für die Fähigkeit, Patches für historische Issues in Python-Repositories zu erzeugen. Seine Lösungsquote ist jedoch nicht mit autonomer Wartung in Produktion gleichzusetzen. Dieser Leitfaden erläutert, was eine Aufgabe abbildet, wie ein Patch validiert wird, welche Angaben eine Zahl vergleichbar machen und wie veröffentlichte Ergebnisse vor einer technischen Entscheidung geprüft werden können.
KI-gestützte Suchwerkzeuge können das Auffinden und Zusammenfassen von Informationen beschleunigen. Eine flüssige Antwort mit Links ist jedoch nicht gleichbedeutend mit einer überprüften Antwort. Dieser Leitfaden bietet einen reproduzierbaren Rahmen, um sie nach Nachvollziehbarkeit, tatsächlicher Belegkraft von Zitaten, Aktualität, Quellenvielfalt, Datenschutz und operativem Aufwand zu bewerten.
Die bereitgestellte Dokumentation beschreibt Mechanismen für Tool-Nutzung und Reasoning in der Live API, die den Zustand einer Unterhaltung beeinflussen. Sie reicht jedoch nicht aus, um die Ankündigung, die allgemeine Verfügbarkeit oder die Gemini 3.8 Live zugeschriebenen kommerziellen Bedingungen zu bestätigen. Dieser Leitfaden trennt das Dokumentierte von den Prüfungen, die vor einer Umstellung auf Produktion erforderlich sind.
Nach den vorliegenden institutionellen Informationen ist der 2. Dezember 2026 nicht das Ende der Ausnahme für die technische Kennzeichnung bestimmter bereits in Verkehr gebrachter KI-Systeme. Entscheidend ist die Unterscheidung zwischen der allgemeinen Anwendung der Transparenzpflichten, der spezifischen Ausnahme für eine nachweisbare Kennzeichnung sowie den getrennten Aufgaben von Anbietern und Betreibern.
Google dokumentiert den Ersatz von `antigravity-preview-05-2026` durch `antigravity-preview-09-2026`. Bei Remote-Abläufen, die nur Text verarbeiten, kann die Umstellung direkt sein; bei Integrationen, die Tool-Aufrufe auswerten, ändern sich Event-Verträge, Namen, Parameter und die Dateibearbeitung.
Ein operatives Protokoll, um Änderungen in KI-Anwendungen mit expliziten Hypothesen, Baselines, begrenztem Traffic, Freigabekriterien und einem tatsächlich ausführbaren Rollback einzuführen.
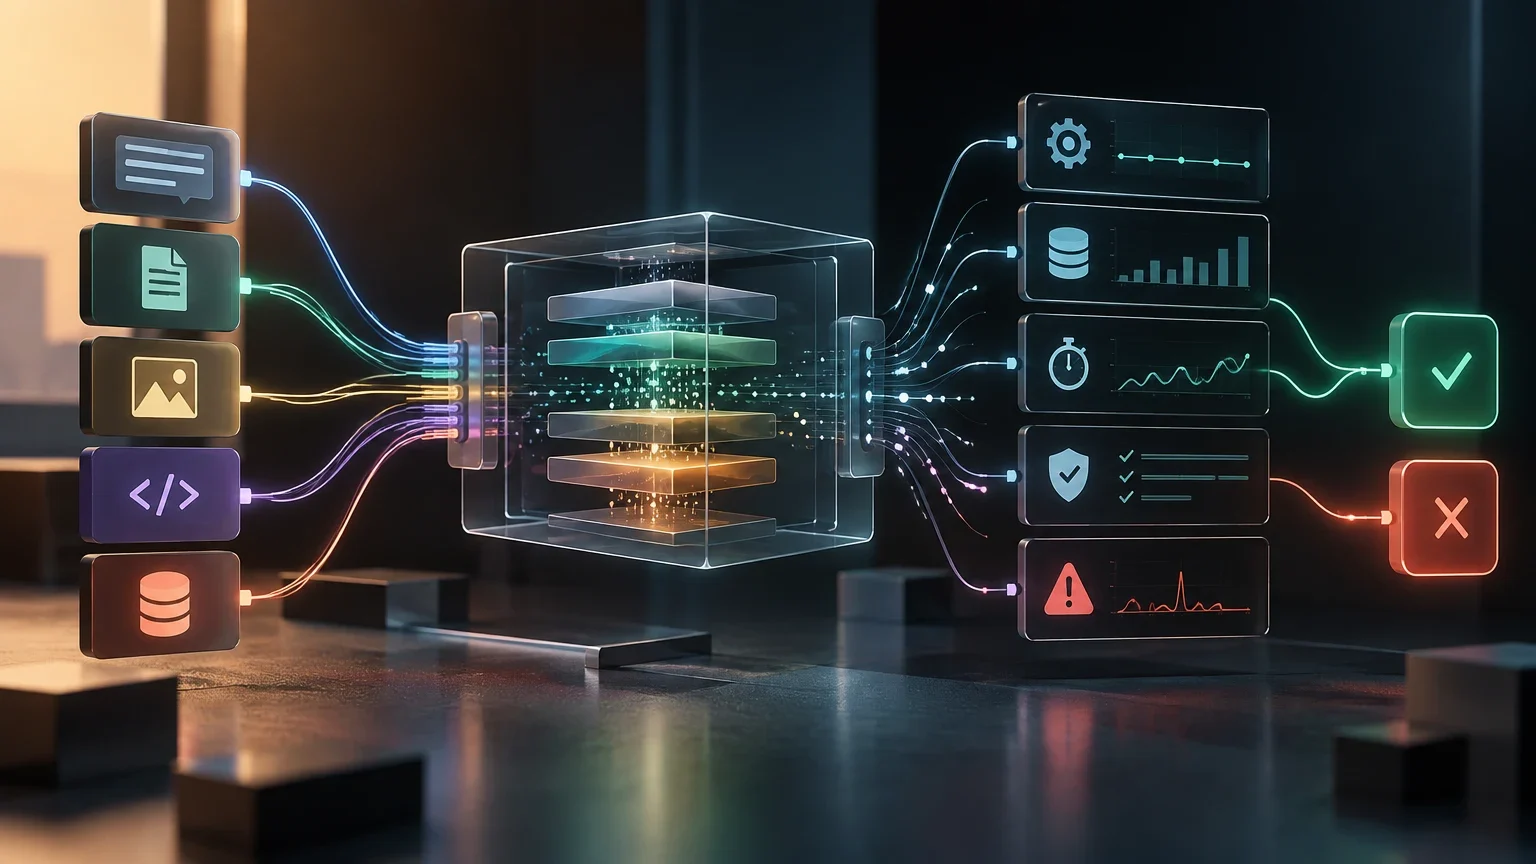
Ein operativer Leitfaden, um jede Interaktion mit einem generativen Modell in diagnostische Evidenz zu verwandeln: Versionen, abgerufener Kontext, Tools, Wiederholungsversuche, Tokens, Latenz, Validierungen und Ergebnis. Das Ziel ist nicht die Auswahl einer Plattform, sondern die Rekonstruktion dessen, was passiert ist, wen es betroffen hat und welche Änderung eine Regression erklären kann.