O AutomationBench avalia se um agente consegue concluir fluxos entre aplicações SaaS simuladas e levá-los a um estado final verificável. Este guia explica o que essa evidência significa, como interpretar as suas métricas e que testes adicionais são necessários antes de extrapolar um resultado para uma empresa real.
O Artificial Analysis Intelligence v4.1 reúne avaliações heterogéneas num único valor. Esse valor pode servir para uma pré-seleção, mas só é interpretável se forem preservados a versão exata, o detalhe por teste e as condições de execução. Este guia explica o que mudou na v4.1, que comparações resistem à análise e porque as métricas médias de custo, tempo e tokens não equivalem a um orçamento próprio.
Guia para avaliar automações que conectam aplicações e componentes de IA segundo a sua capacidade de teste, rastreabilidade, controlo humano e recuperação perante erros. O critério não é quantos conectores uma plataforma oferece, mas sim se permite compreender e limitar cada decisão antes de esta afetar sistemas reais.
Um timeout não prova que uma API não processou uma solicitação. Este guia propõe um desenho de operações identificáveis, tentativas limitadas e reconciliação de estados para integrar modelos e agentes sem duplicar e-mails, compras, alterações de dados ou chamadas de ferramentas.
Uma política de aprovação útil não se limita a adicionar um botão de «aprovar». Deve indicar que ações são interrompidas, que evidências o revisor recebe, quem pode decidir e o que acontece quando não há resposta. Este guia propõe um método operacional para transformar um fluxo de agente em controlos verificáveis e proporcionais ao risco.
O SWE-Bench Verified oferece um sinal útil sobre a capacidade de produzir patches para issues históricas de repositórios Python, mas seu percentual de resolução não equivale à manutenção autônoma em produção. Este guia explica o que uma tarefa representa, como um patch é validado, quais dados tornam um número comparável e como auditar resultados publicados antes de usá-los em uma decisão técnica.
As ferramentas de pesquisa assistida por IA podem acelerar a localização e a síntese de informação, mas uma resposta fluida com ligações não equivale a uma resposta verificada. Este guia propõe um quadro reproduzível para avaliá-las pela rastreabilidade, pelo apoio efetivo das citações, atualidade, diversidade de fontes, privacidade e custo operacional.
A documentação fornecida descreve mecanismos de utilização de ferramentas e raciocínio na Live API que afetam o estado de uma conversa. No entanto, não é suficiente para confirmar o anúncio, a disponibilidade geral nem as condições comerciais atribuídas ao Gemini 3.8 Live. Este guia separa o que está documentado das verificações necessárias antes de uma alteração em produção.
Segundo a informação institucional fornecida, a data de 2 de dezembro de 2026 não corresponde ao fim da exceção relativa à marcação técnica de determinados sistemas de IA já colocados no mercado. A questão exige distinguir a aplicação geral das obrigações de transparência, a exceção específica relativa à marcação detetável e as tarefas separadas de fornecedores e implantadores.
O Google documenta a substituição de `antigravity-preview-05-2026` por `antigravity-preview-09-2026`. Para fluxos remotos que consomem apenas texto, a mudança pode ser direta; para integrações que interpretam chamadas de ferramentas, mudam contratos de eventos, nomes, parâmetros e a edição de arquivos.
Um protocolo operacional para introduzir alterações em aplicações de IA com hipóteses explícitas, linhas de base, tráfego limitado, critérios de promoção e um rollback que realmente possa ser executado.
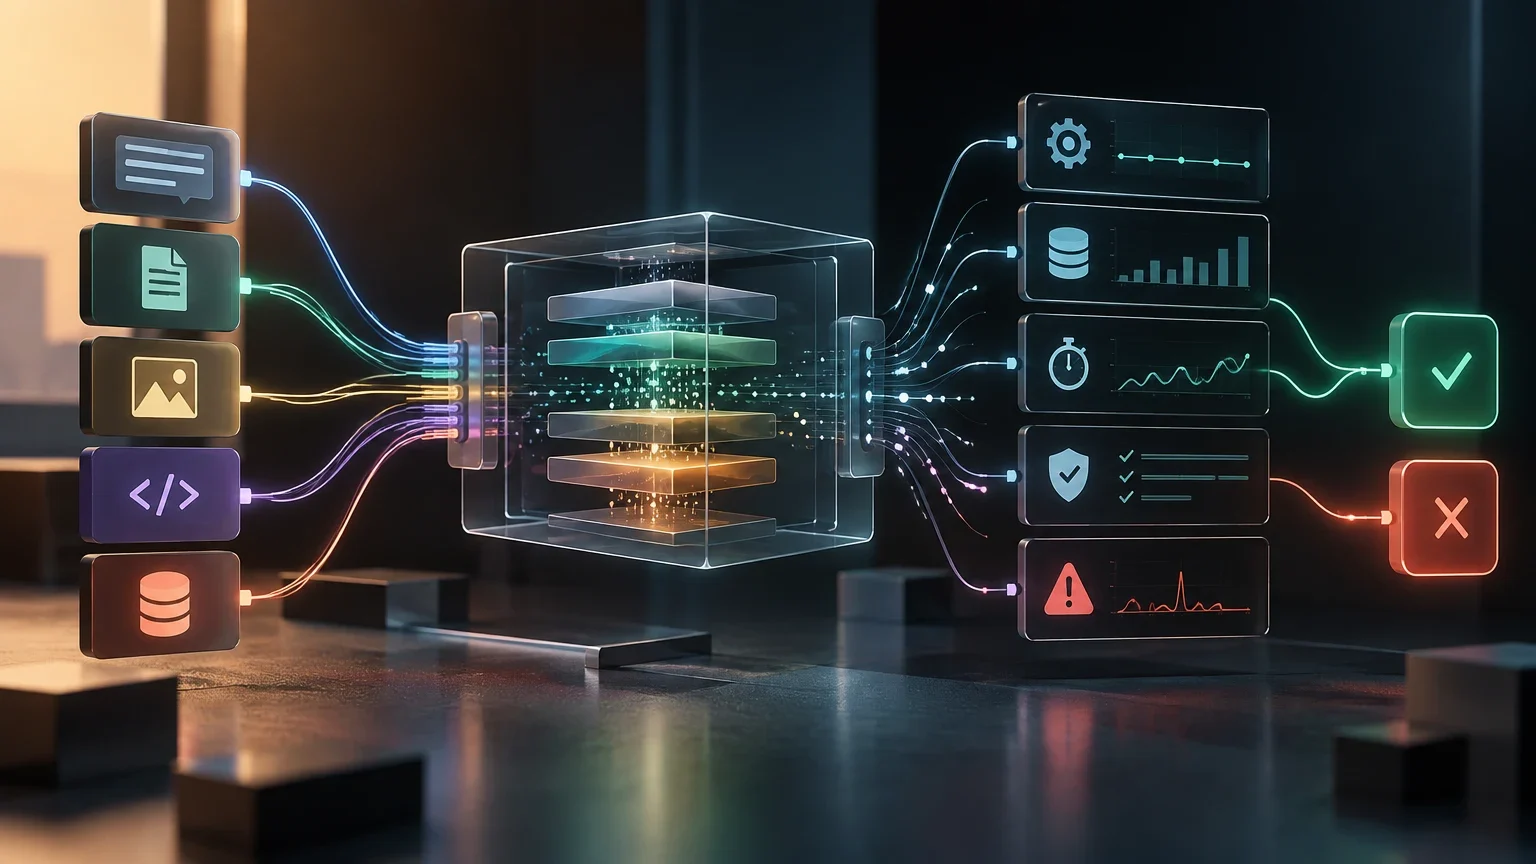
Um guia operacional para transformar cada interação com um modelo generativo em evidência diagnóstica: versões, contexto recuperado, ferramentas, tentativas, tokens, latência, validações e resultado. O objetivo não é escolher uma plataforma, mas conseguir reconstruir o que aconteceu, quem foi afetado e que alteração pode explicar uma regressão.