Agents’ Last Exam bewertet Agenten bei beruflichen Aufgaben in Betriebssystemumgebungen mit überprüfbaren Ergebnissen. Das Design eignet sich, um die Ausführung von Arbeitsabläufen zu untersuchen. Eine aggregierte Erfolgszahl belegt jedoch nicht, dass sich ein Beruf automatisieren lässt. Für ihre Einordnung sind Details zu Aufgaben, Umgebung, Harness, Modell, Werkzeugen, Budget und der bewerteten Version erforderlich.
KI auf AWS einzuführen ist keine einzelne Entscheidung. Amazon Nova, Amazon Bedrock, Amazon SageMaker AI und in andere Dienste integrierte KI-Funktionen bedeuten unterschiedliche Zugangswege, Beziehungen zu Anbietern, Kontrollen und operative Verantwortlichkeiten. Diese Analyse bietet eine Karte, um sie zu bewerten, ohne Verfügbarkeit mit Garantie, verwaltete Infrastruktur mit übertragener Verantwortung oder einen Katalog mit Produktionstauglichkeit zu verwechseln.
Die Wahl der Quantisierung besteht nicht darin, die Gewichtsdatei zu finden, die auf die GPU passt. Die Entscheidung hängt auch vom KV-Cache, der tatsächlichen Eingabelänge, dem Batch, der Parallelität, dem temporären Runtime-Speicher und dem Qualitätsverlust ab, den Ihre Aufgabe tolerieren kann. Dieser Leitfaden schlägt eine messbare Methode vor, um eine Konfiguration mit 4, 6 oder 8 Bits auszuwählen und zu validieren. Er enthält außerdem einen Leitfaden zu Methoden und Formaten (GPTQ, AWQ, SmoothQuant, GGUF), veröffentlichte Messungen zu Größe und Qualitätsverlust sowie 31 Referenzen.
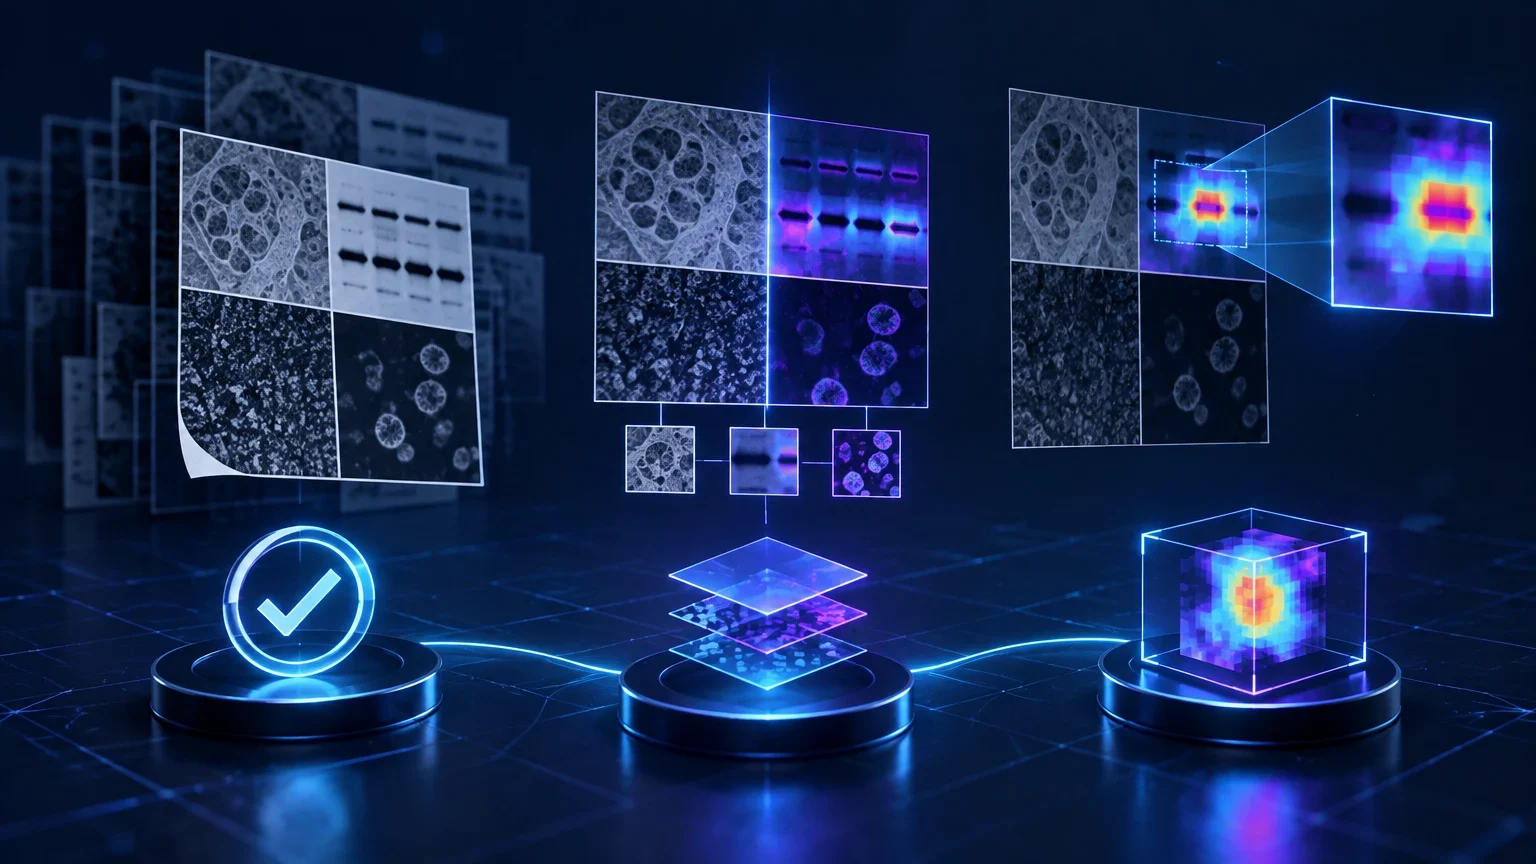
AEGIS bewertet die forensische Analyse von KI-generierten oder manipulierten wissenschaftlichen Bildern anhand getrennter Aufgaben: feststellen, ob eine Veränderung vorliegt, die Indizien begründen und den betroffenen Bereich markieren. Dieser Leitfaden trennt die Aussagen, die jedes Ergebnis trägt, von den zusätzlichen Nachweisen, die nötig wären, bevor ein System in der wissenschaftlichen Integritätssicherung oder redaktionellen Prüfung eingesetzt wird.
Eine Antwort, die korrekt zu wirken scheint, kann dennoch das Format, die Berechtigung, die Herkunft oder die Geschäftsregel verletzen, auf denen ein KI-Workflow beruht. Dieser Leitfaden zeigt, wie sich diese Annahmen in überprüfbare Verträge überführen und zum Blockieren von Regressionen vor der Produktion einsetzen lassen.
Ein Leitfaden, um Stückpreise und Telemetriedaten aus Amazon Bedrock in eine prüfbare Schätzung der Kosten pro abgeschlossener Aufgabe mit Amazon Nova 2 Lite zu überführen. Die Methode trennt Verbrauch, Wiederholungsversuche, Cache, Servicestufe und validiertes Ergebnis, ohne Tarife anzunehmen, die in den Quellen nicht enthalten sind.
Bei der Auswahl eines Codeassistenten geht es nicht nur um den Vergleich von Modellen oder Preisen. Dieser Leitfaden hilft dabei, nach Aufgabe, notwendigem Repository-Zugriff, verfügbaren Kontrollen und der Fähigkeit des Teams zu entscheiden, Änderungen zu prüfen und Fehlerfolgen zu tragen.
Ein Leitfaden, um zu entscheiden, wie viel Autonomie ein Agent erhalten soll, der Systeme abfragt oder Aktionen ausführt. Er erläutert, wie sich Tools, Berechtigungen, Speicher, menschliche Freigaben, Wiederherstellung und Auditierung vor dem Produktiveinsatz eingrenzen lassen.
Öffentliche Benchmarks können eine erste Auswahl orientieren, ersetzen aber keine Bewertung des Systems, der Daten und der Risiken eines konkreten Anwendungsfalls. Dieser Leitfaden schlägt ein reproduzierbares Protokoll vor, um Alternativen zu vergleichen, Schwellenwerte festzulegen und Evidenz zu bewahren, um über Bereitstellung, Iteration oder Verwerfung zu entscheiden.
Eine Ausgabe, die sich als JSON parsen lässt, ist nicht zwangsläufig ein für Automatisierungen geeigneter Datensatz. Dieser Leitfaden erklärt, wie Sie Verträge definieren, zwischen Schemaeinschränkungen und Werkzeugaufrufen wählen, Geschäftsregeln validieren, Fehler reparieren und externe Aktionen bis zu einer unabhängigen Freigabe blockieren.
Das neue OpenAI-Modell verbindet Schlussfolgern, Computernutzung und ein sehr großes Kontextfenster. Die gemeldeten Fortschritte sind relevant, ersetzen jedoch weder eigene Tests noch Kontrollen über Berechtigungen, Daten und irreversible Aktionen.
Google führt Gemini 3.8 Flash in seiner API als stabiles Modell. Die Dokumentation positioniert es für langfristige Softwareentwicklung, autonome Agenten und komplexe Unternehmensabläufe. Sie bestätigt ein großes Kontextfenster, multimodale Eingaben und Werkzeuganbindung, liefert aber keine unabhängigen Belege für eine Überlegenheit in realen Projekten.