Agents’ Last Exam évalue des agents sur des tâches professionnelles dans des environnements de système d’exploitation, avec des résultats vérifiables. Sa conception est utile pour étudier l’exécution de flux de travail, mais un chiffre agrégé de réussite ne démontre pas qu’un emploi peut être automatisé. Pour l’interpréter, il faut connaître les tâches, l’environnement, le harness, le modèle, les outils, le budget et la version évaluée.
Adopter l’IA sur AWS n’est pas une décision unique. Amazon Nova, Amazon Bedrock, Amazon SageMaker AI et les fonctions d’IA intégrées à d’autres services impliquent des canaux d’accès, des relations avec des fournisseurs, des contrôles et des responsabilités opérationnelles différents. Cette analyse propose une grille de lecture permettant de les évaluer sans confondre disponibilité et garantie, infrastructure gérée et responsabilité transférée, ou catalogue et aptitude à la production.
Choisir une quantification ne consiste pas à trouver le fichier de poids qui tient dans la GPU. La décision dépend aussi du cache KV, de la longueur réelle des entrées, du lot, de la concurrence, de la mémoire temporaire du runtime et de la perte de qualité que votre tâche peut tolérer. Ce guide propose une méthode mesurable pour sélectionner et valider une configuration de 4, 6 ou 8 bits. Il inclut également un guide des méthodes et formats (GPTQ, AWQ, SmoothQuant, GGUF), des mesures publiées de taille et de perte de qualité, et 31 références.
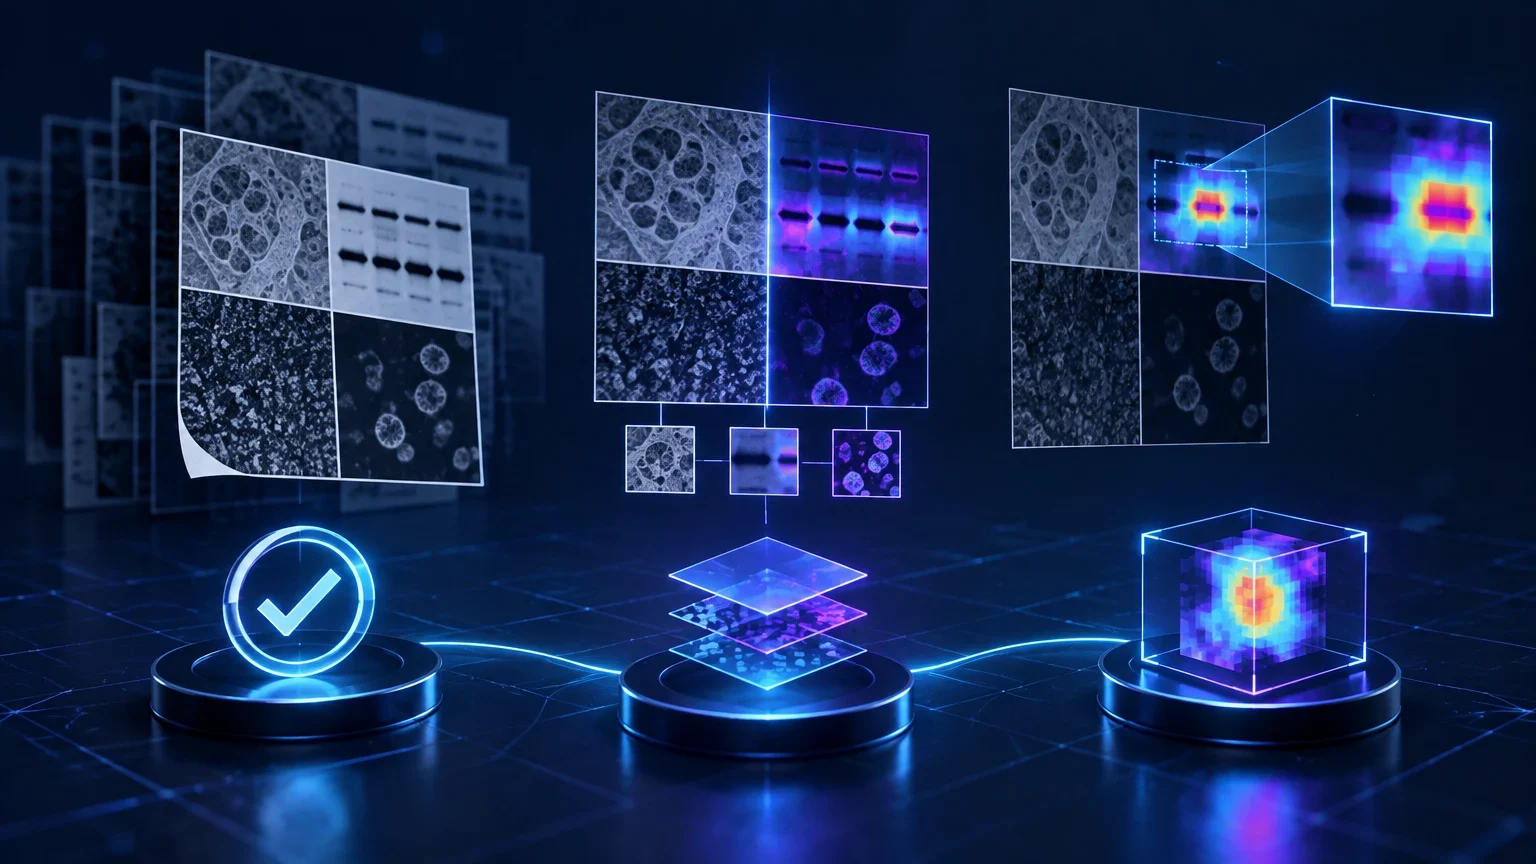
AEGIS évalue l’analyse forensique d’images académiques générées ou manipulées par l’IA à travers des tâches distinctes : décider s’il existe une altération, expliquer les indices et désigner la région concernée. Ce guide distingue les affirmations que chaque résultat permet d’étayer de celles qui nécessiteraient des preuves supplémentaires avant d’utiliser un système pour l’intégrité scientifique ou l’évaluation éditoriale.
Une réponse qui paraît correcte peut ne pas respecter le format, l’autorisation, la provenance ou la règle métier qui soutient un flux d’IA. Ce guide explique comment transformer ces hypothèses en contrats vérifiables et comment les utiliser pour bloquer les régressions avant la production.
Un guide pour transformer le prix unitaire et la télémétrie d’Amazon Bedrock en une estimation auditable du coût par tâche terminée avec Amazon Nova 2 Lite. La méthode distingue la consommation, les nouvelles tentatives, le cache, le niveau de service et le résultat validé, sans supposer de tarifs non fournis par les sources.
Choisir un assistant de code ne consiste pas seulement à comparer des modèles ou des tarifs. Ce guide propose de décider selon la tâche, l’accès nécessaire au dépôt, les contrôles disponibles et la capacité de l’équipe à examiner les modifications et à assumer les erreurs.
Un guide pour décider du degré d’autonomie à accorder à un agent qui consulte des systèmes ou exécute des actions. Il explique comment délimiter les outils, les autorisations, la mémoire, les validations humaines, la reprise et l’audit avant le passage en production.
Les benchmarks publics peuvent guider une première sélection, mais ils ne remplacent pas une évaluation du système, des données et des risques d’un cas d’usage précis. Ce guide propose un protocole reproductible pour comparer des alternatives, fixer des seuils et conserver les éléments de preuve nécessaires pour décider de déployer, d’itérer ou d’écarter une solution.
Une sortie qui peut être analysée comme du JSON n’est pas nécessairement une donnée adaptée à l’automatisation. Ce guide explique comment définir des contrats, choisir entre contraintes par schéma et outils, valider les règles métier, réparer les échecs et bloquer les actions externes tant qu’une autorisation indépendante n’existe pas.
Le nouveau modèle d’OpenAI réunit raisonnement, utilisation d’ordinateur et contexte très étendu. Les gains annoncés sont significatifs, mais ils ne remplacent ni les tests internes ni le contrôle des droits, des données et des actions irréversibles.
Google classe Gemini 3.8 Flash parmi les modèles stables de son API. La documentation le destine à l’ingénierie logicielle de longue durée, aux agents autonomes et aux flux d’entreprise complexes. Elle confirme une large fenêtre de contexte, des entrées multimodales et des outils intégrables, sans fournir de preuve indépendante de supériorité sur des projets réels.