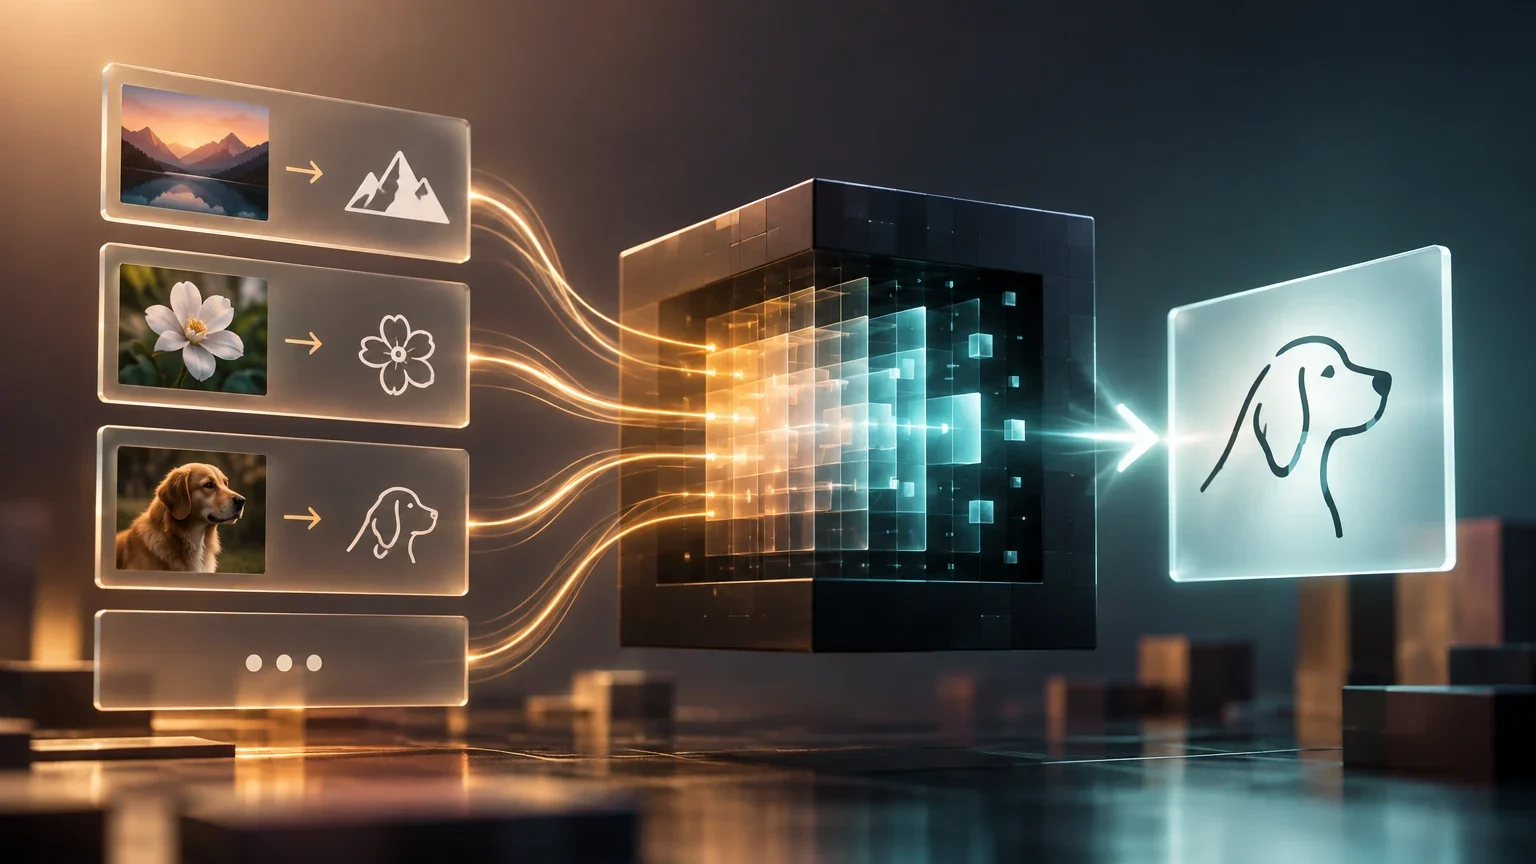
Definition in einem Satz
Adaptación temporal del comportamiento a instrucciones y ejemplos presentes en el contexto sin actualizar los pesos del modelo.
Definition: Anpassung innerhalb des Kontexts
In-Context Learning – kurz ICL – bezeichnet die beobachtbare Fähigkeit eines Modells, eine Antwort anhand der Informationen zu erzeugen, die es in einer Anfrage erhält: Anweisungen, Beispiele und die neue Aufgabe. Statt das Modell durch einen Trainingsprozess zu verändern, werden diese Informationen in die Eingabe aufgenommen, um die Antwort während dieser Interaktion zu steuern.
Eine Anfrage kann vorgeben, was zu tun ist, welches Ausgabeformat gewünscht wird und welche Beispiele die Beziehung zwischen einer Eingabe und einer erwarteten Ausgabe veranschaulichen. Das Modell erzeugt dann eine Antwort auf Grundlage der gesamten Eingabe. Im üblichen Sprachgebrauch beschreibt „Lernen“ hier die scheinbare Verhaltensänderung im jeweiligen Kontext. Es bedeutet nicht automatisch, dass das Modell seine Parameter aktualisiert oder dauerhaft eine neue Fähigkeit erworben hat.
Diese Definition bezieht sich auf die gewöhnliche Interaktion mit einem bereits verfügbaren Modell. Sie umfasst nicht automatisch externe Prozesse, die eine Anwendung ausführen kann, etwa Daten zu speichern, eine Wissensdatenbank zu aktualisieren oder ein Training anzustoßen. Präziser ist daher die Aussage, dass sich das Modell vorübergehend an die Informationen in der Anfrage anpasst, als die Behauptung, es lerne dauerhaft.
Wie ICL in einer Anfrage umgesetzt wird
Eine Anfrage mit ICL kombiniert häufig drei Bestandteile: eine Anweisung, die die Aufgabe eingrenzt, eine oder mehrere Demonstrationen, die Eingaben mit Ausgaben verknüpfen, und einen neuen Fall, den das Modell bearbeiten soll. Explizite Beispiele sind nicht bei jeder Form von ICL erforderlich: Auch eine Anweisung allein kann die Antwort beeinflussen. Beispiele sind jedoch eine verbreitete Möglichkeit, dem Modell zu zeigen, welche Umformung erwartet wird.
Die Struktur kann in natürlicher Sprache oder in einem einheitlichen Format formuliert werden. Bei Klassifikationen sollten die möglichen Kategorien festgelegt und konsequent verwendet werden. Bei der Extraktion von Feldern ist es hilfreich anzugeben, was bei fehlenden Angaben geschehen soll. Solche Entscheidungen gehören zum Entwurf der Anfrage. Sie machen die Aufgabe klarer und erleichtern die Auswertung, garantieren aber nicht, dass die Antwort richtig ist.
Das Modell verarbeitet den verfügbaren Kontext, während es seine Antwort erzeugt. Bei einer gewöhnlichen Interaktion bedeutet das nicht, dass eine Demonstration dauerhaft in seine Parameter übernommen wird. Die Information kann ihren Einfluss verlieren, sobald eine neue Anfrage ohne sie gesendet wird – es sei denn, das umgebende System speichert sie oder fügt sie erneut ein.
Ein minimales Anwendungsschema
Bei diesem Vorgehen werden Anweisungen, Demonstrationen und der zu bearbeitende Fall voneinander unterschieden. Das garantiert kein bestimmtes Ergebnis, ermöglicht aber eine Anfrage, die sich anschließend überprüfen lässt.
- 01Die Aufgabe und die zulässigen Ausgaben festlegen.
- 02Bei Bedarf repräsentative Beispiele für Eingaben und Ausgaben ergänzen.
- 03Den neuen Fall im gleichen Format vorlegen.
- 04Die Antwort prüfen und mit dem erwarteten Ergebnis vergleichen.
Drei Anwendungsbeispiele
Die folgenden Fälle veranschaulichen, wie eine Anfrage aufgebaut werden kann. Es handelt sich um Beispiele für den Entwurf, nicht um Testergebnisse für ein bestimmtes Modell und auch nicht um eine Garantie, dass ein System die Informationen zuverlässig klassifiziert oder extrahiert. In jedem Anwendungsbereich müssen zunächst Kategorien, Felder und der Umgang mit Mehrdeutigkeit festgelegt werden.
Was „Lernen“ hier bedeutet – und was sich daraus nicht ableiten lässt
Im Begriff bezeichnet „Lernen“, dass das Modell offenbar ein Muster aus dem Kontext ableitet und entsprechend darauf reagiert. Die Antwort allein verrät nicht, wie dieses Muster intern zustande gekommen ist. Ein Modell kann nach Beispielen eine Klassifikation richtig ausgeben. Daraus folgt jedoch nicht, dass es seine Parameter aktualisiert hat, die Aufgabe auf eine bestimmte Weise intern repräsentiert oder das Gelernte auf jeden beliebigen neuen Fall übertragen wird.
Eine unter den Quellen aufgeführte Forschungsarbeit beschreibt ICL bei autoregressiven Modellen als die Möglichkeit, Aufgaben durch die Vorhersage des nächsten Tokens und ohne zusätzliches Training zu lösen. Diese Beschreibung hilft dabei, die Verwendung von Kontext von einem Trainingsprozess abzugrenzen. Sie sollte jedoch nicht zu einer universellen Erklärung für alle Systeme oder internen Mechanismen verallgemeinert werden. Die verfügbaren Angaben belegen nicht, dass es eine einzige allgemein anerkannte mechanistische Erklärung des Phänomens gibt.
Es ist außerdem sinnvoll, das beobachtbare Ergebnis von einer Erklärung seiner Ursache zu trennen. Wenn eine Anweisung oder ein Beispiel die Ausgabe beeinflusst, lässt sich sagen, dass das Verhalten durch den Kontext bedingt ist. Das reicht nicht aus, um festzustellen, welche interne Repräsentation das Modell verwendet, weshalb eine bestimmte Demonstration hilfreich ist oder ob das Modell eine Regel anwendet, eine vertraute Struktur erkennt oder verschiedene Signale kombiniert.
ICL, wenige Beispiele und verwandte Methoden
„In-Context Learning“ und „Few-Shot Learning“ überschneiden sich im alltäglichen Sprachgebrauch, sind in technischen Texten aber nicht immer austauschbar. Werden Beispiele in eine Anfrage aufgenommen, um die Antwort zu steuern, ist häufig von In-Context Learning oder Few-Shot Prompting die Rede. „Few-Shot Learning“ kann dagegen auch Verfahren bezeichnen, bei denen das Modell anhand weniger Beispiele durch Training angepasst wird. Deshalb sollte man prüfen, ob eine Quelle Beispiele in der Eingabe oder einen Trainingsprozess meint.
Fine-Tuning unterscheidet sich von der gewöhnlichen Nutzung von ICL: Dabei wird das Modell mit Daten trainiert oder angepasst, um sein Verhalten zu verändern. ICL hingegen stellt Informationen im Kontext der jeweiligen Anfrage bereit. Auch Dokumentenretrieval ist ein anderer Vorgang: Eine Anwendung sucht externe Informationen, die sie dem Kontext hinzufügen kann. Wenn das Modell anschließend eine Antwort auf Grundlage dieser Informationen erzeugt, kann die Generierung ICL nutzen. Die Suche und das In-Context Learning sind dennoch nicht derselbe Schritt.
ICL ist außerdem nicht mit kontinuierlichem Lernen gleichzusetzen. Ein Beispiel in einer Anfrage bedeutet nicht, dass das Modell es in späteren Interaktionen behalten wird. Ob Informationen erhalten bleiben, hängt davon ab, wie das umgebende System aufgebaut ist und ob es die betreffenden Inhalte erneut bereitstellt.
Begriffe voneinander abgrenzen
Die Terminologie ist je nach Kontext unterschiedlich. Die Tabelle unterscheidet die Methoden danach, wo die Information eingebracht wird, nicht danach, welches Ergebnis man sich davon erhofft.
| Begriff | Wo die Information eingebracht wird | Was daraus allein nicht folgt |
|---|---|---|
| In-Context Learning (ICL) | In der Eingabe oder im Kontext der Anfrage, etwa durch Anweisungen, Beispiele oder andere Signale | Eine dauerhafte Aktualisierung der Modellgewichte |
| Few-Shot Prompting | In der Anfrage, durch Demonstrationen von Eingaben und Ausgaben | Dass „Few-Shot Learning“ immer diese Technik bezeichnet |
| Fine-Tuning | In einem Trainings- oder Anpassungsprozess des Modells | Dass das Modell jede neue Aufgabe gut bewältigen wird |
| Dokumentenretrieval | In externen Informationen, die ein System suchen und dem Kontext hinzufügen kann | Dass Retrieval und ICL derselbe Prozess sind |
| Kontinuierliches Lernen | In Mechanismen, die Informationen über eine einzelne Anfrage hinaus speichern oder integrieren | Dass ein Beispiel aus einer Interaktion automatisch in Erinnerung bleibt |
Grenzen und häufige Fehler beim Entwurf
Beispiele bilden möglicherweise nicht die Vielfalt realer Eingaben ab. Wenn sie alle klar und kurz sind, kann eine Anfrage zunächst wirksam erscheinen und dann bei mehrdeutigen Nachrichten, fehlenden Feldern oder ungewöhnlichen Formulierungen scheitern. Mehr Demonstrationen beheben dieses Problem nicht automatisch: Entscheidend ist, ob sie für die Aufgabe relevant, korrekt und ausreichend vielfältig sind.
Auch die Auswahl und Reihenfolge der Beispiele können die Antwort beeinflussen. Ein einzelner Treffer ist kein Beleg für Robustheit. Ebenso sollte ein Fehler nicht ausschließlich dem Modell zugeschrieben werden, ohne vorher die Anweisung, das Format und die Beispieldaten zu prüfen. Bei unklar definierten Labels können sich sogar Menschen uneinig sein. Ein mehrdeutiges Ausgabeformat kann die Bewertung erschweren, selbst wenn die allgemeine Interpretation plausibel ist.
Zu den häufigen Fehlern gehören unvereinbare Kategorien, Beispiele, die der Anweisung widersprechen, fehlende Vorgaben für nicht vorhandene Informationen und eine Bewertung anhand von Fällen, die den Beispielen in der Anfrage stark ähneln. Ein weiterer Fehler ist, eine überzeugend formulierte Ausgabe mit einer verifizierten Extraktion gleichzusetzen. Bei operativen Anwendungen benötigen wichtige Felder und Klassifikationen Kontrollen, die dem jeweiligen Risiko entsprechen.
So lässt sich prüfen, ob Beispiele helfen
In der Praxis lässt sich ICL am besten bewerten, indem dieselbe Aufgabe einmal ohne und einmal mit Beispielen getestet wird. Modell, Anweisung, Testfälle und sonstige Bedingungen sollten dabei möglichst gleich bleiben. Der Testsatz sollte repräsentative Eingaben und schwierige Fälle enthalten, die keine bloßen Kopien der Demonstrationen sind. Antworten sollten aufbewahrt und Fehler dokumentiert werden. Es genügt nicht, nur Treffer auszuwählen, die einen ersten positiven Eindruck bestätigen.
Der Vergleich kann die Genauigkeit der Labels, den Anteil fehlender oder falscher Felder, die Einhaltung des Ausgabeformats und die Zahl der Fälle erfassen, die überprüft werden müssen. Welche Kennzahl passt, hängt vom Ziel ab: Eine Supportklassifikation wird anders bewertet als die Extraktion von Rechnungsbeträgen. Wenn Fehler in bestimmten Kategorien unterschiedliche Folgen haben, sollten sie getrennt analysiert werden.
Ein kleiner Test kann Probleme beim Entwurf aufdecken, garantiert aber nicht, dass das Verhalten im Produktivbetrieb stabil bleibt. Wenn sich die Verteilung von Anfragen, Dokumenten oder der Sprache von Kundinnen und Kunden verändert, können sich auch die Ergebnisse verändern. Deshalb sollten Beispiele anhand relevanter Daten überprüft und die Bewertung wiederholt werden, wenn sich die Aufgabe oder die Einsatzbedingungen ändern.
Ein einfacher Vergleichstest
Ziel ist es, einzuschätzen, ob Demonstrationen die Leistung bei Fällen verbessern, die nicht zu ihrer Erstellung verwendet wurden. Der Vergleich beweist für sich genommen keinen bestimmten internen Mechanismus.
- 01Eine Aufgabe, die erwartete Ausgabe und Kriterien für Fehler festlegen, bevor der Test beginnt.
- 02Entwurfsbeispiele und Evaluationsfälle trennen; nicht nur die gezeigten Beispiele bewerten.
- 03Dieselbe Anweisung einmal ohne und einmal mit Demonstrationen unter vergleichbaren Bedingungen ausführen.
- 04Treffer, Fehler, fehlende Angaben, Format und prüfbedürftige Fälle vergleichen.
- 05Beispiele und Ergebnisse erneut prüfen, wenn der Nutzen uneinheitlich ist oder sich auf einfache Fälle beschränkt.
Praktische Kriterien und verwandte Begriffe
ICL ist eine sinnvolle Option, wenn sich die Aufgabe klar beschreiben lässt, die Beispiele in den verfügbaren Kontext passen und die Ausgabe überprüft werden kann. Vor dem Einsatz sollte man sicherstellen, dass alle Demonstrationen korrekt sind, die neuen Fälle der vorgesehenen Aufgabe ausreichend ähneln und es eine akzeptable Antwort für mehrdeutige oder außerhalb des Geltungsbereichs liegende Fälle gibt.
Wenn Beispiele die Ergebnisse bei repräsentativen Fällen nicht verbessern, sollten zunächst die Aufgabenbeschreibung, die Labels, das Format und die Fallauswahl überprüft werden. Wird eine dauerhafte Wirkung über mehrere Interaktionen hinweg oder eine langfristige Verhaltensänderung benötigt, lösen zusätzliche Beispiele in jeder Anfrage dieses Problem nicht. Auch die Forschung zu kleinen und mehrsprachigen Modellen vergleicht ICL mit instruction tuning. Eine Beobachtung zu diesem Vergleich reicht jedoch nicht aus, um festzustellen, welche Methode für jedes Modell und jede Aufgabe geeignet ist.
Weitere Informationen finden Sie im Glossar, im verwandten Glossareintrag zu In-Context Learning und im Vergleichsbereich. Die zugehörigen internen Bezeichnungen lauten „glossary.index“, „glossary:in-context-learning“ und „compare.index“. Ob diese Seiten verfügbar sind und welche Inhalte sie bieten, hängt von der jeweiligen Website ab.