Définition en une phrase
Adaptación temporal del comportamiento a instrucciones y ejemplos presentes en el contexto sin actualizar los pesos del modelo.
Définition : une adaptation au sein du contexte
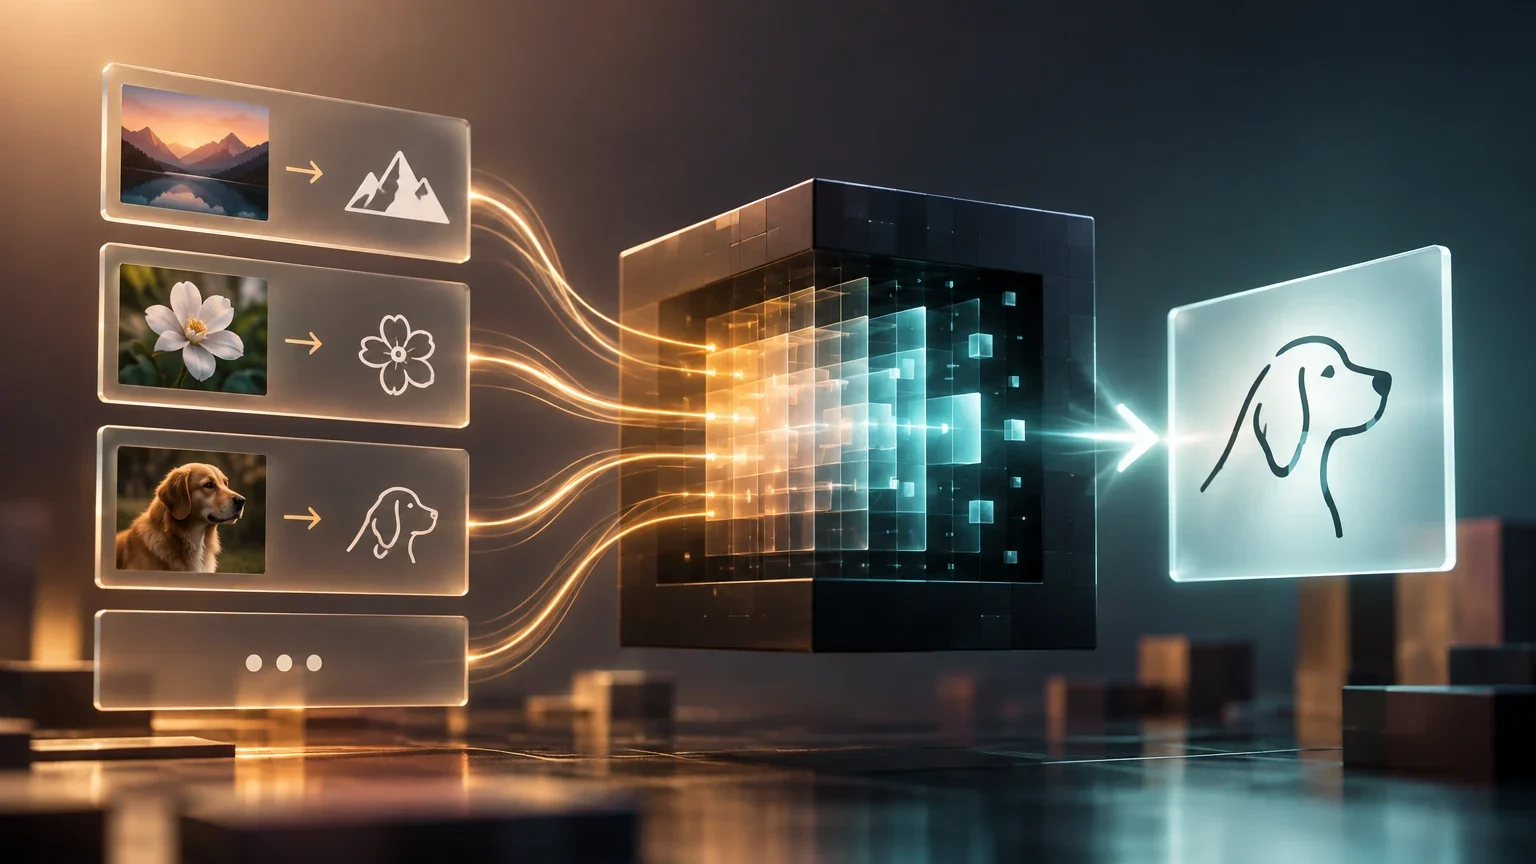
L’apprentissage en contexte — in-context learning, ou ICL — désigne la capacité observable d’un modèle à produire une réponse conditionnée par les informations reçues dans une requête : des instructions, des exemples et la nouvelle tâche à réaliser. Au lieu de modifier le modèle au moyen d’un processus d’entraînement, ces informations sont intégrées à l’entrée afin d’orienter la réponse pendant cette interaction.
Dans une requête, le contexte peut préciser la tâche, le format à utiliser et, au moyen d’exemples, la relation attendue entre une entrée et une sortie. Le modèle génère alors une réponse à partir de l’ensemble de l’entrée. Dans l’usage courant du terme, le mot « apprentissage » décrit le changement apparent du comportement en fonction du contexte ; il ne signifie pas nécessairement que le modèle a mis à jour ses paramètres ni qu’il a acquis une compétence durable.
Cette définition concerne l’interaction ordinaire avec un modèle déjà disponible. À elle seule, elle ne couvre pas les processus externes qu’une application peut exécuter, comme enregistrer des données, mettre à jour une base de connaissances ou lancer un entraînement. Il est donc plus précis de dire que le modèle s’adapte temporairement aux informations de la requête que d’affirmer qu’il apprend de façon permanente.
Comment le présenter dans une requête
Une requête utilisant l’ICL combine généralement trois éléments : une instruction qui délimite la tâche, une ou plusieurs démonstrations associant des entrées à des sorties, et un nouvel élément que le modèle doit traiter. Les démonstrations ne sont pas indispensables à toutes les formes d’ICL : une instruction seule peut également orienter la réponse. Les exemples explicites constituent toutefois un moyen courant de montrer au modèle quelle transformation est attendue.
La structure peut être formulée en langage naturel ou selon un format régulier. Si vous demandez des étiquettes, définissez-les et utilisez-les de manière cohérente ; si vous extrayez des champs, précisez quoi faire lorsqu’une donnée est absente. Ces choix font partie de la conception de la requête. Ils ne rendent pas automatiquement la réponse correcte : ils explicitent la tâche et facilitent l’évaluation du résultat.
Le modèle traite le contexte disponible au moment de générer sa réponse. Dans une interaction ordinaire, cela ne revient pas à intégrer durablement la démonstration à ses paramètres. L’information peut cesser d’influencer le modèle lors d’une nouvelle requête qui ne la contient pas, à moins que le système environnant ne la conserve ou ne l’ajoute de nouveau.
Schéma minimal d’utilisation
Cette procédure distingue les instructions, les démonstrations et le cas à traiter. Elle ne garantit pas le résultat ; elle permet de construire une requête qui pourra ensuite être testée.
- 01Définir la tâche et les sorties autorisées.
- 02Ajouter, si nécessaire, des exemples représentatifs d’entrées et de sorties.
- 03Présenter le nouveau cas dans le même format.
- 04Examiner la réponse et la comparer au résultat attendu.
Trois exemples concrets
Les cas suivants montrent comment structurer une requête. Ce sont des exemples de conception, et non des résultats de tests menés sur un modèle précis ni la garantie qu’un système classera ou extraira correctement les informations. Dans chaque domaine, il faut définir au préalable les catégories, les champs et la manière de traiter les cas ambigus.
Ce que signifie « apprendre » et ce qu’on ne peut pas en conclure
Dans cette expression, le mot « apprentissage » renvoie au fait que le modèle semble déduire une régularité à partir du contexte et répondre en conséquence. La réponse ne révèle pas, à elle seule, comment cette régularité a été produite en interne. Un modèle peut réussir une classification après avoir vu des exemples, mais cette réussite ne prouve pas qu’il a effectué une mise à jour de ses paramètres, qu’il représente la tâche d’une manière particulière ou qu’il saura la transférer à n’importe quel nouveau cas.
Une formulation de recherche mentionnée parmi les sources décrit l’ICL, dans les modèles autorégressifs, comme la possibilité de résoudre des tâches au moyen de la prédiction du prochain token et sans entraînement supplémentaire. Cette description aide à distinguer l’utilisation du contexte de l’entraînement, mais elle ne doit pas être transformée en explication universelle de tous les systèmes ou de tous les mécanismes internes. Les sources disponibles ne permettent pas d’affirmer qu’il existe une explication mécanistique unique et largement acceptée du phénomène.
Il faut également distinguer le résultat observable de son explication causale. Le fait qu’une instruction ou un exemple influe sur la sortie permet de dire que le comportement est conditionné par le contexte. Cela ne suffit pas à identifier la représentation interne utilisée par le modèle, à expliquer pourquoi une démonstration donnée est utile, ni à déterminer si le modèle applique une règle, reconnaît une structure familière ou combine plusieurs signaux.
ICL, apprentissage avec peu d’exemples et méthodes voisines
Dans l’usage courant, « apprentissage en contexte » et « apprentissage avec peu d’exemples » se recoupent, mais ces termes ne sont pas interchangeables dans tous les textes techniques. Lorsque les exemples sont intégrés à la requête pour orienter la réponse, on parle souvent d’apprentissage en contexte ou de prompting avec peu d’exemples. En revanche, « few-shot learning » peut aussi désigner des approches dans lesquelles le modèle est adapté par entraînement à partir de peu d’exemples. Il faut donc vérifier si une source parle d’exemples inclus dans l’entrée ou d’une procédure d’entraînement.
Le fine-tuning se distingue de l’usage ordinaire de l’ICL : il consiste à entraîner ou à ajuster le modèle à partir de données afin de modifier son comportement, tandis que l’ICL apporte des informations dans le contexte de la requête. La récupération de documents constitue également une opération distincte : elle sélectionne des informations externes qu’une application peut ajouter au contexte. Si le modèle répond ensuite en fonction de ces informations, sa génération peut utiliser l’ICL, mais la recherche et l’apprentissage en contexte ne sont pas une seule et même étape.
L’ICL ne doit pas non plus être confondu avec l’apprentissage continu. Inclure un exemple dans une requête ne signifie pas que le modèle s’en souviendra lors d’interactions ultérieures. La persistance dépend de la conception du système qui l’entoure et de sa capacité à fournir de nouveau cette information.
Distinguer les concepts
La terminologie varie selon le contexte. Ce tableau distingue les méthodes en fonction de l’endroit où l’information est intégrée, et non du résultat qu’elles sont censées produire.
| Concept | Où l’information est intégrée | Ce que cela n’implique pas à lui seul |
|---|---|---|
| Apprentissage en contexte (ICL) | Dans l’entrée ou le contexte de la requête, au moyen d’instructions, d’exemples ou d’autres signaux | Une mise à jour permanente des poids |
| Prompting avec peu d’exemples | Dans la requête, au moyen de démonstrations associant entrées et sorties | Que « few-shot learning » désigne toujours cette technique |
| Fine-tuning | Dans un processus d’entraînement ou d’ajustement du modèle | Que le modèle répondra correctement à toute nouvelle tâche |
| Récupération de documents | Dans des informations externes recherchées par un système et susceptibles d’être ajoutées au contexte | Que la récupération et l’ICL constituent le même processus |
| Apprentissage continu | Dans des mécanismes qui conservent ou intègrent des informations au-delà d’une requête | Qu’un exemple présenté lors d’une interaction sera automatiquement mémorisé |
Limites et erreurs fréquentes de conception
Les exemples peuvent ne pas représenter la diversité des entrées réelles. Si tous sont clairs et courts, une requête peut sembler efficace tout en échouant face à des messages ambigus, des champs manquants ou des formulations inhabituelles. Augmenter le nombre de démonstrations ne résout pas automatiquement le problème : il importe qu’elles soient pertinentes, exactes et suffisamment variées pour la tâche.
La sélection et l’ordre des exemples peuvent également influer sur la réponse. Il ne faut pas interpréter une réussite isolée comme une preuve de robustesse ni attribuer un échec au seul modèle sans examiner l’instruction, le format et les données d’exemple. Des étiquettes mal définies peuvent provoquer des désaccords, y compris entre personnes ; un format de sortie ambigu peut compliquer l’évaluation même si l’interprétation générale est raisonnable.
Parmi les erreurs fréquentes, citons le mélange de catégories incompatibles, des exemples qui contredisent l’instruction, l’absence de consignes sur les informations manquantes et l’évaluation limitée à des cas similaires à ceux déjà inclus dans la requête. Une autre erreur consiste à confondre une sortie convaincante avec une extraction vérifiée : pour les usages opérationnels, les champs et les classifications importants doivent faire l’objet de contrôles adaptés aux risques.
Comment vérifier si les exemples sont utiles
La méthode pratique consiste à comparer la même tâche avec et sans exemples, en maintenant autant que possible constants le modèle, l’instruction, les cas de test et les autres conditions. L’ensemble d’évaluation doit inclure des entrées représentatives et des cas difficiles qui ne sont pas de simples copies des démonstrations. Il faut conserver les réponses et consigner les erreurs, et non sélectionner uniquement les réussites qui confirment une première impression.
La comparaison peut mesurer l’exactitude des étiquettes, la proportion de champs omis ou erronés, le respect du format et le nombre de cas nécessitant un examen. La mesure choisie dépend de l’objectif : une classification de demandes de support ne s’évalue pas comme l’extraction de montants. Si les erreurs de certaines catégories ont des conséquences différentes, elles doivent être analysées séparément.
Un petit test permet de détecter des problèmes de conception, mais ne garantit pas que le comportement se maintiendra en production. Si la répartition des demandes, des documents ou du langage des clients évolue, les résultats peuvent eux aussi changer. Il faut donc vérifier les exemples à l’aide de données pertinentes et répéter l’évaluation lorsque la tâche ou les conditions d’utilisation changent.
Test comparatif simple
L’objectif est d’estimer si les démonstrations améliorent les résultats sur des cas qui n’ont pas servi à les rédiger. Cette comparaison ne prouve pas, à elle seule, l’existence d’un mécanisme interne particulier.
- 01Définir la tâche, le résultat attendu et les critères d’erreur avant le test.
- 02Séparer les exemples de conception des cas d’évaluation ; ne pas évaluer uniquement les exemples présentés.
- 03Exécuter la même instruction sans démonstrations puis avec des démonstrations, dans des conditions comparables.
- 04Comparer les réussites, les erreurs, les omissions, le format et les cas nécessitant un examen.
- 05Revoir les exemples et les résultats si l’amélioration est irrégulière ou se concentre sur les cas simples.
Critères pratiques et concepts associés
L’ICL peut convenir lorsque la tâche est clairement définie, que les exemples tiennent dans le contexte disponible et que la sortie peut être vérifiée. Avant de l’adopter, assurez-vous que chaque démonstration est exacte, que les nouveaux cas ressemblent suffisamment à la tâche prévue et qu’une réponse acceptable est prévue pour les situations ambiguës ou hors périmètre.
Si les exemples n’améliorent pas les résultats sur des cas représentatifs, commencez par revoir la définition de la tâche, les étiquettes, le format et la sélection des cas. Si vous avez besoin d’une persistance entre plusieurs interactions ou d’un changement durable du comportement, ajouter des exemples à chaque requête ne répond pas à ce besoin. La recherche sur les petits modèles multilingues compare également l’ICL et l’ajustement par instructions ; toutefois, une observation issue de cette comparaison ne permet pas de déterminer quelle méthode convient à tous les modèles ou à toutes les tâches.
Pour poursuivre, consultez la page du glossaire, la fiche associée sur l’apprentissage en contexte et la section consacrée aux comparatifs. Leurs identifiants internes sont « glossary.index », « glossary:in-context-learning » et « compare.index » ; la disponibilité et le contenu de ces pages dépendent du site.