Definizione in una frase
Adaptación temporal del comportamiento a instrucciones y ejemplos presentes en el contexto sin actualizar los pesos del modelo.
Definizione: adattamento all’interno del contesto
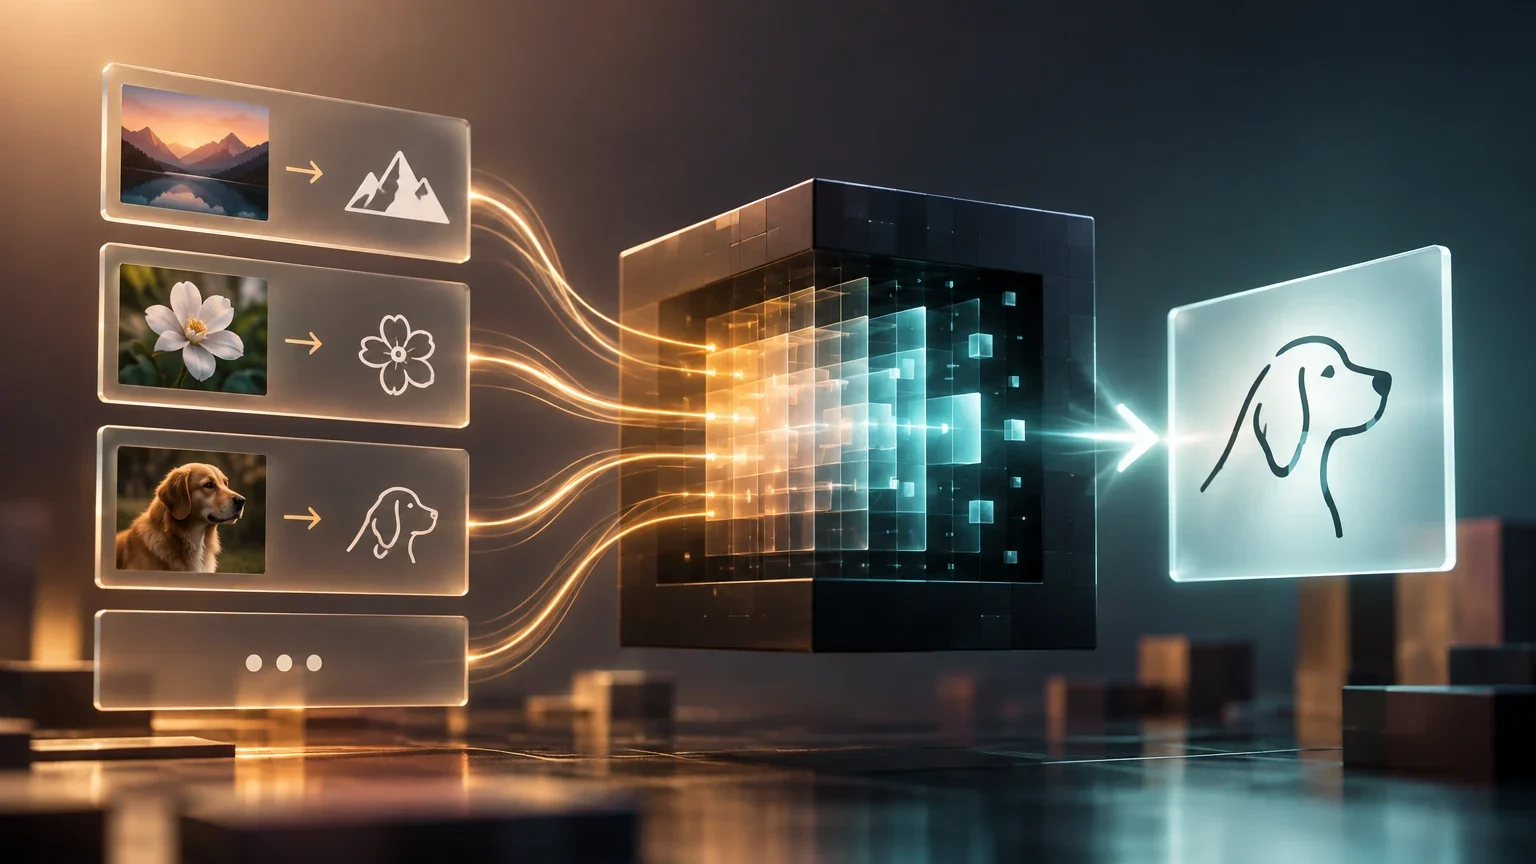
L’apprendimento in contesto — in-context learning, o ICL — è la capacità osservabile di un modello di produrre una risposta condizionata dalle informazioni che riceve in una richiesta: istruzioni, esempi e il nuovo compito da svolgere. Anziché modificare il modello con un processo di addestramento, si inseriscono queste informazioni nell’input per orientare la risposta durante quella specifica interazione.
Una richiesta può indicare che cosa fare, quale formato usare e quali esempi mostrano la relazione tra un input e l’output atteso. Il modello genera quindi una risposta a partire dall’input nel suo complesso. Nell’uso comune del termine, «apprendimento» descrive il cambiamento apparente del comportamento in presenza del contesto; non significa necessariamente che il modello abbia aggiornato i propri parametri o acquisito un’abilità permanente.
Questa definizione riguarda l’interazione ordinaria con un modello già disponibile. Da sola, non comprende eventuali processi esterni eseguiti dall’applicazione, come salvare dati, aggiornare una base di conoscenza o avviare un addestramento. È quindi più preciso dire che il modello si adatta temporaneamente alle informazioni della richiesta, invece di affermare che apprende in modo permanente.
Come si presenta in una richiesta
Una richiesta che usa l’ICL combina spesso tre elementi: un’istruzione che definisce il compito, una o più dimostrazioni che associano input e output, e un nuovo elemento da elaborare. Le dimostrazioni non sono indispensabili in tutte le forme di ICL: anche una semplice istruzione può orientare la risposta. Tuttavia, gli esempi espliciti sono un modo comune per mostrare al modello quale trasformazione ci si aspetta.
La struttura può essere formulata in linguaggio naturale oppure seguire un formato regolare. Se si chiedono etichette, conviene definirle e usarle in modo coerente; se si estraggono campi, è utile specificare che cosa fare quando un dato non è presente. Queste scelte fanno parte della progettazione della richiesta. Non rendono automaticamente corretta la risposta, ma esplicitano il compito e aiutano a valutare meglio il risultato.
Durante la generazione, il modello elabora il contesto disponibile. In un’interazione normale, questo non equivale a incorporare in modo permanente la dimostrazione nei suoi parametri. Le informazioni possono smettere di influenzare la risposta quando si invia una nuova richiesta che non le contiene, a meno che il sistema circostante non le conservi o non le reinserisca.
Schema minimo di utilizzo
Il procedimento distingue istruzioni, dimostrazioni e caso da risolvere. Non garantisce il risultato, ma permette di costruire una richiesta che si possa poi verificare.
- 01Definire il compito e gli output ammessi.
- 02Aggiungere esempi rappresentativi di input e output, se necessari.
- 03Presentare il nuovo caso usando lo stesso formato.
- 04Esaminare la risposta e confrontarla con il risultato atteso.
Tre esempi applicativi
I casi seguenti illustrano come strutturare una richiesta. Sono esempi di progettazione, non risultati di test condotti su un modello specifico né garanzie che un sistema classifichi o estragga correttamente le informazioni. In ogni ambito è necessario definire in anticipo le categorie, i campi e il modo di gestire l’ambiguità.
Che cosa significa «apprendere» e che cosa non possiamo dedurre
In questa espressione, «apprendimento» indica che il modello sembra inferire una regolarità dal contesto e rispondere di conseguenza. La risposta, da sola, non rivela come quella regolarità sia stata prodotta internamente. Un modello può classificare correttamente un elemento dopo aver visto degli esempi, ma questo risultato non dimostra che abbia eseguito un aggiornamento dei parametri, che rappresenti il compito in un certo modo o che sappia trasferire la regola a qualsiasi nuovo caso.
Una formulazione di ricerca inclusa tra le fonti descrive l’ICL nei modelli autoregressivi come la possibilità di svolgere compiti tramite la predizione del token successivo, senza ulteriore addestramento. Questa descrizione aiuta a distinguere l’uso del contesto dall’addestramento, ma non va trasformata in una spiegazione universale per tutti i sistemi o per tutti i meccanismi interni. Le fonti disponibili non consentono di affermare che esista una spiegazione meccanicistica unica e condivisa del fenomeno.
È inoltre utile separare il risultato osservabile dalla spiegazione causale. Se un’istruzione o un esempio influenza l’output, si può dire che il comportamento è condizionato dal contesto. Non è sufficiente per identificare quale rappresentazione interna usi il modello, perché una specifica dimostrazione sia utile o se il modello stia applicando una regola, riconoscendo una struttura familiare o combinando segnali diversi.
ICL, pochi esempi e metodi affini
«Apprendimento in contesto» e «apprendimento con pochi esempi» si sovrappongono nell’uso quotidiano, ma non sono termini intercambiabili in tutti i testi tecnici. Quando gli esempi sono inclusi nella richiesta per orientare la risposta, si parla spesso di apprendimento in contesto o di prompting con pochi esempi. «Few-shot learning», invece, può indicare anche approcci in cui il modello si adatta attraverso l’addestramento su pochi esempi. È quindi importante verificare se una fonte si riferisce a esempi inseriti nell’input o a una procedura di addestramento.
Il fine-tuning è diverso dall’uso ordinario dell’ICL: comporta l’addestramento o l’adattamento del modello con dati per modificarne il comportamento, mentre l’ICL fornisce informazioni nel contesto della richiesta. Anche il recupero di documenti è un’operazione distinta: seleziona informazioni esterne che un’applicazione può aggiungere al contesto. Se poi il modello genera una risposta condizionata da tali informazioni, la generazione può usare l’ICL, ma ricerca e apprendimento in contesto non sono la stessa fase.
L’ICL non va confuso neppure con l’apprendimento permanente. Inserire un esempio in una richiesta non implica che il modello lo ricorderà nelle interazioni successive. La persistenza dipende da come è progettato il sistema circostante e dal fatto che l’informazione venga fornita di nuovo.
Come distinguere i concetti
La terminologia varia a seconda del contesto. La tabella distingue i metodi in base a dove viene inserita l’informazione, non in base al risultato che si spera di ottenere.
| Concetto | Dove viene inserita l’informazione | Che cosa non implica di per sé |
|---|---|---|
| Apprendimento in contesto (ICL) | Nell’input o nel contesto della richiesta, tramite istruzioni, esempi o altri segnali | Un aggiornamento permanente dei pesi |
| Prompting con pochi esempi | Nella richiesta, tramite dimostrazioni di input e output | Che «few-shot learning» indichi sempre questa tecnica |
| Fine-tuning | In un processo di addestramento o adattamento del modello | Che il modello risponda bene a ogni nuovo compito |
| Recupero di documenti | In informazioni esterne che un sistema cerca e può aggiungere al contesto | Che recupero e ICL siano lo stesso processo |
| Apprendimento permanente | In meccanismi che conservano o incorporano informazioni oltre una singola richiesta | Che un esempio fornito in un’interazione venga ricordato automaticamente |
Limiti ed errori di progettazione frequenti
Gli esempi potrebbero non rappresentare la varietà degli input reali. Se sono tutti chiari e brevi, la richiesta può sembrare efficace e poi fallire davanti a messaggi ambigui, campi mancanti o espressioni insolite. Aumentare il numero di dimostrazioni non risolve automaticamente il problema: conta che siano pertinenti, corrette e abbastanza varie per il compito.
Anche la scelta e l’ordine degli esempi possono influenzare la risposta. Non è opportuno interpretare un singolo successo come prova di robustezza, né attribuire un errore esclusivamente al modello senza esaminare l’istruzione, il formato e gli esempi forniti. Un’etichetta definita male può generare disaccordi anche tra persone; un formato di output ambiguo può rendere difficile la valutazione anche quando l’interpretazione generale è ragionevole.
Tra gli errori più comuni ci sono l’uso di categorie incompatibili, esempi che contraddicono l’istruzione, la mancata indicazione di come gestire le informazioni assenti e la valutazione limitata a casi simili a quelli già inclusi nella richiesta. Un altro errore è confondere un output convincente con un’estrazione verificata: negli usi operativi, i campi e le classificazioni rilevanti richiedono controlli adeguati al rischio.
Come verificare se gli esempi sono utili
Un modo pratico per valutare l’ICL consiste nel confrontare lo stesso compito con e senza esempi, mantenendo il più possibile invariati il modello, l’istruzione, i casi di test e le altre condizioni. Il set di valutazione dovrebbe includere input rappresentativi e casi difficili che non siano semplici copie delle dimostrazioni. È necessario conservare le risposte e registrare gli errori, evitando di selezionare soltanto i successi che confermano una prima impressione.
Il confronto può misurare l’accuratezza delle etichette, la quota di campi omessi o errati, il rispetto del formato e il numero di casi che richiedono una revisione. La metrica appropriata dipende dall’obiettivo: una classificazione di richieste di assistenza non si valuta come l’estrazione di importi. Se gli errori in alcune categorie hanno conseguenze diverse, vanno analizzati separatamente.
Un test di piccole dimensioni può far emergere problemi di progettazione, ma non garantisce che il comportamento si mantenga in produzione. Se cambiano la distribuzione delle richieste, i documenti o il linguaggio dei clienti, anche i risultati possono cambiare. È quindi opportuno verificare gli esempi su dati pertinenti e ripetere la valutazione quando mutano il compito o le condizioni d’uso.
Un semplice test comparativo
L’obiettivo è stimare se le dimostrazioni migliorano le prestazioni su casi che non sono stati usati per prepararle. Il confronto, da solo, non dimostra un meccanismo interno.
- 01Definire il compito, l’output atteso e i criteri di errore prima di iniziare il test.
- 02Separare gli esempi usati per progettare la richiesta dai casi di valutazione; non valutare soltanto le dimostrazioni mostrate.
- 03Eseguire la stessa istruzione senza dimostrazioni e con dimostrazioni, in condizioni comparabili.
- 04Confrontare successi, errori, omissioni, formato e casi che richiedono una revisione.
- 05Rivedere esempi e risultati se il miglioramento è discontinuo o riguarda soprattutto i casi semplici.
Criteri pratici e concetti correlati
L’ICL può essere una scelta ragionevole quando il compito si può descrivere chiaramente, gli esempi rientrano nel contesto disponibile e l’output è verificabile. Prima di adottarlo, controlla che ogni dimostrazione sia corretta, che i nuovi casi siano sufficientemente simili al compito previsto e che esista una risposta accettabile per le situazioni ambigue o fuori ambito.
Se gli esempi non migliorano i risultati su casi rappresentativi, conviene innanzitutto rivedere la definizione del compito, le etichette, il formato e la selezione dei casi. Se è necessaria la persistenza tra più interazioni o un cambiamento duraturo del comportamento, aggiungere esempi a ogni richiesta non risolve da solo questa esigenza. Il confronto tra ICL e fine-tuning tramite istruzioni compare anche nella ricerca sui modelli piccoli e multilingue, ma un’osservazione su tale confronto non basta a stabilire quale metodo sia preferibile per ogni modello o compito.
Per approfondire, consulta il percorso del glossario, la voce correlata sull’apprendimento in contesto e la sezione dei confronti. I nomi interni corrispondono a «glossary.index», «glossary:in-context-learning» e «compare.index»; la disponibilità e i contenuti di questi percorsi dipendono dal sito.