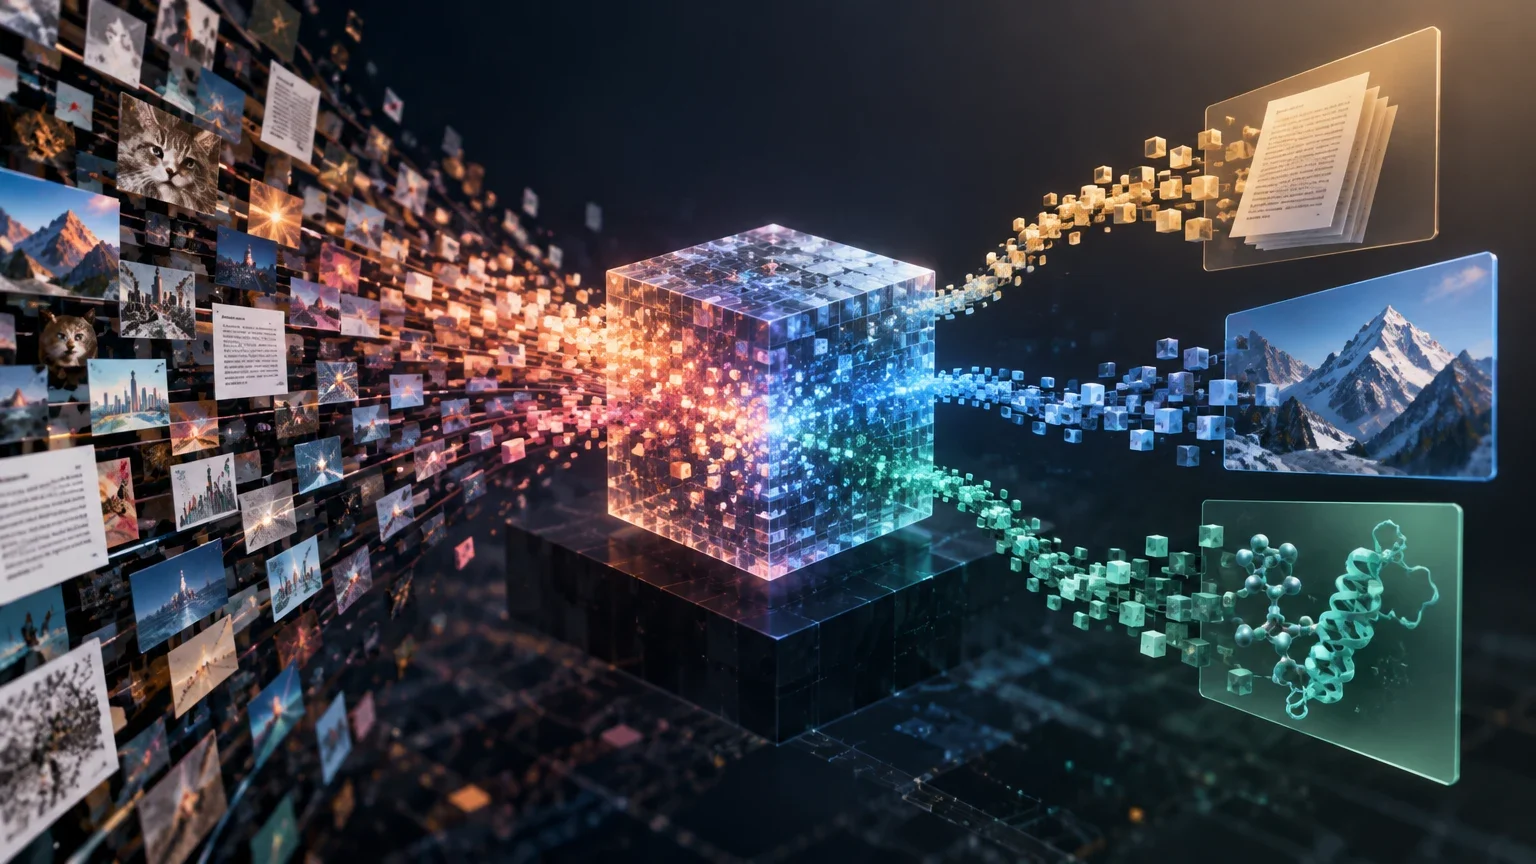
Introduzione: il pre-addestramento come fase preliminare alla specializzazione
Il pre-addestramento è la fase in cui un modello di machine learning viene addestrato prima di essere adattato a un compito specifico. Invece di partire da un'inizializzazione casuale per risolvere direttamente un problema specifico, il modello apprende rappresentazioni generali a partire da un ampio insieme di dati. Questa fase è particolarmente rilevante nei modelli su larga scala, dove il costo computazionale per costruire un sistema da zero può essere elevato e le rappresentazioni apprese possono essere riutilizzate in molteplici applicazioni successive.
L'importanza del pre-addestramento non risiede solo nella velocità di sviluppo, ma anche nella possibilità di sfruttare conoscenza pregressa. Un modello che ha già osservato pattern generali del linguaggio, delle immagini o di altri segnali può partire da una base più solida quando gli viene presentato un dominio più ristretto. In questo modo, il team di ingegneria può dedicare più sforzo alla qualità dei dati del compito finale, alla valutazione e all'integrazione del sistema, anziché ripetere un addestramento iniziale costoso.
Tuttavia, il pre-addestramento non elimina la necessità di validare il modello per ogni caso d'uso. Le rappresentazioni apprese dipendono dal corpus, dall'architettura, dall'obiettivo di addestramento e dai vincoli dei dati. Nella pratica attuale, il pre-addestramento è inteso come una fase esplicita del ciclo di vita del modello, separata dall'adattamento successivo. Per questo, una scheda tecnica su questo concetto deve distinguere tra ciò che è affermato come pratica abituale e ciò che richiede evidenza specifica per ogni configurazione.
Definizione tecnica e ambito della fase
Tecnicamente, il pre-addestramento può essere definito come l'addestramento iniziale di un modello con un obiettivo di apprendimento che non è necessariamente legato al compito finale. In molti casi, questo obiettivo è auto-supervisionato: il modello predice parti del dato stesso, come parole mascherate nel testo o regioni di un'immagine, senza richiedere etichette umane complete. Il segnale di supervisione deriva dalla struttura del dato, il che consente di scalare l'addestramento a grandi volumi senza dipendere esclusivamente dall'annotazione manuale.
L'ambito della fase include la selezione dell'architettura, la preparazione del corpus, la definizione della funzione di perdita o della funzione di ricompensa, la configurazione degli iperparametri e l'ottimizzazione dei parametri interni. Il risultato non è un sistema finito per la produzione, ma un insieme di pesi che incapsula pattern generali. Questi pesi possono essere utilizzati come punto di partenza per un fine-tuning, per un'estrazione di caratteristiche o per una valutazione successiva.
È utile separare il pre-addestramento dall'addestramento del compito finale. Il primo cerca di costruire una rappresentazione ampia; il secondo cerca di specializzarla. Nella pratica, entrambi sono processi di addestramento, ma differiscono per dati, obiettivo, scala e criteri di successo. Confonderli può portare a aspettarsi che un modello pre-addestrato risolva direttamente un compito senza adattamento, o a sottovalutare la necessità di valutarne il comportamento nel dominio di destinazione.
Processo tipico: dati, obiettivo e architettura
Un processo di pre-addestramento inizia solitamente con la definizione del dominio dei dati. Nel linguaggio naturale, il corpus può includere testi da internet, documenti tecnici o conversazioni; nella visione, può includere immagini etichettate o non etichettate; in altri ambiti, può includere segnali, serie temporali o dati strutturati. La qualità, la diversità e la rappresentatività del corpus condizionano quali pattern il modello apprenderà e quali bias potrebbe incorporare.
Successivamente si sceglie l'obiettivo di apprendimento. Nei modelli linguistici, un obiettivo comune è prevedere token mancanti o la parola successiva; nella visione, può essere classificare immagini, ricostruire regioni o apprendere rappresentazioni contrastive. L'obiettivo determina la funzione di perdita e il modo in cui il modello riceve feedback. Se l'obiettivo è troppo stretto, la rappresentazione può diventare meno riutilizzabile; se è troppo generico, potrebbe non catturare i dettagli necessari per compiti successivi.
L'architettura definisce come le entrate vengono trasformate in rappresentazioni interne. Le reti neurali profonde, i transformer e altre strutture consentono di catturare relazioni a lungo raggio, gerarchie visive o pattern sequenziali. Durante il pre-addestramento, i parametri vengono regolati iterativamente mediante ottimizzatori, controllo dei batch, programmazione del tasso di apprendimento e tecniche di stabilità. Il processo si ripete finché il modello non raggiunge una prestazione accettabile sull'obiettivo scelto, anche se questa prestazione non equivale al successo nel compito finale.
Flusso operativo semplificato
Sequenza minima per pianificare un pre-addestramento o valutarne uno esistente.
- 01Definire il dominio e la qualità del corpus
- 02Scegliere architettura e obiettivo di apprendimento
- 03Configurare funzione di perdita, ottimizzatore e iperparametri
- 04Addestrare con validazione e controllo dell'overfitting
- 05Valutare il riutilizzo dei pesi in compiti correlati
Esempi applicati in linguaggio, visione e biomedicina
Nel linguaggio naturale, un esempio chiaro è l'adattamento di un modello linguistico pre-addestrato per classificare recensioni. Il modello parte da pesi addestrati su testo ampio e viene poi adattato con un insieme di recensioni etichettate. Nel caso documentato, si utilizza un modello tipo BERT, si tokenizzano le recensioni, si aggiunge un head di classificazione inizializzato casualmente e si addestra l'intero insieme o una parte dei parametri per distinguere categorie di opinione. Questo flusso mostra come il pre-addestramento riduca la necessità di costruire un classificatore da zero.
Nella visione artificiale, il pre-addestramento appare quando un modello ha appreso caratteristiche visive di base su un ampio insieme di immagini e viene poi trasferito a un compito di rilevamento, segmentazione o classificazione. Ad esempio, pesi addestrati su un corpus di oggetti quotidiani possono servire per iniziare l'addestramento in un dominio industriale, medico o di sicurezza. La documentazione tecnica descrive che questo trasferimento può accelerare l'addestramento e migliorare le prestazioni perché il modello parte da una comprensione solida di bordi, texture e forme.
Nell'ambito biomedico, la stessa logica si applica quando si desidera adattare un modello di visione o di linguaggio a immagini mediche, referti clinici o dati di ricerca. Tuttavia, le fonti fornite non descrivono un esperimento biomedico specifico con metriche verificabili, quindi questo esempio deve essere letto come un'applicazione plausibile del transfer learning, non come un risultato dimostrato. In questo dominio, inoltre, la valutazione deve essere particolarmente rigorosa a causa delle implicazioni cliniche, regolatorie e di privacy.
Confusioni frequenti con fine-tuning e inferenza
Una confusione abituale è trattare il pre-addestramento e il fine-tuning come se fossero la stessa cosa. Entrambi implicano l'aggiornamento dei parametri, ma non perseguono lo stesso fine. Il pre-addestramento costruisce una rappresentazione generale; il fine-tuning specializza quella rappresentazione per un compito o un dominio. Nella pratica, il fine-tuning usa solitamente meno dati del pre-addestramento, anche se può richiedere attenzione per non degradare la conoscenza pregressa.
Un'altra confusione consiste nell'assumere che un modello pre-addestrato sia pronto per l'inferenza diretta. L'inferenza è la fase in cui il modello già addestrato produce previsioni su nuove entrate. Un modello pre-addestrato può essere usato per l'inferenza nel suo compito originale, ma se il compito finale è diverso, normalmente necessita di adattamento. Inoltre, l'inferenza non aggiorna i pesi; li utilizza solo.
È anche frequente confondere il pre-addestramento con il semplice caricamento dei pesi. Caricare un modello pre-addestrato non garantisce che sia adatto al problema. Bisogna verificare la compatibilità dell'architettura, del vocabolario, della dimensione di input, della licenza, della qualità del corpus e del comportamento nel dominio di destinazione. È anche utile posizionare il pre-addestramento rispetto ad altre tecniche di trasferimento, come la distillazione dei modelli, che cerca di trasferire il comportamento tra modelli, e rispetto all'inferenza, che non aggiorna i parametri.
Differenze operative
Tabella di decisione per distinguere le fasi.
| Aspetto | Pre-addestramento | Fine-tuning | Inferenza |
|---|---|---|---|
| Obiettivo | Costruire rappresentazioni generali | Specializzare il modello per un compito | Produrre previsioni senza aggiornare i pesi |
| Dati | Corpus ampio, spesso non etichettato | Dati specifici del compito | Nuove entrate in tempo di utilizzo |
| Aggiornamento dei parametri | Sì, su larga scala | Sì, spesso parziale o completo | No |
| Rischio principale | Bias del corpus e costo | Overfitting o degradazione della conoscenza pregressa | Latenza, precisione e deployment |
Limiti intrinseci e considerazioni pratiche
Il pre-addestramento non elimina la necessità di dati di qualità per il compito finale. Se il dominio di destinazione differisce molto dal corpus iniziale, le rappresentazioni apprese possono essere insufficienti o controproducenti. In questi casi, potrebbe essere necessario espandere il corpus, cambiare l'obiettivo di pre-addestramento, usare un modello diverso o addestrare da zero. La decisione deve basarsi su valutazioni comparative, non sull'assunzione che un modello grande o popolare sia automaticamente il migliore.
Esistono anche limiti pratici legati alle risorse computazionali, alla memoria, al tempo di addestramento e alla stabilità. Il pre-addestramento di modelli grandi può richiedere più acceleratori, strategie di precisione mista, controllo dei batch e tecniche di efficienza. In progetti con risorse limitate, può essere più ragionevole usare un modello pre-addestrato più piccolo o un sottoinsieme di dati per iterare rapidamente, anche se ciò non sostituisce la validazione finale.
La valutazione deve considerare metriche del compito, robustezza, bias, privacy e requisiti regolatori. Un modello può migliorare su un insieme di validazione e fallire su popolazioni sottorappresentate, in condizioni di rumore o su entrate fuori distribuzione. Per questo, i criteri pratici includono test su dati rappresentativi, analisi degli errori, confronto con baseline e documentazione dei limiti noti.
Questioni aperte
- Le fonti non consentono di verificare un caso biomedico specifico con metriche comparative; l'esempio biomedico è presentato come applicazione plausibile.
- Non si può affermare che il pre-addestramento riduca sempre i costi o migliori sempre le prestazioni; dipende dall'architettura, dal corpus, dal compito e dalle risorse.
- La documentazione fornita non stabilisce una peer review né una replica indipendente dei risultati descritti.
- Non è disponibile evidenza sufficiente per generalizzare le raccomandazioni di uno strumento di visione a tutti i modelli di machine learning.
Continua a esplorare
Fonti consultate
Correzioni e trasparenza
Se trovi un dato errato o non aggiornato, inviaci la pagina e la fonte da verificare.
Proponi una correzione