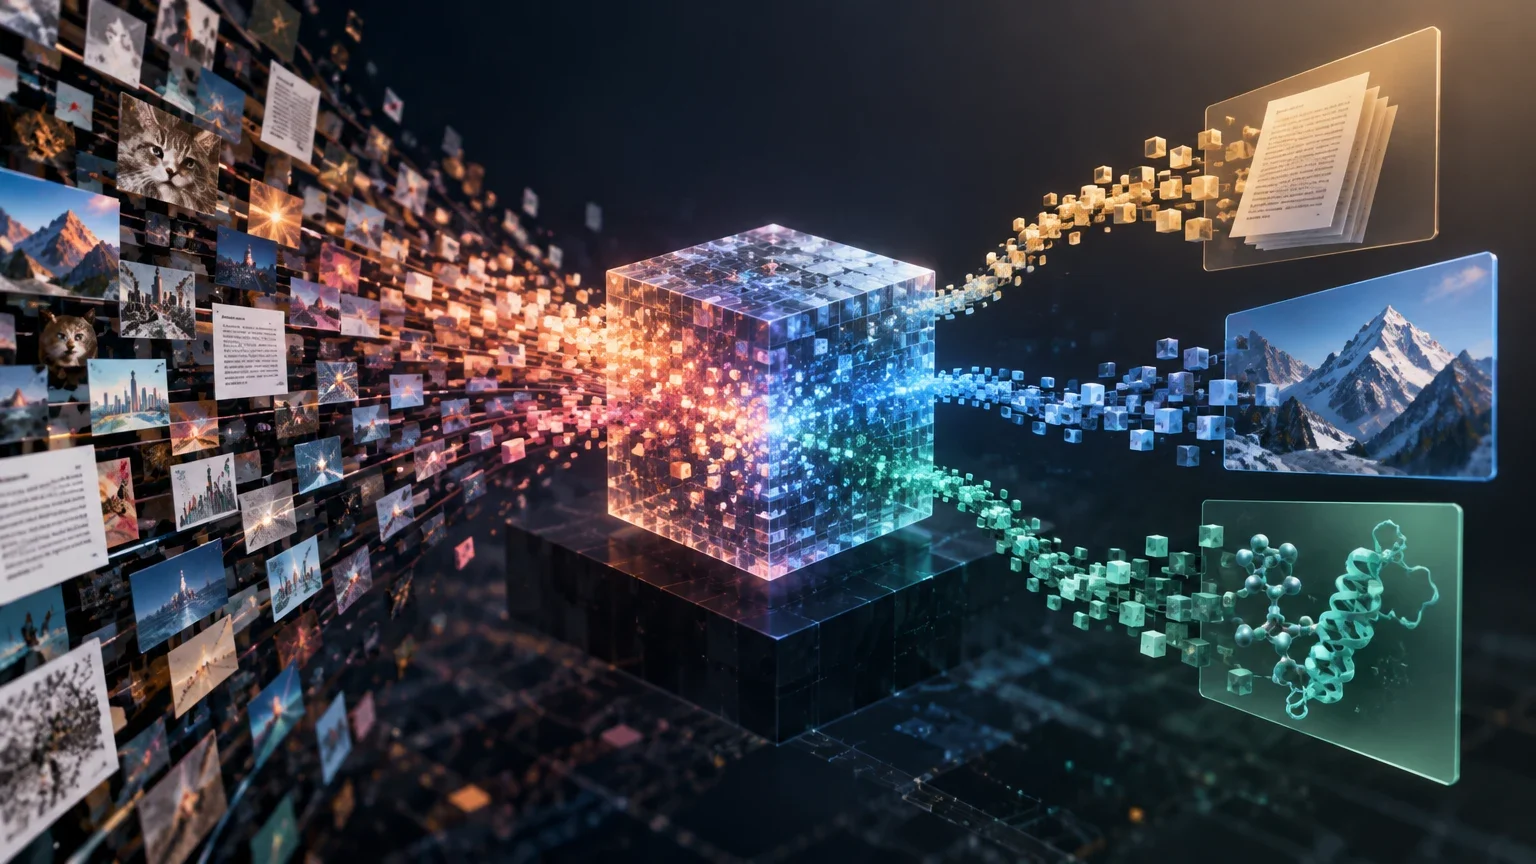
Introdução: o pré-treinamento como fase anterior à especialização
O pré-treinamento é a fase em que um modelo de aprendizado de máquina é treinado antes de ser adaptado a uma tarefa concreta. Em vez de começar com uma inicialização aleatória para resolver diretamente um problema específico, o modelo aprende representações gerais a partir de um conjunto de dados amplo. Esta fase é especialmente relevante em modelos de grande escala, onde o custo computacional de construir um sistema do zero pode ser elevado e onde as representações aprendidas podem ser reutilizadas em múltiplas aplicações posteriores.
A importância do pré-treinamento não reside apenas na velocidade de desenvolvimento, mas também na possibilidade de aproveitar conhecimento prévio. Um modelo que já observou padrões gerais da linguagem, das imagens ou de outros sinais pode partir de uma base mais sólida quando apresentado a um domínio mais restrito. Dessa forma, a equipe de engenharia pode dedicar mais esforço à qualidade dos dados da tarefa final, à avaliação e à integração do sistema, em vez de reproduzir um treinamento inicial custoso.
Ainda assim, o pré-treinamento não elimina a necessidade de validar o modelo para cada caso de uso. As representações aprendidas dependem do corpus, da arquitetura, do objetivo de treinamento e das restrições de dados. Na prática atual, o pré-treinamento é entendido como uma fase explícita do ciclo de vida do modelo, separada da adaptação posterior. Por isso, uma ficha técnica sobre este conceito deve distinguir entre o que é afirmado como prática habitual e o que requer evidência específica para cada configuração.
Definição técnica e escopo da fase
Tecnicamente, o pré-treinamento pode ser definido como o treinamento inicial de um modelo com um objetivo de aprendizado que não está necessariamente ligado à tarefa final. Em muitos casos, esse objetivo é autorregulado: o modelo prevê partes do próprio dado, como palavras mascaradas em texto ou regiões de uma imagem, sem exigir rótulos humanos completos. O sinal de supervisão é derivado da estrutura do dado, o que permite escalar o treinamento para grandes volumes sem depender exclusivamente de anotação manual.
O escopo da fase inclui a seleção da arquitetura, a preparação do corpus, a definição da função de perda ou da função de recompensa, a configuração de hiperparâmetros e a otimização dos parâmetros internos. O resultado não é um sistema finalizado para produção, mas um conjunto de pesos que encapsula padrões gerais. Esses pesos podem ser usados como ponto de partida para um ajuste fino, para uma extração de características ou para uma avaliação posterior.
É útil separar o pré-treinamento do treinamento da tarefa final. O primeiro busca construir uma representação ampla; o segundo busca especializá-la. Na prática, ambos são processos de treinamento, mas diferem em dados, objetivo, escala e critérios de sucesso. Confundi-los pode levar a esperar que um modelo pré-treinado resolva diretamente uma tarefa sem adaptação, ou a descartar a necessidade de avaliar seu comportamento no domínio objetivo.
Processo típico: dados, objetivo e arquitetura
Um processo de pré-treinamento geralmente começa com a definição do domínio de dados. Em linguagem natural, o corpus pode incluir textos da internet, documentos técnicos ou conversas; em visão, pode incluir imagens rotuladas ou não rotuladas; em outros campos, pode incluir sinais, séries temporais ou dados estruturados. A qualidade, a diversidade e a representatividade do corpus condicionam quais padrões o modelo aprenderá e quais vieses pode incorporar.
Em seguida, escolhe-se o objetivo de aprendizado. Em modelos de linguagem, um objetivo comum é prever tokens ausentes ou a próxima palavra; em visão, pode ser classificar imagens, reconstruir regiões ou aprender representações contrastivas. O objetivo determina a função de perda e a forma como o modelo recebe feedback. Se o objetivo for muito estreito, a representação pode se tornar menos reutilizável; se for muito genérico, pode não capturar detalhes necessários para tarefas posteriores.
A arquitetura define como as entradas são transformadas em representações internas. Redes neurais profundas, transformers e outras estruturas permitem capturar relações de longo alcance, hierarquias visuais ou padrões sequenciais. Durante o pré-treinamento, os parâmetros são ajustados iterativamente por meio de otimizadores, controle de lotes, programação de taxa de aprendizado e técnicas de estabilidade. O processo se repete até que o modelo alcance um desempenho aceitável no objetivo escolhido, embora esse desempenho não equivalha a sucesso na tarefa final.
Fluxo operacional simplificado
Sequência mínima para planejar um pré-treinamento ou avaliar um existente.
- 01Definir o domínio e a qualidade do corpus
- 02Escolher arquitetura e objetivo de aprendizado
- 03Configurar função de perda, otimizador e hiperparâmetros
- 04Treinar com validação e controle de sobreajuste
- 05Avaliar a reutilização dos pesos em tarefas relacionadas
Exemplos aplicados em linguagem, visão e biomédico
Em linguagem natural, um exemplo claro é o ajuste de um modelo de linguagem pré-treinado para classificar avaliações. O modelo parte de pesos treinados em texto amplo e depois é adaptado com um conjunto de avaliações rotuladas. No caso documentado, utiliza-se um modelo tipo BERT, as avaliações são tokenizadas, adiciona-se um cabeçalho de classificação inicializado aleatoriamente e treina-se o conjunto completo ou parte dos parâmetros para distinguir categorias de opinião. Este fluxo mostra como o pré-treinamento reduz a necessidade de construir um classificador do zero.
Em visão computacional, o pré-treinamento aparece quando um modelo aprendeu características visuais básicas em um conjunto de imagens amplo e depois é transferido para uma tarefa de detecção, segmentação ou classificação. Por exemplo, pesos treinados em um corpus de objetos cotidianos podem servir para iniciar o treinamento em um domínio industrial, médico ou de segurança. A documentação técnica descreve que essa transferência pode acelerar o treinamento e melhorar o desempenho porque o modelo parte de uma compreensão sólida de bordas, texturas e formas.
No âmbito biomédico, a mesma lógica se aplica quando se deseja adaptar um modelo de visão ou de linguagem a imagens médicas, relatórios clínicos ou dados de pesquisa. No entanto, as fontes fornecidas não descrevem um experimento biomédico concreto com métricas verificáveis, portanto, este exemplo deve ser lido como uma aplicação plausível da transferência de aprendizado, não como um resultado demonstrado. Neste domínio, além disso, a avaliação deve ser especialmente rigorosa devido às implicações clínicas, regulatórias e de privacidade.
Confusões frequentes com ajuste fino e inferência
Uma confusão habitual é tratar o pré-treinamento e o ajuste fino como se fossem a mesma coisa. Ambos envolvem atualizar parâmetros, mas não perseguem o mesmo fim. O pré-treinamento constrói uma representação geral; o ajuste fino especializa essa representação para uma tarefa ou domínio. Na prática, o ajuste fino geralmente usa menos dados que o pré-treinamento, embora possa exigir cuidado para não degradar o conhecimento prévio.
Outra confusão consiste em assumir que um modelo pré-treinado está pronto para inferência direta. A inferência é a etapa em que o modelo já treinado produz previsões sobre novas entradas. Um modelo pré-treinado pode ser usado para inferência em sua tarefa original, mas se a tarefa final for diferente, normalmente necessita de adaptação. Além disso, a inferência não atualiza os pesos; apenas os utiliza.
Também é frequente confundir o pré-treinamento com a simples carga de pesos. Carregar um modelo pré-treinado não garante que seja adequado para o problema. É necessário verificar a compatibilidade da arquitetura, o vocabulário, o tamanho de entrada, a licença, a qualidade do corpus e o comportamento no domínio objetivo. Também é útil situar o pré-treinamento em relação a outras técnicas de transferência, como a destilação de modelos, que busca transferir comportamento entre modelos, e em relação à inferência, que não atualiza parâmetros.
Diferenças operacionais
Tabela de decisão para distinguir fases.
| Aspecto | Pré-treinamento | Ajuste fino | Inferência |
|---|---|---|---|
| Objetivo | Construir representações gerais | Especializar o modelo para uma tarefa | Produzir previsões sem atualizar pesos |
| Dados | Corpus amplo, frequentemente não rotulado | Dados específicos da tarefa | Entradas novas em tempo de uso |
| Atualização de parâmetros | Sim, em grande escala | Sim, com frequência parcial ou completa | Não |
| Risco principal | Vieses do corpus e custo | Sobreajuste ou degradação do conhecimento prévio | Latência, precisão e implantação |
Limites inerentes e considerações práticas
O pré-treinamento não elimina a necessidade de dados de qualidade para a tarefa final. Se o domínio objetivo diferir muito do corpus inicial, as representações aprendidas podem ser insuficientes ou contraproducentes. Nesses casos, pode ser necessário ampliar o corpus, mudar o objetivo de pré-treinamento, usar um modelo diferente ou treinar do zero. A decisão deve basear-se em avaliações comparativas, não na suposição de que um modelo grande ou popular é automaticamente o melhor.
Também existem limites práticos relacionados com recursos computacionais, memória, tempo de treinamento e estabilidade. O pré-treinamento de modelos grandes pode requerer múltiplos aceleradores, estratégias de precisão mista, controle de lotes e técnicas de eficiência. Em projetos com recursos limitados, pode ser mais razoável usar um modelo pré-treinado menor ou um subconjunto de dados para iterar rapidamente, embora isso não substitua a validação final.
A avaliação deve considerar métricas da tarefa, robustez, vieses, privacidade e requisitos regulatórios. Um modelo pode melhorar em um conjunto de validação e falhar em populações sub-representadas, em condições de ruído ou em entradas fora da distribuição. Por isso, os critérios práticos incluem testes em dados representativos, análise de erros, comparação com linhas de base e documentação das limitações conhecidas.
Questões em aberto
- As fontes não permitem verificar um caso biomédico concreto com métricas comparativas; o exemplo biomédico é apresentado como aplicação plausível.
- Não se pode afirmar que o pré-treinamento reduza sempre o custo ou melhore sempre o desempenho; depende da arquitetura, do corpus, da tarefa e dos recursos.
- A documentação fornecida não estabelece uma revisão por pares nem uma replicação independente dos resultados descritos.
- Não há evidência suficiente para generalizar as recomendações de uma ferramenta de visão para todos os modelos de aprendizado de máquina.
Continue a explorar
Fontes consultadas
Correções e transparência
Se encontrar informação incorreta ou desatualizada, envie-nos a página e a fonte que devemos rever.
Propor uma correção