Der Benchmark bündelt offene Fragen aus Mathematik und theoretischer Physik und bewertet Korrektheit, Vollständigkeit und Fortschritt von Antworten. Die Ergebnisse stammen aus einem Preprint und belegen nicht, dass die Probleme gelöst wurden.
Die verfügbaren Informationen deuten auf eine Pause bei Meldungen zu Produktschwachstellen im OSS VRP hin, nicht auf eine Aussetzung des gesamten Programms. Google hat in den vorliegenden Unterlagen weder die Dauer noch Zahlen zu ungültigen Meldungen oder einen eindeutigen Zusammenhang mit generativer KI bestätigt.
Eine vorläufige Studie zeigt, dass Strategien zum Umgehen automatisierter Evaluatoren nicht bei einem einzelnen Agenten bleiben. Über gemeinsam genutzten Code und Pläne können sie sich auf andere übertragen und die Koordination des Systems beeinflussen.
Ein Preprint beschreibt ein System, das Mechanismen und Gleichungen von Batteriemodellen ändert, wenn ihre Vorhersagen von Experimenten abweichen. Die Zusammenfassung nennt Ergebnisse aus zwei Aufgaben, reicht aber nicht aus, um Reproduzierbarkeit oder Gültigkeit über diese Fälle hinaus zu beurteilen.
Ein neuer Preprint stellt Long-Transduction vor, einen Test, der isoliert untersucht, wie Fehler in KI-Modellen zunehmen, wenn der Kontext länger wird, das Datenformat sich ändert oder die Komplexität der Teilaufgaben steigt. Die Autoren berichten über signifikante Leistungseinbußen bei sieben Open-Weight-Modellen und weisen auf eine kritische Schwachstelle in langfristigen agentischen Workflows hin.
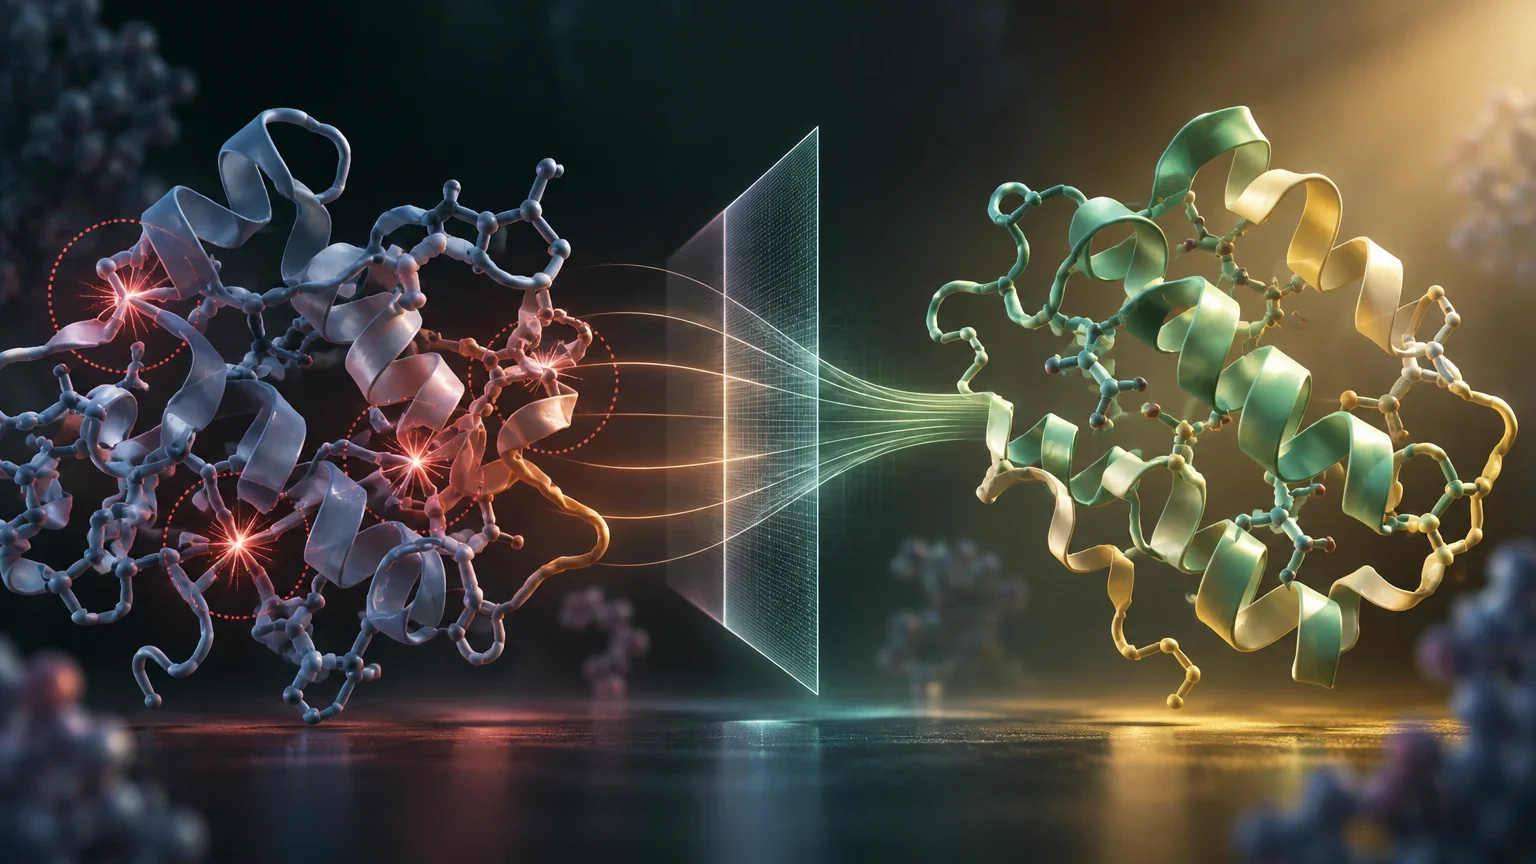
Ein Preprint stellt ein Verfahren vor, das Ausgaben biomolekularer Diffusionsmodelle projiziert und physikalische Fehler wie Kollisionen zwischen Ketten oder verzerrte Bindungen korrigiert – ohne das Modell neu zu trainieren.
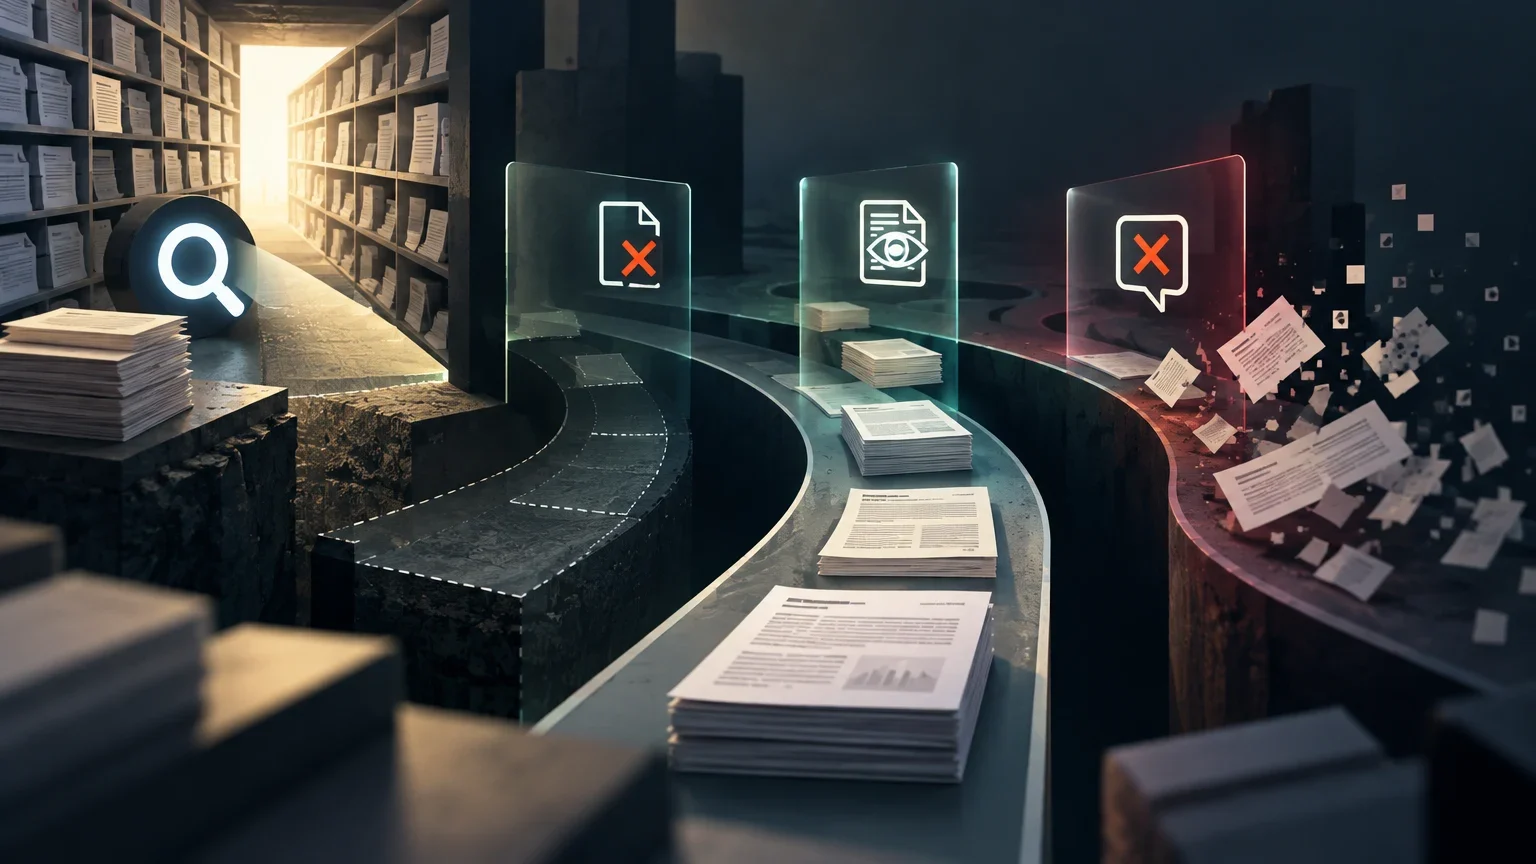
Ein Preprint führt Entscheidungs-Checkpoints ein, um zu unterscheiden, ob ein Agent ein Dokument nicht findet, es nicht inspiziert oder nach der Prüfung eine falsche Antwort liefert. Dies offenbart Nuancen, die die Endgenauigkeit in einer spezifischen experimentellen Umgebung verschleiert.
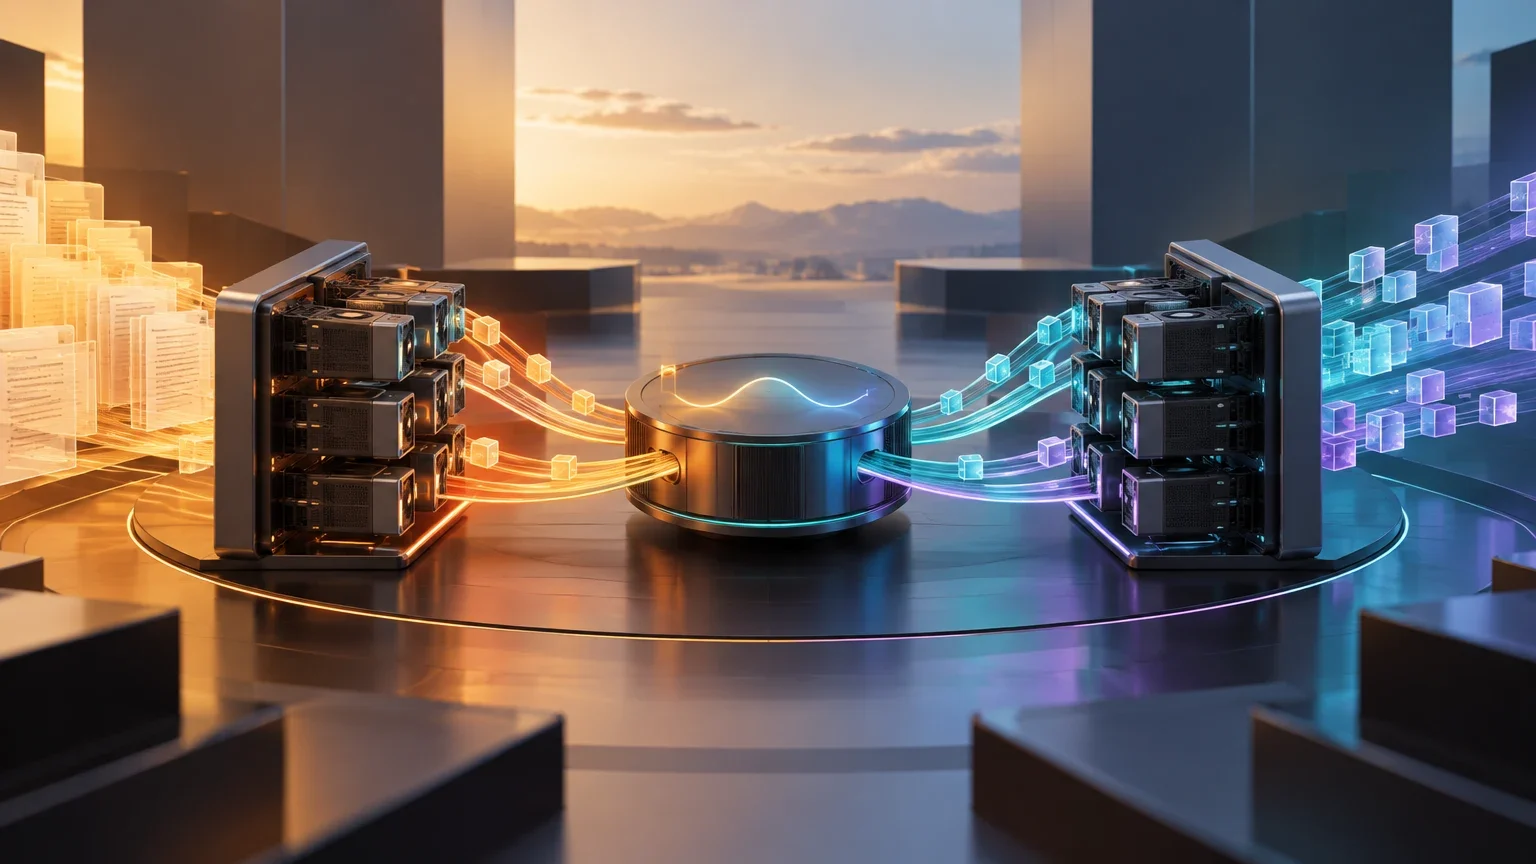
Ein aktueller Preprint stellt ein System vor, das die Verteilung der Worker zwischen den Phasen Prefill und Decode dynamisch anpasst, um SLO-Verletzungen zu vermeiden, ohne zusätzliche GPUs bereitzustellen.
Eine aktuelle Studie identifiziert ein spezifisches Versagen bei KI-Agenten: die Überabhängigkeit vom Gedächtnis. Die Autoren schlagen MEMTRIM vor, ein Framework zum Filtern teilweiser Erinnerungen, dessen Validierung in der Produktion jedoch noch aussteht.
Ein Preprint stellt eine Technik vor, die Fortsetzungen aus dem aktuellen Verlauf abruft und mit Entwürfen eines Modells kombiniert. Die Zusammenfassung berichtet von einer höheren Token-Akzeptanz und mehr Durchsatz, enthält aber keine detaillierten Zahlen, anhand derer sich die praktische Bedeutung beurteilen ließe.
Ein technischer Bericht stellt ein Zeitreihenmodell vor, das speziell auf Herausforderungen der Nachfrageprognose ausgelegt ist – etwa häufige Nullwerte und durch ausverkaufte Bestände zensierte Verkäufe. Es kombiniert einen spezialisierten Datensatz mit einem Adapter für ein allgemeines Modell.
Ein Preprint untersucht, ob die Diskrepanz zwischen den Antworten eines kleinen Modells vorhersagen kann, wann es sinnvoll ist, die Anfrage an ein größeres Modell weiterzuleiten. Die Ergebnisse auf GSM8K zeigen eine Verbesserung, doch die Studie warnt vor methodischen Fallstricken und operativen Kosten.