Die Einschränkung der Bewertung nur anhand der Endantwort
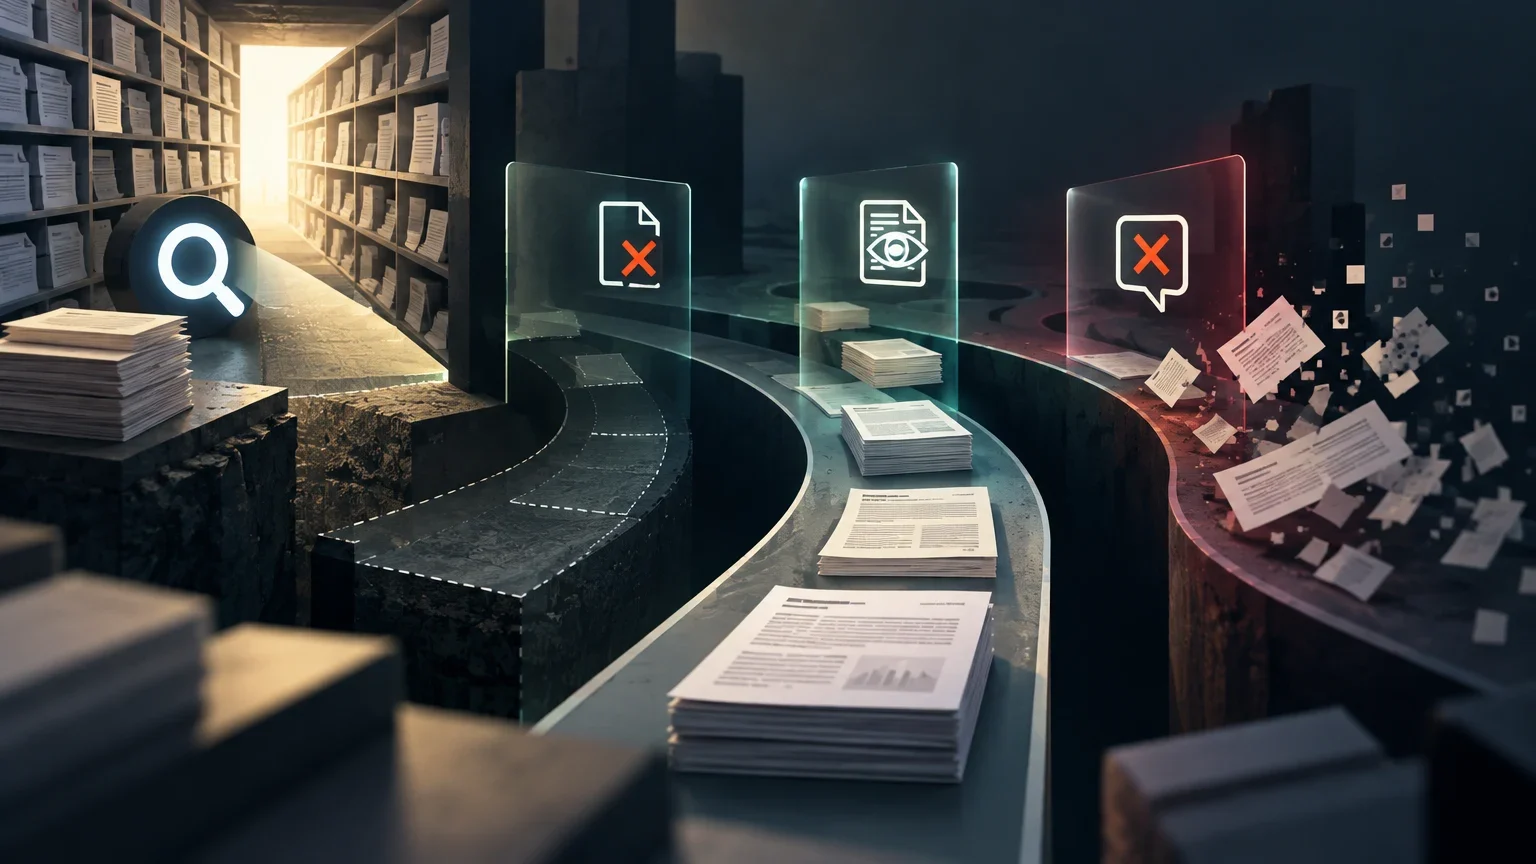
Die traditionelle Bewertung von Agenten für die wissenschaftliche Literatursuche konzentriert sich auf die Genauigkeit der finalen Antwort. Diese Metrik gruppiert jedoch heterogene Fehler zusammen: Ein Agent kann fehlschlagen, weil er das Zieldokument nicht findet, weil er es zwar findet, aber nicht inspiziert, oder weil er es inspiziert, aber eine falsche Antwort generiert.
Diese Opazität erschwert die Verbesserung der Systeme, da sie nicht erlaubt, die spezifische Stufe zu identifizieren, an der der Fehler auftritt. Ein kürzlich veröffentlichter Preprint adressiert diese Einschränkung, indem er eine Auditmethode vorschlägt, die Zwischenereignisse während der Inferenz aufzeichnet und so eine granularere Kategorisierung der Fehler ermöglicht.
Die Aggregation heterogener Fehlerquellen in einer einzigen Genauigkeitsmetrik führt zu einer systematischen Verzerrung in der Diagnose von Schwachstellen. Wenn ein Agent ein Dokument nicht findet, wird dies in der Endantwort genauso gewichtet wie ein Fall, in dem das Dokument gefunden, aber falsch interpretiert wurde. Diese Gleichsetzung verhindert eine gezielte Optimierung der einzelnen Komponenten des Suchprozesses, da die spezifische Ursache des Scheiterns verschleiert bleibt und die Entwicklungsteams nicht wissen, ob sie an der Abrufungslogik oder an der Antwortgenerierung arbeiten müssen.
Entscheidungs-Checkpoints während der Suche
Die Studie führt 'Entscheidungs-Checkpoints' ein, die Beobachtungen und Werkzeugaktionen während der Inferenz aufzeichnen, ohne dabei Benchmark-Labels in Echtzeit zu verwenden. Diese Aufzeichnungen erfassen, ob der Agent das Zieldokument exponiert hat und ob er versucht hat, es zu inspizieren.
Anschließend werden die Identitäten der Ziele und die Labels des Evaluators mit den aufgezeichneten Ereignissen verknüpft, um Ergebnis-Kategorien zuzuweisen. Dieses Protokoll macht die Unterschiede auf Fragenebene explizit und trennt die Exposition und Inspektion des Ziels von der aggregierten Genauigkeit und der Gesamtzahl der Werkzeugaufrufe.
Die Trennung der Aufzeichnung von der nachträglichen Klassifizierung ist ein entscheidendes Designmerkmal, um die Integrität des Experiments zu wahren. Da die Labels der Benchmark während der Inferenz nicht verfügbar sind, kann der Agent nicht auf die erwartete Antwort hin optimiert werden, was eine Form von Datenleakage verhindert. Diese methodische Strenge stellt sicher, dass die aufgezeichneten Ereignisse ein authentisches Abbild des natürlichen Suchverhaltens des Agenten darstellen, ohne dass externe Hinweise die Entscheidungswege des Systems unzulässig beeinflussen oder die Ergebnisse künstlich verzerren.
Vorgeschlagener Audit-Workflow
Der Prozess zeichnet Ereignisse in Echtzeit auf und klassifiziert sie nachträglich.
- 01Aufzeichnung von Beobachtungen und Werkzeugaktionen während der Inferenz.
- 02Verknüpfung der Zielidentitäten und Evaluierungs-Labels.
- 03Zuweisung von Ergebnis-Kategorien basierend auf den aufgezeichneten Ereignissen.
Experimentelle Bedingungen und vergleichende Zahlen
Das Experiment wurde in einer festen, mit Zieldokumenten angereicherten Umgebung durchgeführt, wobei 540 beantwortbare Fragen aus AutoResearchBench Deep verwendet wurden. Es wurden fünf verschiedene Suchbedingungen evaluiert.
In diesem Kontext erreichte die Keyword-Suche eine Genauigkeit von 24,6 %, während die Rohsuche 17,8 % erzielte. Die Bedingung 'Zuerst lesen' verzeichnete 27,4 % mehr aufgezeichnete Aufrufe für die Evidenzsuche im Vergleich zur Keyword-Suche.
Die Wahl der 540 beantwortbaren Fragen aus dem AutoResearchBench Deep-Datensatz definiert den spezifischen Umfang der Testumgebung. Diese feste Menge an Fragen in einer angereicherten Umgebung schafft kontrollierte Bedingungen, unter denen die Unterschiede zwischen den Suchstrategien isoliert und gemessen werden können. Die Verwendung einer definierten Benchmark ermöglicht es, die Leistung der verschiedenen Bedingungen unter identischen Parametern zu vergleichen, was die Vergleichbarkeit der Ergebnisse innerhalb dieses spezifischen experimentellen Rahmens sicherstellt und statistische Schwankungen durch unkontrollierte Variablen minimiert.
Wichtige Ergebnisse des Experiments
Vergleich der Genauigkeit und der Werkzeugaktivität in ausgewählten Bedingungen.
| Bedingung | Genauigkeit | Zusätzliche Anmerkungen |
|---|---|---|
| Keyword-Suche | 24,6 % | Weniger falsche Antworten ohne Exposition oder Inspektion. |
| Rohsuche | 17,8 % | Niedrigere Genauigkeit in der festen Umgebung. |
| Zuerst lesen | 24,6 % | 27,4 % mehr Aufrufe für die Evidenzsuche. |
Trennung von Fehlern bei der Abrufung, Inspektion und Antwort
Die Daten zeigen, dass die Keyword-Suche weniger falsche Antworten hat, bei denen keine Exposition oder Inspektion des Ziels stattfand, aber mehr falsche Antworten, nachdem das Ziel exponiert wurde und nicht inspiziert wurde.
Versuche zur Inspektion des Ziels traten bei 199 Fragen unter der Bedingung 'Zuerst lesen' und bei 191 unter der Keyword-Suche auf. Beide Bedingungen erreichten die gleiche Genauigkeit von 24,6 %, was darauf hindeutet, dass die bloße Inspektion die Korrektheit der finalen Antwort nicht garantiert.
Das Phänomen, dass die bloße Inspektion eines Dokuments die Korrektheit der finalen Antwort nicht garantiert, deutet auf komplexe kognitive oder algorithmische Schritte hin, die nach der Exposition des Ziels erfolgen. Selbst wenn der Agent das relevante Dokument identifiziert und aufruft, kann er die darin enthaltenen Informationen falsch verarbeiten, relevante Details übersehen oder eine inkonsistente Schlussfolgerung ziehen. Dies unterstreicht, dass die Qualität der Antwortgenerierung ein eigenständiger Faktor ist, der unabhängig von der erfolgreichen Abrufung und Inspektion des Materials bewertet und verbessert werden muss.
Grenzen der Verallgemeinerung der Ergebnisse
Es ist entscheidend zu betonen, dass diese Ergebnisse aus einer festen, experimentellen Umgebung stammen, die mit Zieldokumenten angereichert wurde. Diese Konfiguration führt zu Verzerrungen, die die Komplexität der wissenschaftlichen Suche in offenen und dynamischen Umgebungen möglicherweise nicht widerspiegeln.
Darüber hinaus handelt es sich um einen Preprint, der im September 2026 eingereicht wurde, und er hat noch keinen Peer-Review durchlaufen. Die Zahlen und Schlussfolgerungen sollten als gültig für diese spezifische Konfiguration interpretiert werden und nicht als Beweis für die allgemeine Zuverlässigkeit von KI-Agenten in allen Kontexten der wissenschaftlichen Suche.
Die Tatsache, dass die Ergebnisse aus einem Preprint stammen, das noch keiner Peer-Review unterzogen wurde, erfordert eine besondere Vorsicht bei der Interpretation der quantitativen Daten. Bis zur offiziellen Validierung durch die wissenschaftliche Gemeinschaft können die spezifischen Prozentwerte und die beschriebenen Zusammenhänge zwischen den Suchbedingungen noch Änderungen unterliegen oder durch weitere Analysen in Frage gestellt werden. Daher sollten diese Zahlen als vorläufige Indikatoren für das Verhalten in der spezifischen Testumgebung betrachtet werden, die durch die angereicherte Konfiguration und die begrenzte Frageanzahl charakterisiert ist.
Offene Fragen
- Es werden keine genauen KI-Modelle für die fünf Bedingungen spezifiziert.
- Es wird nicht detailliert beschrieben, wie genau die angereicherte Umgebung aufgebaut wurde und welche spezifischen Verzerrungen sie einführt.
- Es werden keine öffentlichen Daten oder Spuren erwähnt, die es erlauben, die Fehlerkategorien zu reproduzieren.
- Die Studie ist ein Preprint, daher wurden ihre Schlussfolgerungen noch nicht durch einen Peer-Review validiert.
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen