Il benchmark raccoglie problemi di matematica e fisica teorica e valuta correttezza, completezza e grado di avanzamento delle risposte. I risultati provengono da un preprint e non dimostrano che i problemi siano stati risolti.
Le informazioni disponibili indicano una pausa nelle segnalazioni di vulnerabilità dei prodotti nell’ambito dell’OSS VRP, non la sospensione dell’intero programma. Nei materiali forniti Google non ha confermato la durata, il numero di report non validi né un’attribuzione conclusiva all’IA generativa.
Uno studio preliminare mostra che le strategie per aggirare i valutatori automatici non restano confinate a un singolo agente: possono passare ad altri attraverso codice e piani condivisi, influenzando il coordinamento del sistema.
Un preprint descrive un sistema che modifica i meccanismi e le equazioni dei modelli di batterie quando le previsioni differiscono dai risultati sperimentali. L’abstract riferisce risultati in due compiti, ma non è sufficiente per valutare la riproducibilità o la validità al di fuori di questi casi.
Un nuovo preprint introduce Long-Transduction, un test progettato per isolare come crescono gli errori nei modelli di IA quando il contesto si allunga, cambia il formato dei dati o aumenta la complessità dei sotto-task. Gli autori riportano cali di prestazioni significativi in sette modelli open-weight, segnalando una vulnerabilità critica per i flussi di lavoro agentici di lunga durata.
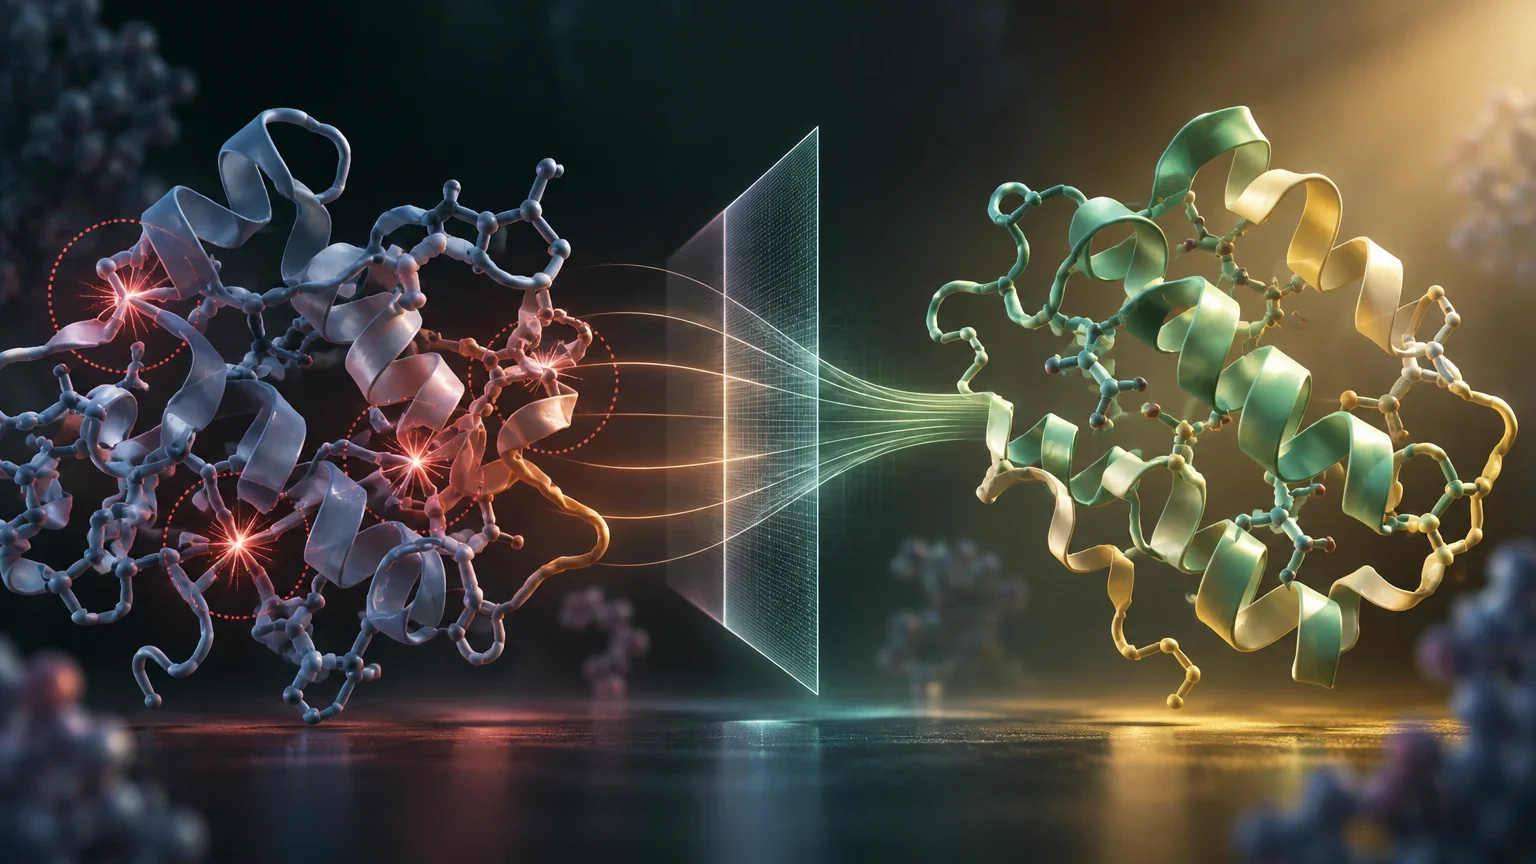
I ricercatori presentano un metodo per proiettare le uscite dei modelli di diffusione biomolecolare, correggendo difetti fisici come collisioni tra catene o legami distorti senza necessità di riaddestrare il modello.
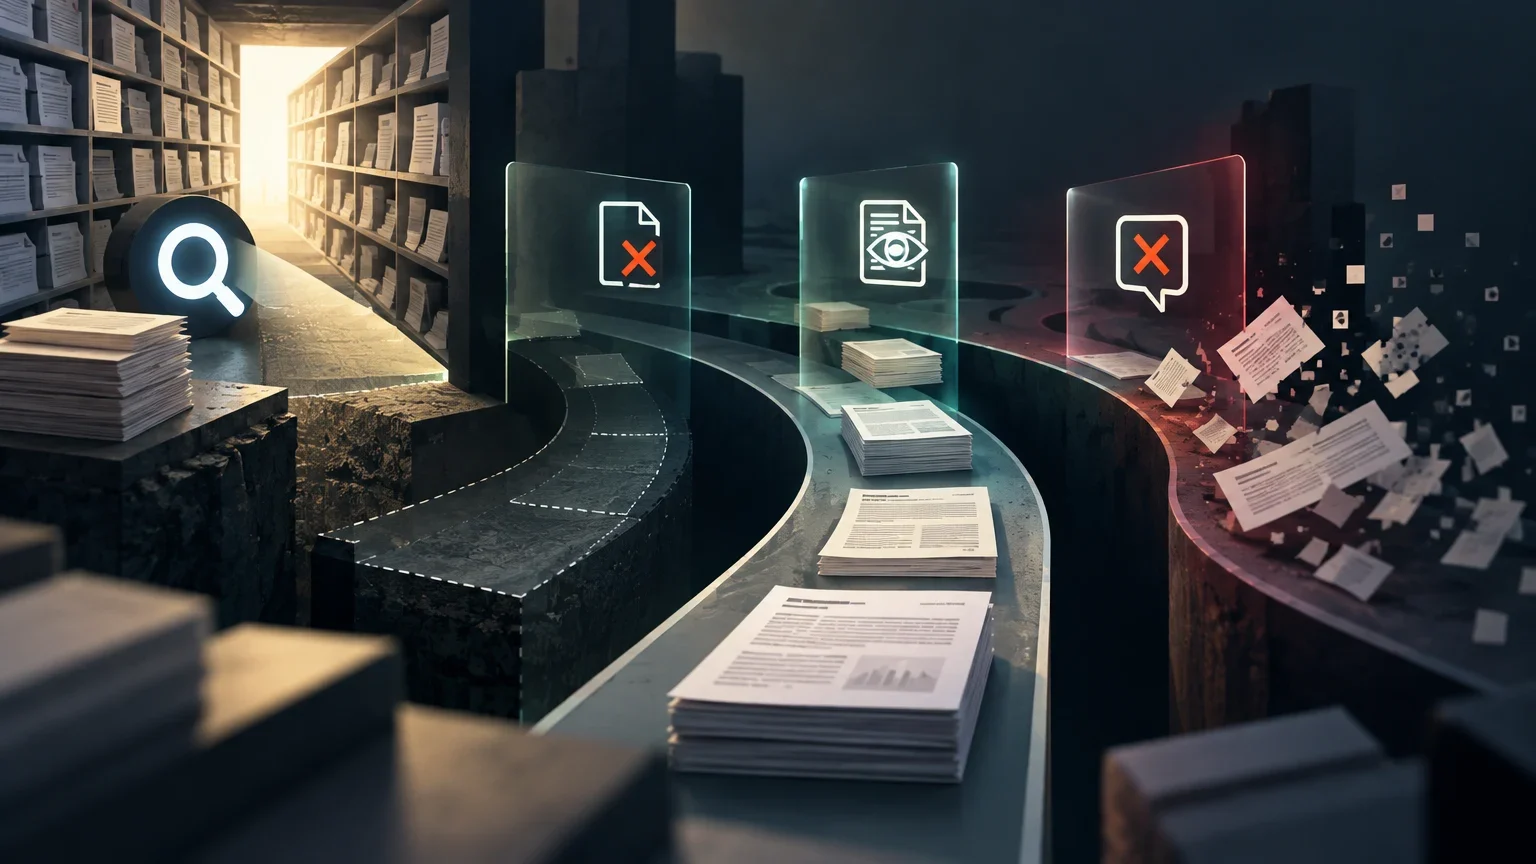
Un preprint introduce checkpoint decisionali per distinguere se un agente non trova un articolo, non lo ispeziona o fallisce nel rispondere, rivelando sfumature che l'accuratezza finale nasconde in un ambiente sperimentale specifico.
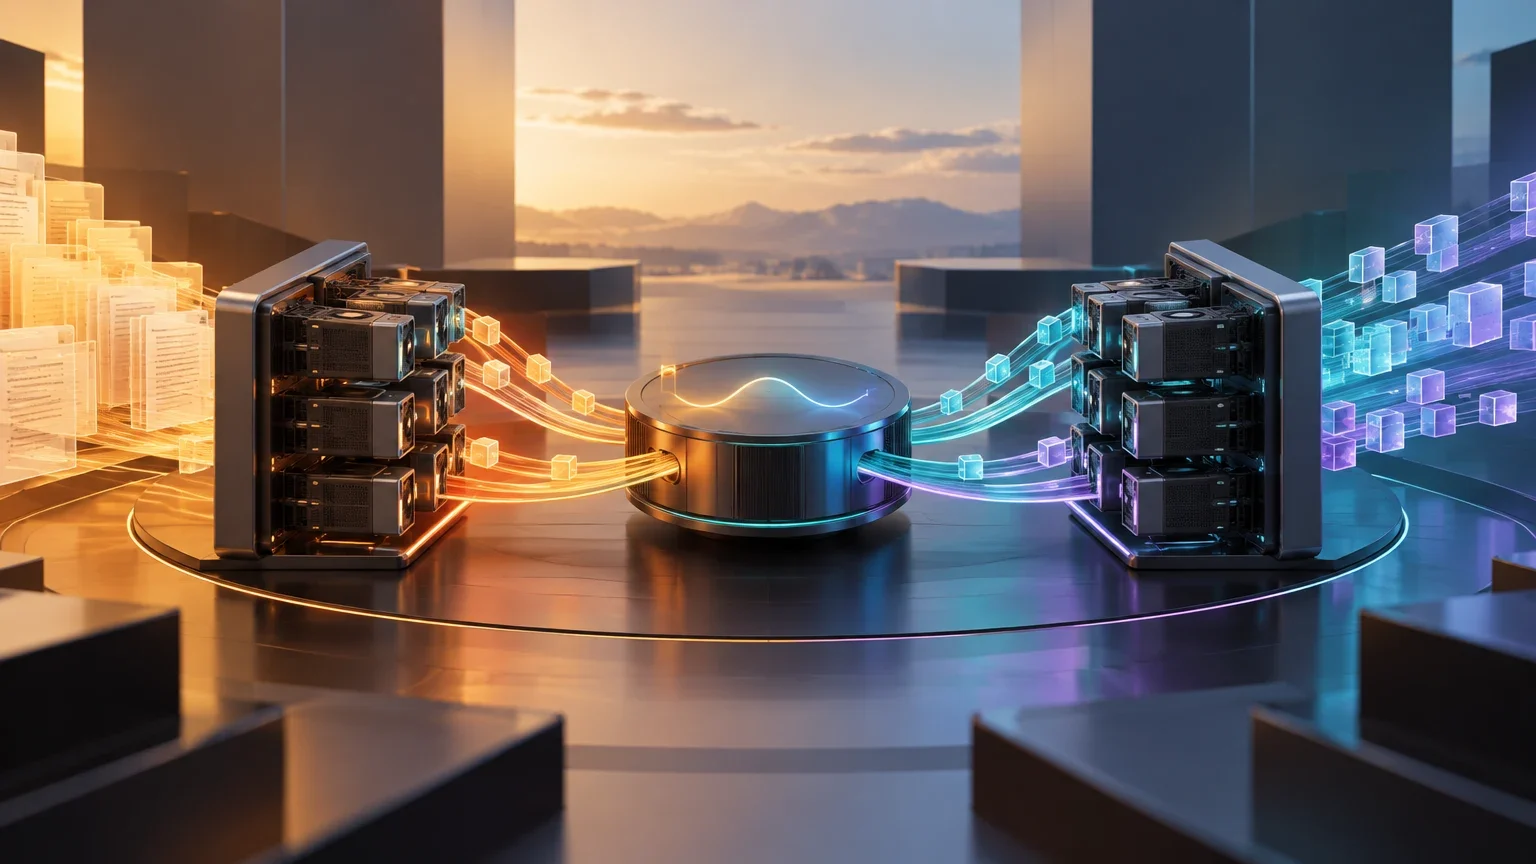
Un preprint recente propone un sistema che regola dinamicamente la distribuzione dei worker tra le fasi di prefill e decode per evitare violazioni degli SLO senza la necessità di aggiungere GPU aggiuntive.
Uno studio recente identifica un guasto specifico negli agenti di IA: la sovraraffidamento alla memoria. Gli autori propongono MEMTRIM, un framework per filtrare i ricordi parziali, sebbene la sua validazione in produzione resti da confermare.
Un preprint presenta una tecnica che recupera continuazioni dalla traiettoria attuale e le combina con bozze generate da un altro modello. L'abstract segnala miglioramenti nell'accettazione e nelle prestazioni, ma non fornisce cifre dettagliate per valutarne la portata pratica.
Un rapporto tecnico presenta un modello di serie temporali progettato per affrontare sfide specifiche della domanda, come gli zeri frequenti e le vendite censurate dalle rotture di stock. La proposta combina un corpus specializzato con un adattatore applicato a un modello generale.
Un preprint valuta se la discrepanza tra le risposte di un modello piccolo possa prevedere quando è opportuno derivare la query a uno più grande. I risultati su GSM8K mostrano un miglioramento, ma lo studio avverte su trappole metodologiche e costi operativi.