O problema da latência em agentes de voz
Os agentes de voz de meia-duplexa (full-duplex) precisam tomar inúmeras decisões pequenas e fechadas enquanto o usuário fala: determinar se a vez está completa, identificar uma interrupção (barge-in) ou selecionar um preenchimento (filler) adequado. Atualmente, esses sistemas costumam responder gerando texto de forma autorrregressiva, um processo lento que bloqueia a resposta do agente até que a decodificação seja concluída.
Em um assistente de voz para carro analisado no estudo, essas decisões consomem 30% de todos os tokens de entrada do LLM. Essa carga não apenas aumenta a latência percebida pelo usuário, mas também exige capacidade de computação adicional para manter a fluidez durante os horários de pico, elevando os custos operacionais.
Arquitetura: conexão entre codificador e LLM congelado
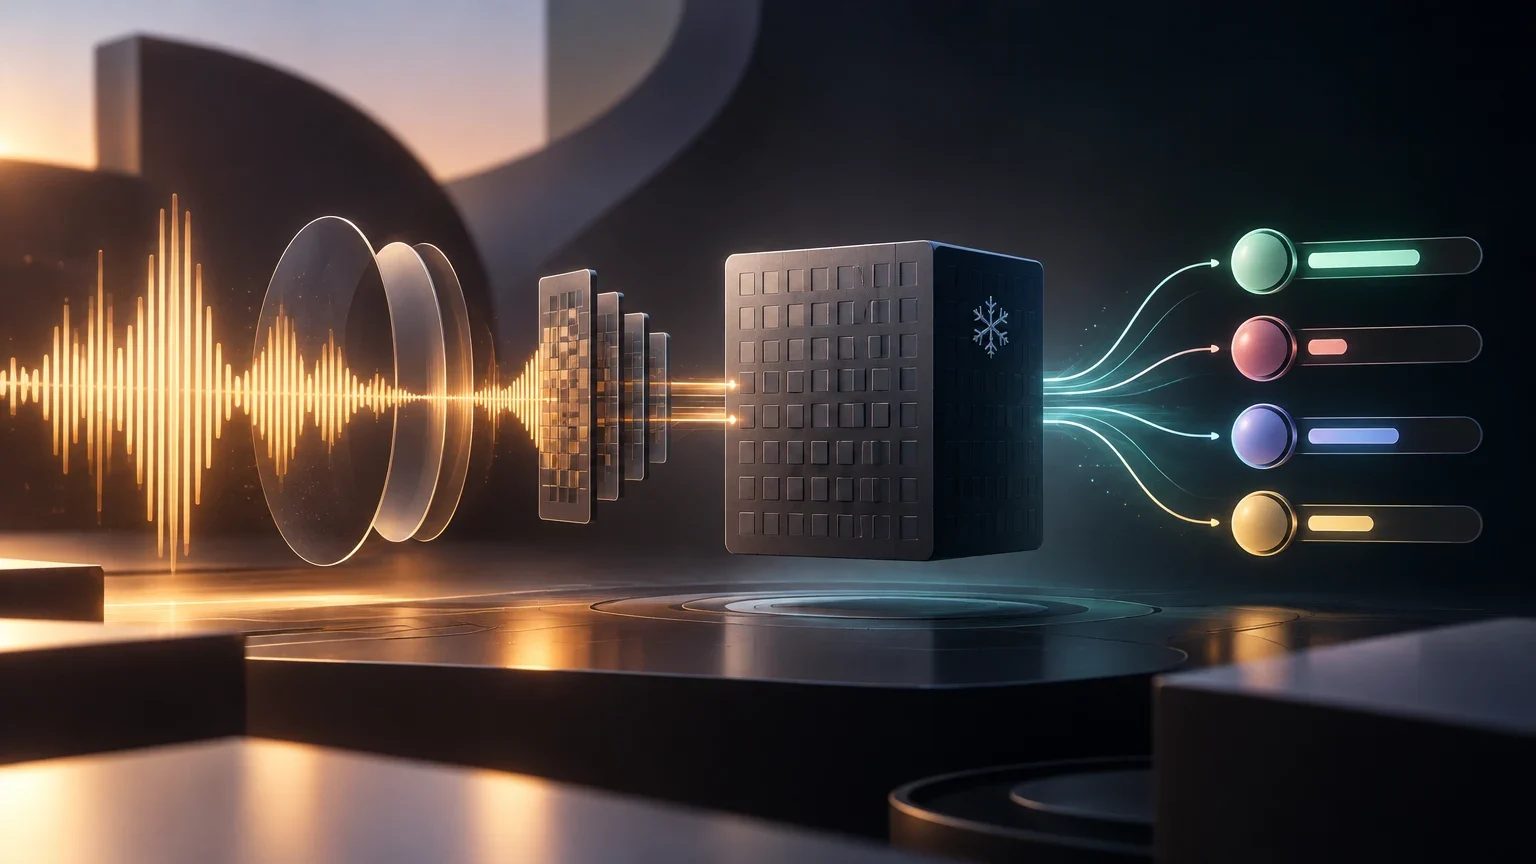
O DuplexJev propõe uma arquitetura modular onde um codificador ASR (reconhecimento automático de fala) e um LLM generalista permanecem congelados. Apenas um conector pequeno é treinado para transformar os estados ocultos do codificador em embeddings compatíveis com o espaço de embeddings do LLM.
Em vez de decodificar uma resposta textual completa, o sistema formula cada pergunta como uma distribuição de probabilidade sobre um conjunto fechado de opções (representadas por letras). O LLM realiza uma única passada de inferência (forward pass) e a resposta é extraída dos logits na posição do token de resposta, sem etapas de amostragem ou decodificação.
Componentes da arquitetura DuplexJev
Resumo dos elementos fixos e treináveis do sistema.
| Componente | Estado | Função |
|---|---|---|
| Codificador ASR | Congelado | Extrai estados ocultos do sinal de áudio |
| Conector (Fusion/Projector) | Treinável | Mapeia estados de áudio para o espaço de embeddings do LLM |
| LLM (Qwen3-32B) | Congelado | Processa o contexto e gera distribuições sobre opções |
Supervisão de um único token e compreensão paralinguística
Um achado chave do preprint é que a destilação tradicional de transcrições impede que o LLM aprenda características do falante (como gênero ou emoção), pois o 'professor' da destilação apenas vê o texto e não ouve a voz. Ao supervisionar apenas o token de resposta com entropia cruzada, o modelo aprende a extrair esses sinais paralinguísticos diretamente do áudio.
Os autores relatam que, com essa técnica, a precisão na identificação de gênero e emoção atinge 90%, partindo de um nível aleatório (55% e 28%, respectivamente) quando apenas a destilação é usada. Isso demonstra que o gargalo não está no conector, mas no objetivo de treinamento.
Resultados de latência e capacidade de computação
Em testes realizados em um nó de 8 GPUs (H200), o sistema responde 80 decisões sobre 8 enunciados em aproximadamente 0,1 segundos. Em comparação, uma abordagem em cascata que transcreve e depois gera uma resposta JSON leva 1,57 segundos por evento, o que representa uma redução de latência de 17 vezes.
A capacidade de serviço também melhora significativamente: enquanto a abordagem JSON não consegue atender a nenhuma carga dentro de um orçamento de 0,5 segundos, o método de leitura de um único token atende entre 17 e 20 eventos por segundo em uma única GPU. A principal vantagem reside na latência sob orçamentos conversacionais, e não necessariamente no throughput bruto em máxima saturação.
Comparativo de latência e capacidade (1 H200)
Tempo médio por evento e eventos por segundo dentro de um orçamento de 0,5 s.
| Método | Latência média (ms) | Eventos/s (0.5s) |
|---|---|---|
| Cascata JSON (ASR + LLM) | 1567 | 0 |
| Leitura de um único token (DuplexJev) | 92 | 20.4 |
Limitações e estado da evidência
É fundamental destacar que esses resultados provêm de um preprint (arXiv:2610.02638) e não foram revisados por pares nem replicados de forma independente. As métricas de desempenho, como a precisão de 90% em paralinguística ou a latência de 0,1 s, são afirmações dos autores baseadas em seus próprios conjuntos de dados e configurações de hardware.
Embora os autores anunciem a liberação de pesos, receitas de treinamento e um conjunto de dados bilíngue (qa100), a disponibilidade efetiva desses recursos não foi verificada de forma independente. Além disso, a avaliação se concentra em tarefas fechadas e não avalia a entrada em streaming contínuo, o que limita a generalização direta para todos os cenários de agentes de voz em produção.
Questões em aberto
- A disponibilidade efetiva do código, dos pesos e do conjunto de dados qa100 anunciados pelos autores não foi verificada.
- A latência de 0,1 s para 80 decisões depende de um nó de 8 GPUs H200; o desempenho em hardware menos potente ou em ambientes de streaming não foi avaliado.
- A precisão de 90% em gênero e emoção é medida em conjuntos específicos (AISHELL-1, ESD, CREMA-D) e pode variar em condições de ruído ou com falantes não representados no treinamento.
Continue a explorar
Fontes consultadas
Correções e transparência
Se encontrar informação incorreta ou desatualizada, envie-nos a página e a fonte que devemos rever.
Propor uma correção