El problema de la latencia en agentes de voz
Los agentes de voz de doble vía (full-duplex) deben tomar numerosas decisiones pequeñas y cerradas mientras el usuario habla: determinar si el turno está completo, identificar un bacheo (barge-in) o seleccionar un relleno (filler) adecuado. Actualmente, estos sistemas suelen responder generando texto de forma autorrregresiva, un proceso lento que bloquea la respuesta del agente hasta que se completa la decodificación.
En un asistente de voz para coche analizado en el estudio, estas decisiones consumen el 30% de todos los tokens de entrada del LLM. Esta carga no solo aumenta la latencia percibida por el usuario, sino que también exige capacidad de cómputo adicional para mantener la fluidez durante las horas pico, elevando los costes operativos.
La naturaleza autorrregresiva de la generación de texto implica que cada token nuevo depende de los anteriores, creando una secuencia de dependencias que impide la paralelización completa de la inferencia. En el contexto de un asistente de voz para coche, donde la atención del conductor está dividida, esta espera acumulada se percibe como una interrupción en el flujo de la conversación, obligando al usuario a repetir información o a esperar un silencio incómodo antes de que el sistema reaccione a sus intenciones.
Además, la necesidad de mantener la fluidez durante las horas pico exige que la infraestructura de cómputo esté dimensionada para picos de demanda que no siempre se materializan, lo que genera una ineficiencia en el uso de los recursos de hardware. Esta sobredimensión es un coste operativo recurrente que se agrava cuando las decisiones de control de turno, que son frecuentes y de baja complejidad lógica, consumen una proporción significativa de la capacidad de procesamiento disponible.
Arquitectura: conexión entre codificador y LLM congelado
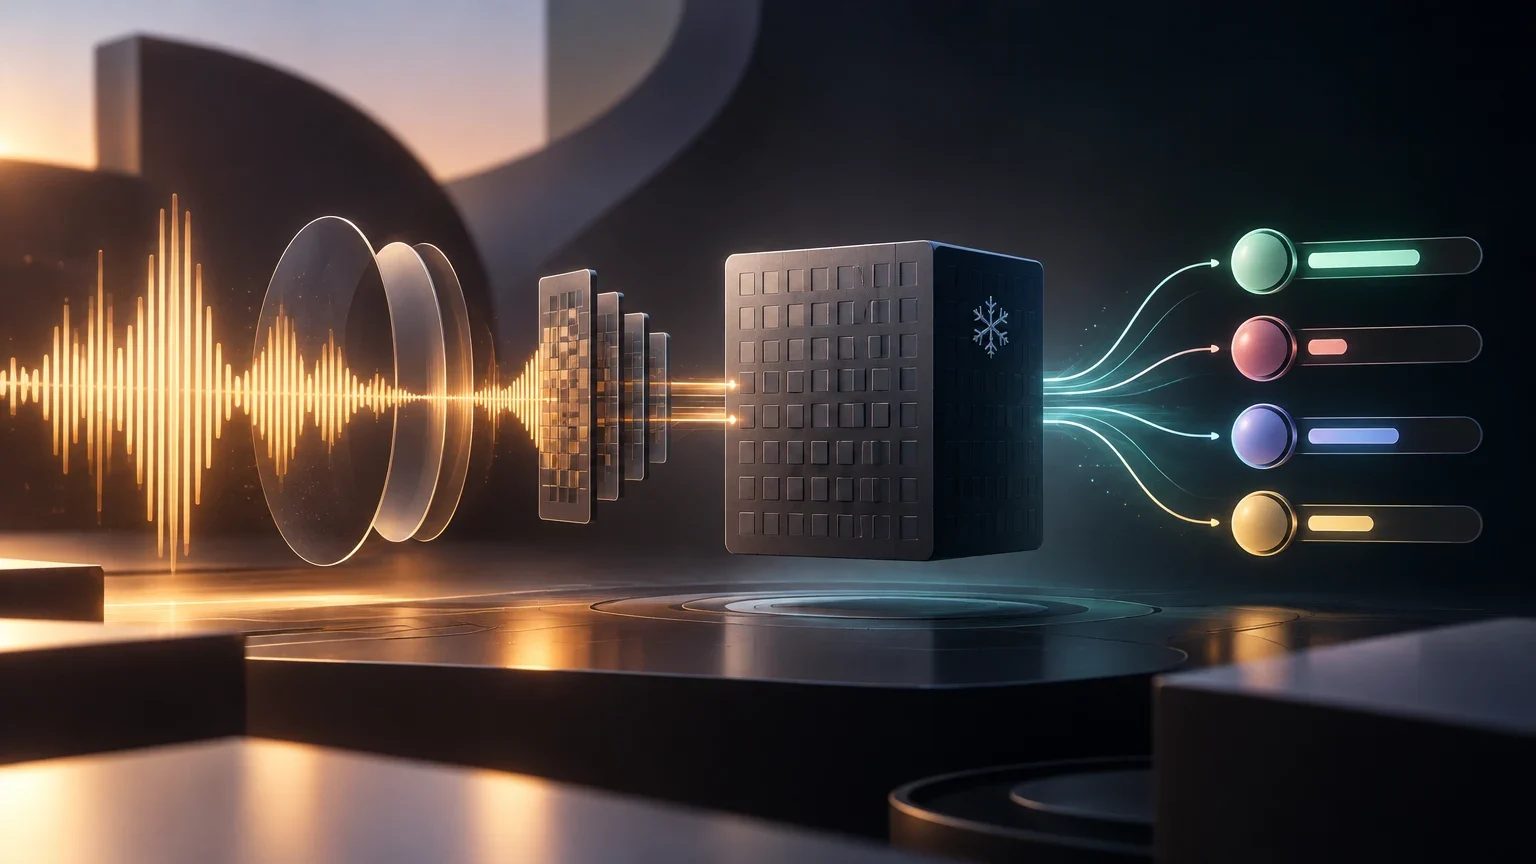
DuplexJev propone una arquitectura modular donde un codificador ASR (reconocimiento automático de voz) y un LLM generalista permanecen congelados. Solo se entrena un conector pequeño que transforma los estados ocultos del codificador en embeddings compatibles con el espacio de embeddings del LLM.
En lugar de decodificar una respuesta textual completa, el sistema formula cada pregunta como una distribución de probabilidad sobre un conjunto cerrado de opciones (representadas por letras). El LLM realiza una única pasada de inferencia (forward pass) y la respuesta se extrae de los logits en la posición del token de respuesta, sin pasos de muestreo ni decodificación.
Al mantener congelados el codificador ASR y el LLM generalista, la arquitectura reduce drásticamente la superficie de entrenamiento, lo que facilita la integración en sistemas existentes sin requerir la reentrenación de modelos de gran escala. El conector, al ser el único componente entrenable, actúa como una interfaz adaptativa que alinea las representaciones acústicas con el espacio semántico del LLM, permitiendo que el modelo de lenguaje interprete las señales de voz sin perder su capacidad general de razonamiento.
La extracción de la respuesta directamente de los logits en la posición del token de respuesta elimina la necesidad de bucles de decodificación iterativos. Este enfoque permite que la inferencia sea determinista y de tiempo constante, independientemente de la longitud de la respuesta textual que se habría generado en un sistema convencional. La ausencia de pasos de muestreo también reduce la variabilidad en las salidas, lo que es crucial para aplicaciones donde la consistencia en la toma de decisiones es prioritaria.
Componentes de la arquitectura DuplexJev
Resumen de los elementos fijos y entrenables del sistema.
| Componente | Estado | Función |
|---|---|---|
| Codificador ASR | Congelado | Extrae estados ocultos de la señal de audio |
| Conector (Fusion/Projector) | Entrenable | Mapea estados de audio al espacio de embeddings del LLM |
| LLM (Qwen3-32B) | Congelado | Procesa el contexto y genera distribuciones sobre opciones |
Supervisión de un solo token y comprensión paralingüística
Un hallazgo clave del preprint es que la destilación tradicional de transcripciones impide que el LLM aprenda características del hablante (como género o emoción), ya que el 'maestro' de la destilación solo ve el texto y no escucha la voz. Al supervisar únicamente el token de respuesta con entropía cruzada, el modelo aprende a extraer estas señales paralingüísticas directamente del audio.
Los autores reportan que, con esta técnica, la precisión en la identificación de género y emoción alcanza el 90%, partiendo de un nivel aleatorio (55% y 28% respectivamente) cuando se usa solo destilación. Esto demuestra que el cuello de botella no está en el conector, sino en el objetivo de entrenamiento.
La incapacidad de la destilación tradicional para capturar señales paralingüísticas se debe a que el proceso de transcripción elimina la información prosódica y espectral que reside en la señal de audio original. Al supervisar únicamente el token de respuesta, el modelo se ve forzado a aprender una representación interna que codifique estas características no verbales, ya que son necesarias para discriminar entre las opciones cerradas presentadas en las preguntas de control de turno.
El salto desde niveles de precisión aleatorios hasta el 90% indica que el conector, una vez entrenado con el objetivo correcto, es capaz de transferir información relevante del dominio acústico al dominio del lenguaje. Esto sugiere que las limitaciones previas no eran de capacidad de representación del conector, sino de la señal de aprendizaje proporcionada por el objetivo de entrenamiento, lo que valida la hipótesis de que la arquitectura modular es suficiente si se le proporciona la supervisión adecuada.
Resultados de latencia y capacidad de cómputo
En pruebas realizadas en un nodo de 8 GPU (H200), el sistema responde 80 decisiones sobre 8 enunciados en aproximadamente 0,1 segundos. En comparación, un enfoque en cascada que transcribe y luego genera una respuesta JSON tarda 1,57 segundos por evento, lo que representa una reducción de latencia de 17 veces.
La capacidad de servicio también mejora significativamente: mientras el enfoque JSON no puede servir ninguna carga dentro de un presupuesto de 0,5 segundos, el método de lectura de un solo token sirve entre 17 y 20 eventos por segundo en una sola GPU. La ventaja principal radica en la latencia bajo presupuestos conversacionales, no necesariamente en el throughput bruto a máxima saturación.
La reducción de latencia de 17 veces no se debe únicamente a la eliminación de la generación de texto, sino también a la simplificación de la estructura de salida. Al evitar la construcción de objetos JSON, se eliminan los costes de serialización y validación sintáctica que acompañan a los enfoques en cascada. Esto permite que el tiempo de inferencia se concentre exclusivamente en el cálculo de las distribuciones de probabilidad sobre las opciones cerradas, optimizando el uso de la memoria y la banda ancha de las GPU.
La capacidad de servir entre 17 y 20 eventos por segundo en una sola GPU, dentro de un presupuesto de 0,5 segundos, demuestra que el sistema es viable para despliegues en la nube con restricciones de latencia estrictas. La ventaja en la latencia bajo presupuestos conversacionales es particularmente relevante para agentes de voz que deben operar en tiempo real, donde la percepción de inmediatez es más importante que el rendimiento máximo en condiciones de saturación total del sistema.
Comparativa de latencia y capacidad (1 H200)
Tiempo medio por evento y eventos por segundo dentro de un presupuesto de 0,5 s.
| Método | Latencia media (ms) | Eventos/s (0.5s) |
|---|---|---|
| Cascada JSON (ASR + LLM) | 1567 | 0 |
| Lectura de un solo token (DuplexJev) | 92 | 20.4 |
Limitaciones y estado de la evidencia
Es fundamental destacar que estos resultados provienen de un preprint (arXiv:2610.02638) y no han sido revisados por pares ni replicados de forma independiente. Las cifras de rendimiento, como la precisión del 90% en paralingüística o la latencia de 0,1 s, son afirmaciones de los autores basadas en sus propios conjuntos de datos y configuraciones de hardware.
Aunque los autores anuncian la liberación de pesos, recetas de entrenamiento y un conjunto de datos bilingüe (qa100), la disponibilidad efectiva de estos recursos no ha sido verificada de forma independiente. Además, la evaluación se centra en tareas cerradas y no evalúa la entrada en streaming continuo, lo que limita la generalización directa a todos los escenarios de agentes de voz en producción.
La falta de revisión por pares y la ausencia de replicación independiente significan que los resultados presentados deben interpretarse como una demostración de concepto en condiciones controladas. La dependencia de configuraciones de hardware específicas, como el nodo de 8 GPU H200, limita la extrapolación de los datos de latencia a entornos de producción con recursos computacionales más limitados o heterogéneos, donde la eficiencia energética y la escalabilidad son factores críticos.
La evaluación centrada en tareas cerradas y la no inclusión de pruebas de entrada en streaming continuo representan una limitación significativa para la generalización del método. Los agentes de voz en producción suelen manejar flujos de audio continuos y dinámicos, donde las decisiones de turno y bacheo deben tomarse de forma incremental y en tiempo real, un escenario que no está completamente cubierto por la metodología de evaluación descrita en el preprint.
Qué sigue abierto
- No se ha verificado la disponibilidad efectiva del código, los pesos y el conjunto de datos qa100 anunciados por los autores.
- La latencia de 0,1 s para 80 decisiones depende de un nodo de 8 GPU H200; el rendimiento en hardware menos potente o en entornos de streaming no está evaluado.
- La precisión del 90% en género y emoción se mide en conjuntos específicos (AISHELL-1, ESD, CREMA-D) y puede variar en condiciones de ruido o con hablantes no representados en el entrenamiento.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección