Le problème de la latence dans les agents vocaux
Les agents vocaux full-duplex doivent prendre de nombreuses petites décisions fermées pendant que l'utilisateur parle : déterminer si le tour est terminé, identifier une interruption (barge-in) ou sélectionner un remplissage (filler) approprié. Actuellement, ces systèmes répondent généralement en générant du texte de manière autorégressive, un processus lent qui bloque la réponse de l'agent jusqu'à la fin du décodage.
Dans un assistant vocal pour voiture analysé dans l'étude, ces décisions consomment 30 % de tous les jetons d'entrée du LLM. Cette charge non seulement augmente la latence perçue par l'utilisateur, mais exige également une capacité de calcul supplémentaire pour maintenir la fluidité pendant les heures de pointe, augmentant ainsi les coûts opérationnels.
Architecture : connexion entre encodeur et LLM figé
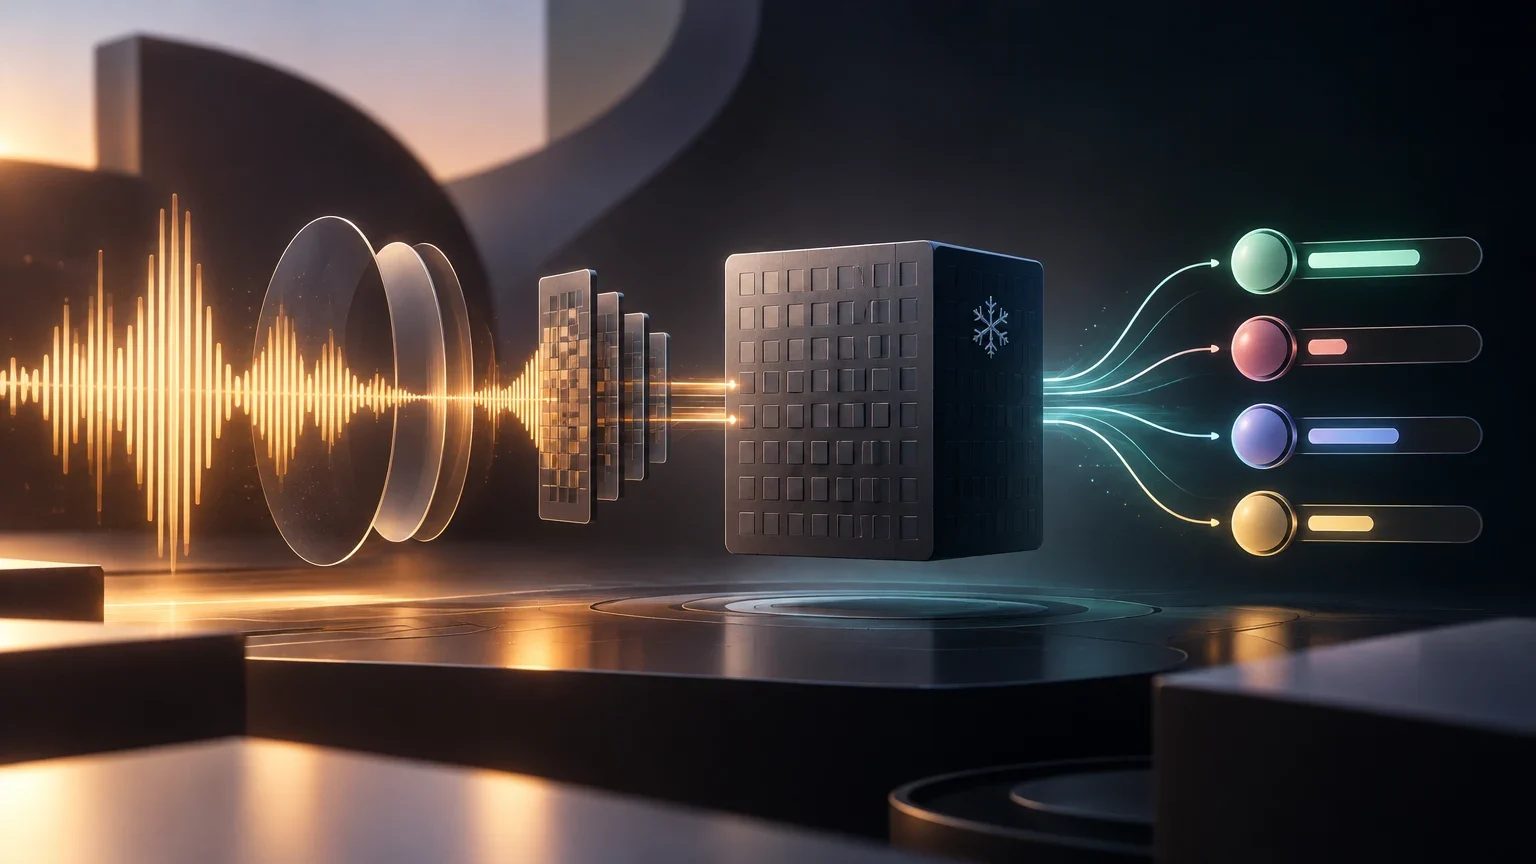
DuplexJev propose une architecture modulaire où un encodeur ASR (reconnaissance automatique de la parole) et un LLM généraliste restent figés. Seul un petit connecteur est entraîné pour transformer les états cachés de l'encodeur en embeddings compatibles avec l'espace d'embeddings du LLM.
Au lieu de décoder une réponse textuelle complète, le système formule chaque question comme une distribution de probabilité sur un ensemble fermé d'options (représentées par des lettres). Le LLM effectue une seule passe d'inférence (forward pass) et la réponse est extraite des logits à la position du jeton de réponse, sans étapes d'échantillonnage ni de décodage.
Composants de l'architecture DuplexJev
Résumé des éléments fixes et entraînables du système.
| Composant | État | Fonction |
|---|---|---|
| Encodeur ASR | Figé | Extrait les états cachés du signal audio |
| Connecteur (Fusion/Projector) | Entraînable | Mappe les états audio vers l'espace d'embeddings du LLM |
| LLM (Qwen3-32B) | Figé | Traite le contexte et génère des distributions sur les options |
Supervision à jeton unique et compréhension paralinguistique
Une découverte clé du préprint est que la distillation traditionnelle des transcriptions empêche le LLM d'apprendre les caractéristiques du locuteur (comme le genre ou l'émotion), car le « maître » de la distillation ne voit que le texte et n'entend pas la voix. En supervisant uniquement le jeton de réponse avec l'entropie croisée, le modèle apprend à extraire ces signaux paralinguistiques directement de l'audio.
Les auteurs rapportent qu'avec cette technique, la précision dans l'identification du genre et de l'émotion atteint 90 %, partant d'un niveau aléatoire (55 % et 28 % respectivement) lorsque seule la distillation est utilisée. Cela démontre que le goulot d'étranglement ne réside pas dans le connecteur, mais dans l'objectif d'entraînement.
Résultats de latence et capacité de calcul
Dans des tests réalisés sur un nœud de 8 GPU (H200), le système répond à 80 décisions sur 8 énoncés en environ 0,1 seconde. En comparaison, une approche en cascade qui transcrit puis génère une réponse JSON prend 1,57 seconde par événement, représentant une réduction de latence de 17 fois.
La capacité de service s'améliore également de manière significative : tandis que l'approche JSON ne peut servir aucune charge dans un budget de 0,5 seconde, la méthode de lecture à jeton unique sert entre 17 et 20 événements par seconde sur un seul GPU. L'avantage principal réside dans la latence sous des budgets conversationnels, et non nécessairement dans le débit brut à saturation maximale.
Comparaison de latence et capacité (1 H200)
Temps moyen par événement et événements par seconde dans un budget de 0,5 s.
| Méthode | Latence moyenne (ms) | Événements/s (0.5s) |
|---|---|---|
| Cascade JSON (ASR + LLM) | 1567 | 0 |
| Lecture à jeton unique (DuplexJev) | 92 | 20.4 |
Limites et état des preuves
Il est fondamental de souligner que ces résultats proviennent d'un préprint (arXiv:2610.02638) et n'ont pas fait l'objet d'une révision par les pairs ni d'une réplication indépendante. Les chiffres de performance, comme la précision de 90 % en paralinguistique ou la latence de 0,1 s, sont des affirmations des auteurs basées sur leurs propres jeux de données et configurations matérielles.
Bien que les auteurs annoncent la libération de poids, de recettes d'entraînement et d'un jeu de données bilingue (qa100), la disponibilité effective de ces ressources n'a pas été vérifiée de manière indépendante. De plus, l'évaluation se concentre sur des tâches fermées et n'évalue pas l'entrée en streaming continu, ce qui limite la généralisation directe à tous les scénarios d'agents vocaux en production.
Questions ouvertes
- La disponibilité effective du code, des poids et du jeu de données qa100 annoncés par les auteurs n'a pas été vérifiée.
- La latence de 0,1 s pour 80 décisions dépend d'un nœud de 8 GPU H200 ; les performances sur du matériel moins puissant ou dans des environnements de streaming ne sont pas évaluées.
- La précision de 90 % pour le genre et l'émotion est mesurée sur des jeux de données spécifiques (AISHELL-1, ESD, CREMA-D) et peut varier en conditions de bruit ou avec des locuteurs non représentés dans l'entraînement.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction