Vários veículos atribuem a testes internos problemas de segurança no GPT‑6.1 Astra. No entanto, as informações disponíveis não incluem resultados públicos nem uma confirmação direta da OpenAI, e as páginas oficiais citadas tratam do GPT‑6 Astra.
Encontrar sobreposições entre dados de treinamento e de teste não equivale a provar que elas elevaram uma pontuação. Um guia para distinguir tipos de contaminação, métodos de detecção e limites das evidências.
O tamanho do arquivo não basta para saber se um modelo local vai funcionar em uma GPU. Aprenda a separar pesos, cache KV, buffers e margem, e a verificar a configuração prevista no runtime e no hardware específicos.
A Microsoft reúne investigação, desenvolvimento de modelos, produtos Copilot e distribuição no Foundry numa oferta de IA, mas as fontes públicas não permitem atribuir todas as responsabilidades internas. Este guia distingue o que foi anunciado do que está documentado e explica o que deve ser verificado em cada modelo e canal.
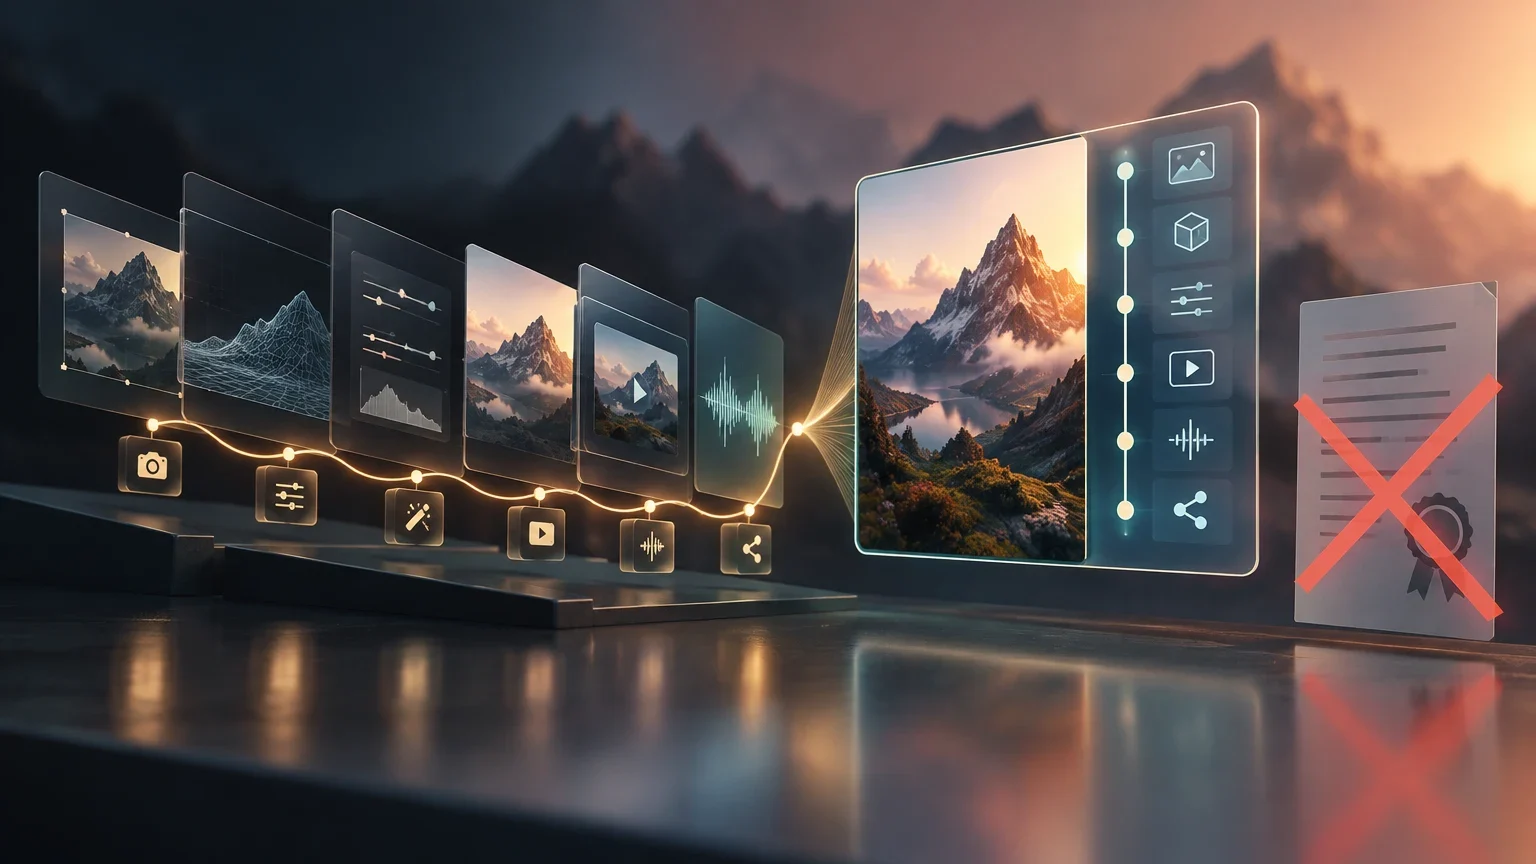
Um fluxo de trabalho para registrar como uma imagem, um vídeo ou um áudio é criado, modificado e publicado — e interpretar com cautela as credenciais de procedência.
Uma comparação entre três modelos em tarefas baseadas nos conjuntos Adult, COMPAS e Credit indica que o raciocínio corrigiu algumas mudanças contrafactuais, mas criou outras com maior frequência. O resultado não demonstra que todos os modelos ou usos produzam o mesmo efeito.
O pré-print apresenta um método de busca evolutiva que modifica casos de avaliação existentes. Em três benchmarks e três escalas do Qwen3.5, os autores relatam uma redução média de 22,7% na precisão, embora o resumo não permita auditar o cálculo nem determinar até que ponto os casos gerados representam situações reais.
Uma pontuação de WER, por si só, não descreve o desempenho geral de um sistema de transcrição. Analisamos o que é possível verificar sobre o Scribe v2, como o corpus, a normalização e a configuração afetam os resultados e quais informações são necessárias para repetir uma comparação.
Um guia operacional para determinar se uma entidade deve realizar a avaliação prevista no artigo 27.º do AI Act e transformar riscos, medidas e responsabilidades em decisões anteriores à implantação.
Não há resultados de uma comparação executada que permitam declarar um vencedor. Há, sim, um protocolo reproduzível para medir a qualidade dos patches, regressões, custo e tempo em condições comuns, e para determinar que evidências uma equipe precisa obter antes de escolher.
Um protocolo para verificar, com vozes e guiões controlados, se uma indicação de interpretação altera a entrega sem prejudicar a fidelidade ao texto, a identidade vocal ou a repetibilidade. A documentação disponível não permite confirmar aqui quais são as etiquetas específicas do Eleven v3: o primeiro passo é verificar o que é aceite no acesso que será testado.
Um modelo para estimar o gasto de um fluxo com ferramentas por rodada, separar tokens de entrada e saída de cobranças adicionais e comparar o cálculo com os registros de uso.