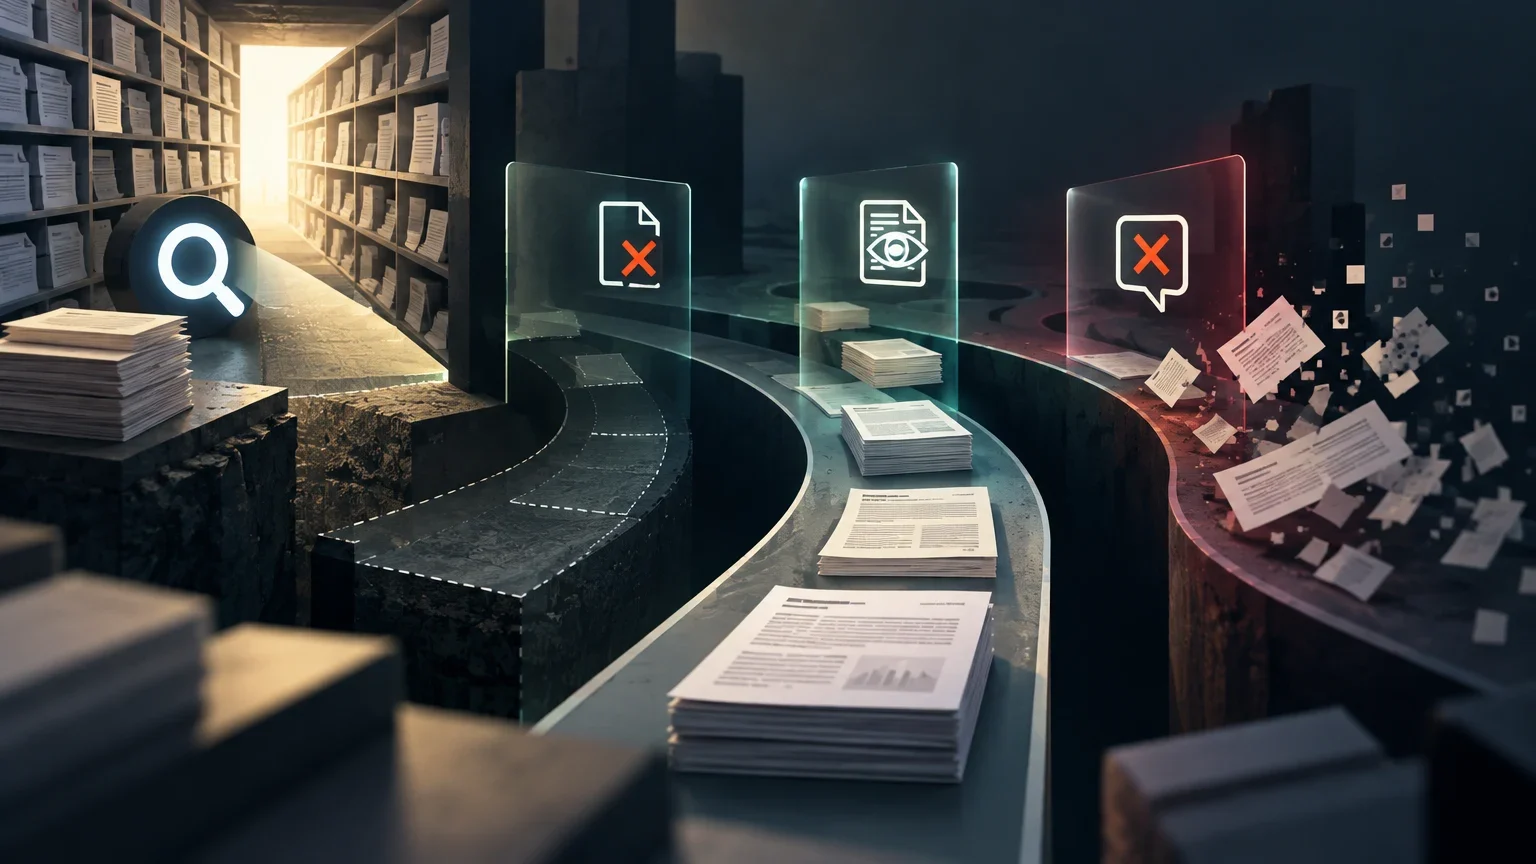
La limite d'évaluer uniquement la réponse finale
L'évaluation traditionnelle des agents de recherche scientifique se concentre sur la précision de la réponse finale. Cependant, cette métrique agrège des échecs hétérogènes : un agent peut échouer parce qu'il ne trouve pas le document cible, parce qu'il le trouve mais ne l'inspecte pas, ou parce qu'il l'inspecte mais génère une réponse incorrecte.
Cette opacité complique l'amélioration des systèmes, car elle ne permet pas d'identifier l'étape spécifique où l'erreur se produit. Un préprint récent aborde cette limite en proposant une méthode d'audit qui enregistre les événements intermédiaires pendant l'inférence, permettant une catégorisation plus granulaire des échecs.
Cette granularité est essentielle car elle transforme une métrique binaire en un diagnostic actionnable. En identifiant précisément si l'agent a échoué à la phase de récupération, d'inspection ou de synthèse, les ingénieurs peuvent cibler les ressources de développement sur le maillon faible spécifique du pipeline, plutôt que de procéder à des ajustements globaux et inefficaces.
L'opacité de l'évaluation traditionnelle masque les corrélations entre les actions intermédiaires et le résultat final. Le préprint souligne que sans cette décomposition, il est impossible de savoir si une amélioration de la précision finale provient d'une meilleure capacité à trouver les documents ou d'une meilleure capacité à les interpréter une fois trouvés, ce qui complique l'optimisation des systèmes d'agents de recherche scientifique.
Points de contrôle décisionnels pendant la recherche
L'étude introduit des « points de contrôle décisionnels » qui enregistrent les observations et les actions des outils pendant l'inférence, sans utiliser d'étiquettes de référence en temps réel. Ces enregistrements capturent si l'agent a exposé le document cible et s'il a tenté de l'inspecter.
Ensuite, les identités des cibles et les étiquettes de l'évaluateur sont jointes aux événements enregistrés pour assigner des catégories de résultat. Ce protocole rend explicites les différences au niveau de la question, séparant l'exposition et l'inspection de la cible de la précision agrégée et de l'utilisation totale des outils.
L'absence d'étiquettes de référence en temps réel lors de l'enregistrement est une caractéristique méthodologique clé qui garantit l'objectivité des données brutes. Les points de contrôle capturent uniquement les faits observables : les requêtes envoyées, les documents retournés et les actions d'inspection tentées, sans biais induit par la connaissance préalable de la réponse correcte.
La jointure a posteriori des identités des cibles permet de rétroagir sur ces événements pour les classer. Cette séparation stricte entre la phase d'observation et la phase d'évaluation assure que les catégories de résultat reflètent fidèlement le comportement de l'agent, offrant une vue détaillée des différences au niveau de chaque question individuelle.
Flux d'audit proposé
Le processus enregistre les événements en temps réel et les classe a posteriori.
- 01Enregistrement des observations et des actions des outils pendant l'inférence.
- 02Jointure des identités des cibles et des étiquettes de l'évaluateur.
- 03Assignation des catégories de résultat basées sur les événements enregistrés.
Conditions expérimentales et chiffres comparatifs
L'expérience a été réalisée dans un environnement fixe enrichi de documents cibles, en utilisant 540 questions répondables de AutoResearchBench Deep. Cinq conditions de recherche différentes ont été évaluées.
Dans ce contexte, la recherche par mots-clés a atteint une précision de 24,6 %, tandis que la recherche brute a obtenu 17,8 %. La condition de lecture préalable a enregistré 27,4 % d'appels de recherche de preuve de plus par rapport à la recherche par mots-clés.
L'utilisation d'un environnement fixe enrichi de documents cibles permet de contrôler les variables externes et d'isoler l'impact des différentes stratégies de recherche. Les 540 questions de AutoResearchBench Deep servent de base standardisée, garantissant que les comparaisons entre les cinq conditions sont effectuées sur un jeu de données identique et répondable.
Les chiffres comparatifs mettent en évidence des écarts significatifs dans l'efficacité des approches. La recherche par mots-clés surpasse la recherche brute en précision, tandis que la condition de lecture préalable, bien qu'obtenant une précision similaire à la recherche par mots-clés, génère une activité d'outils nettement supérieure, indiquant un coût computationnel ou temporel plus élevé pour un gain de précision marginal.
Résultats clés de l'expérience
Comparaison de la précision et de l'activité des outils dans des conditions sélectionnées.
| Condition | Précision | Notes supplémentaires |
|---|---|---|
| Recherche par mots-clés | 24,6 % | Moins de réponses incorrectes sans exposition ni inspection. |
| Recherche brute | 17,8 % | Précision inférieure dans l'environnement fixe. |
| Lecture préalable | 24,6 % | 27,4 % d'appels de recherche de preuve en plus. |
Séparation des échecs de récupération, d'inspection et de réponse
Les données révèlent que la recherche par mots-clés a moins de réponses incorrectes où il n'y a eu ni exposition ni inspection de la cible, mais plus de réponses incorrectes après que la cible a été exposée et laissée sans inspection.
Les tentatives d'inspection de la cible ont eu lieu sur 199 questions sous la condition de lecture préalable et sur 191 sous la recherche par mots-clés. Les deux conditions ont atteint la même précision de 24,6 %, ce qui suggère que la simple inspection ne garantit pas la correction de la réponse finale.
La distinction entre les échecs de récupération et les échecs d'inspection est cruciale pour comprendre les limites actuelles des agents. Les données montrent que la recherche par mots-clés réduit les cas où la cible n'est jamais vue, mais augmente les cas où la cible est vue mais ignorée, révélant un déséquilibre dans la capacité de l'agent à traiter l'information disponible.
Le fait que la condition de lecture préalable et la recherche par mots-clés atteignent la même précision malgré des volumes d'inspection différents suggère que la simple exposition au document correct n'est pas un facteur suffisant pour garantir une réponse juste. Cela pointe vers des difficultés potentielles dans la synthèse ou l'interprétation des contenus inspectés, indépendamment de la quantité de documents consultés.
Limites de la généralisation des résultats
Il est crucial de noter que ces résultats proviennent d'un environnement expérimental fixe et enrichi de documents cibles. Cette configuration introduit des biais qui peuvent ne pas refléter la complexité de la recherche scientifique dans des environnements ouverts et dynamiques.
De plus, le travail est un préprint soumis en septembre 2026, il n'a donc pas passé par une révision par les pairs. Les chiffres et les conclusions doivent être interprétés comme valables pour cette configuration spécifique et non comme une preuve de fiabilité générale des agents IA dans tous les contextes de recherche scientifique.
La nature expérimentale de l'environnement, bien que contrôlée, limite la portée des conclusions. Les biais introduits par l'enrichissement des documents cibles peuvent ne pas capturer la dynamique complexe et imprévisible des bases de données scientifiques réelles, où la disponibilité et la qualité des documents varient considérablement.
Le statut de préprint du travail, soumis en septembre 2026, impose une prudence supplémentaire dans l'interprétation des résultats. Sans validation par les pairs, les chiffres et les catégories d'échec proposés restent des observations préliminaires qui nécessitent une confirmation indépendante avant d'être considérés comme des standards fiables pour l'évaluation des agents IA dans des contextes de recherche scientifique variés.
Questions ouvertes
- Les modèles d'IA exacts utilisés dans les cinq conditions ne sont pas spécifiés.
- La manière exacte dont l'environnement enrichi a été construit et les biais spécifiques qu'il introduit ne sont pas détaillés.
- Aucune donnée ou trace publique disponible pour reproduire les catégories d'échec n'est mentionnée.
- L'étude est un préprint, ses conclusions n'ont donc pas été validées par une révision par les pairs.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction