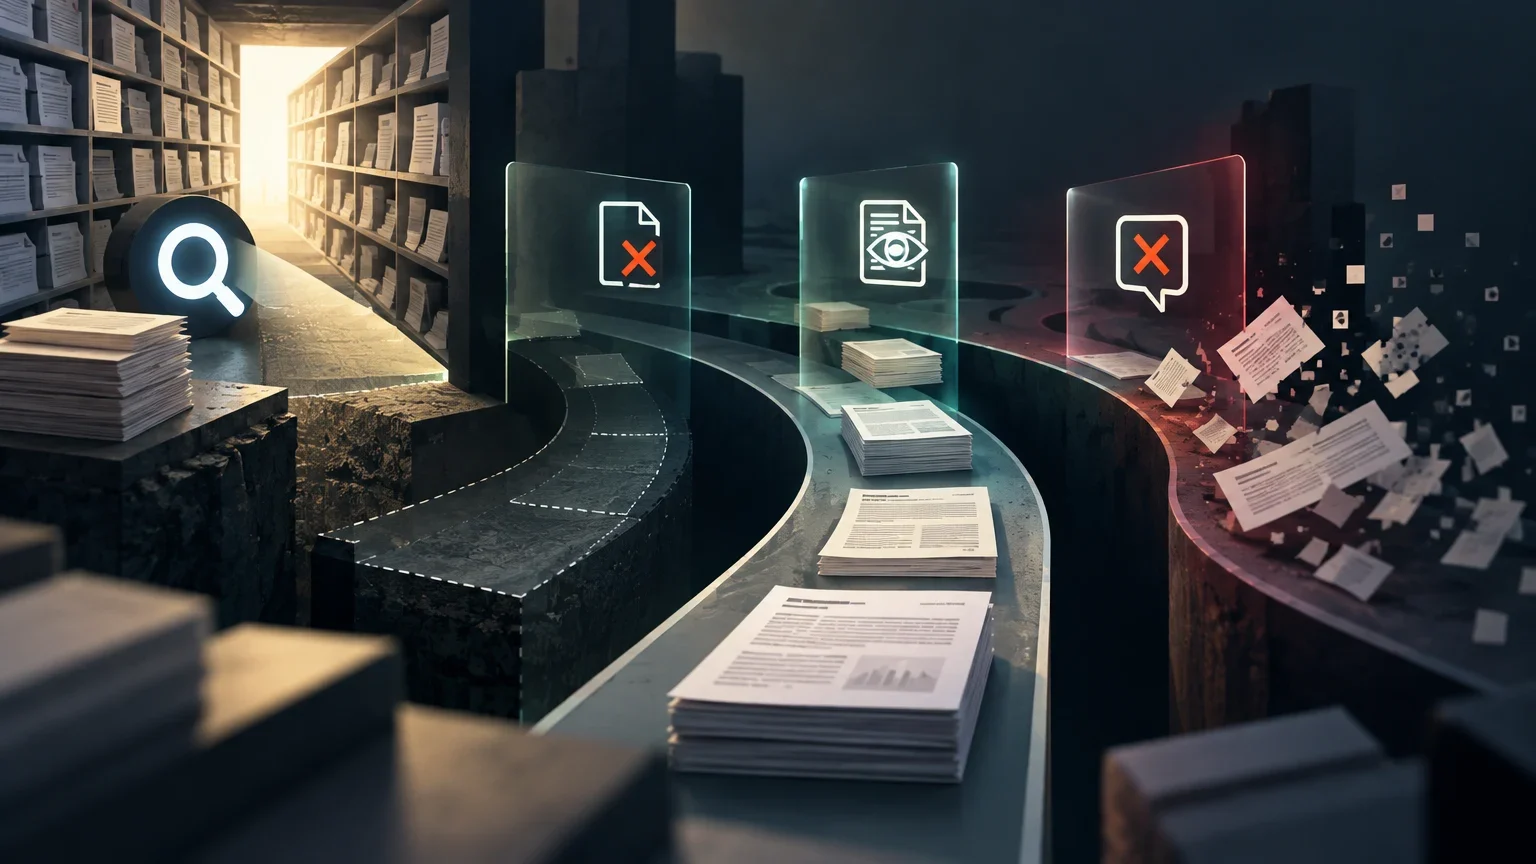
A limitação de avaliar apenas a resposta final
A avaliação tradicional de agentes de busca científica concentra-se na precisão da resposta final. No entanto, essa métrica agrupa falhas heterogêneas: um agente pode falhar porque não encontra o documento alvo, porque o encontra mas não o inspeciona, ou porque o inspeciona mas gera uma resposta incorreta.
Essa opacidade dificulta a melhoria dos sistemas, pois não permite identificar a etapa específica onde ocorre o erro. Um preprint recente aborda essa limitação propondo um método de auditoria que registra eventos intermediários durante a inferência, permitindo uma categorização mais granular das falhas.
A precisão final continua sendo uma medida importante, mas não descreve por si só o percurso que levou a uma resposta correta ou incorreta. Quando diferentes tipos de falha aparecem reunidos no mesmo resultado, torna-se difícil saber se a prioridade deve ser melhorar a localização de documentos, a decisão de examiná-los ou a elaboração da resposta. A auditoria proposta acrescenta essa distinção ao observar etapas intermediárias, sem substituir a avaliação da resposta final.
Essa separação também torna mais informativa a leitura dos erros: duas respostas incorretas podem exigir investigações técnicas diferentes, mesmo que recebam a mesma avaliação final. Uma pode estar associada à ausência de exposição ao documento, enquanto outra pode ocorrer depois que o agente teve contato com ele. O método procura preservar essas diferenças para que o resultado agregado não esconda em que ponto do processo surgiram.
Pontos de controle de decisão durante a busca
O estudo introduz 'decision checkpoints' (pontos de controle de decisão) que registram observações e ações de ferramentas durante a inferência, sem utilizar rótulos da benchmark em tempo real. Esses registros capturam se o agente expôs o documento alvo e se tentou inspecioná-lo.
Posteriormente, as identidades dos alvos e os rótulos do avaliador são unidos aos eventos registrados para atribuir categorias de resultado. Esse protocolo torna explícitas as diferenças ao nível da pergunta, separando a exposição e inspeção do alvo da precisão agregada e do uso total de ferramentas.
Os pontos de controle organizam evidências sobre o comportamento do agente sem recorrer às etiquetas da benchmark durante a inferência. Assim, os registros descrevem observações e ações de ferramentas no momento em que ocorrem; só depois são relacionados às identidades dos documentos-alvo e às classificações do avaliador. Essa ordem distingue a coleta do rastro da interpretação posterior, em vez de orientar a atividade do agente com o resultado esperado.
A unidade de análise também importa: as categorias são atribuídas para cada pergunta, e não apenas resumidas como uma pontuação global. Isso permite observar separadamente se o alvo foi exposto e se houve uma tentativa de inspeção, mantendo essas informações distintas da precisão e do volume total de uso das ferramentas. O protocolo, portanto, oferece uma descrição mais detalhada do processo observado, mas não transforma esses registros, por si sós, em explicação causal para cada resposta.
A classificação posterior depende da combinação entre os eventos capturados e as informações do avaliador. Se uma etapa não estiver representada nos registros, a categoria correspondente não deve ser presumida apenas a partir da resposta final. Essa distinção é relevante para interpretar o alcance da auditoria: ela explicita o que foi observado no percurso e relaciona essas observações ao desfecho, sem afirmar mais do que os eventos permitem concluir.
Fluxo de auditoria proposto
O processo registra eventos em tempo real e os classifica a posteriori.
- 01Registro de observações e ações de ferramentas durante a inferência.
- 02União de identidades de alvos e rótulos do avaliador.
- 03Atribuição de categorias de resultado com base em eventos registrados.
Condições experimentais e números comparativos
O experimento foi realizado em um ambiente fixo enriquecido com documentos alvo, utilizando 540 perguntas respondíveis do AutoResearchBench Deep. Foram avaliadas cinco condições diferentes de busca.
Nesse contexto, a busca por palavras-chave alcançou uma precisão de 24,6 %, enquanto a busca bruta obteve 17,8 %. A condição de leitura prévia registrou 27,4 % mais chamadas de busca de evidência em comparação com a busca por palavras-chave.
As cifras devem ser lidas como resultados das condições comparadas dentro do mesmo ambiente experimental, não como estimativas gerais de desempenho. A busca por palavras-chave superou a busca crua em precisão nessa configuração: 24,6 % contra 17,8 %. Essa diferença descreve os resultados observados nas 540 perguntas respondíveis do AutoResearchBench Deep; por si só, não identifica qual etapa explica a diferença entre as condições.
A condição de leitura prévia teve a mesma precisão de 24,6 % informada para a busca por palavras-chave, mas registrou 27,4 % mais chamadas de busca de evidência. Esse dado acrescenta uma medida de atividade das ferramentas à comparação, sem demonstrar que mais chamadas causaram a precisão observada ou que representem, isoladamente, maior eficiência. A leitura conjunta das métricas deve manter separados o resultado final e o uso de ferramentas.
As cinco condições foram avaliadas no ambiente fixo enriquecido com documentos-alvo, embora os números apresentados aqui detalhem apenas algumas comparações. Por isso, não se deve completar as lacunas da tabela com taxas de falha por etapa que não foram fornecidas. Em particular, a precisão inferior da busca crua não permite concluir, sem dados específicos, que ela tenha falhado mais na recuperação ou deixado de expor o documento em mais perguntas.
Resultados-chave do experimento
Comparação de precisão e atividade de ferramentas em condições selecionadas.
| Condição | Precisão | Notas adicionais |
|---|---|---|
| Busca por palavras-chave | 24,6 % | Menos respostas incorretas sem exposição nem inspeção. |
| Busca bruta | 17,8 % | Precisão inferior no ambiente fixo. |
| Leitura prévia | 24,6 % | 27,4 % mais chamadas de busca de evidência. |
Separação de falhas de recuperação, inspeção e resposta
Os dados revelam que a busca por palavras-chave tem menos respostas incorretas onde não houve exposição nem inspeção do alvo, mas mais respostas incorretas depois que o alvo foi exposto e deixado sem inspeção.
As tentativas de inspeção do alvo ocorreram em 199 perguntas sob a condição de leitura prévia e em 191 sob a busca por palavras-chave. Ambas as condições alcançaram a mesma precisão de 24,6 %, o que sugere que a mera inspeção não garante a correção da resposta final.
A comparação entre as categorias ajuda a qualificar o significado da precisão igual observada para leitura prévia e busca por palavras-chave. Houve tentativas de inspeção do alvo em 199 perguntas na condição de leitura prévia e em 191 na busca por palavras-chave, mas esses totais, junto com a precisão de 24,6 % em ambas, não mostram que inspecionar o documento seja suficiente para produzir uma resposta correta. A inspeção é uma etapa observável, não uma garantia do resultado final.
O padrão descrito para a busca por palavras-chave também deve ser mantido nos limites apresentados: ela teve menos respostas incorretas nas perguntas sem exposição nem inspeção do alvo, mas mais respostas incorretas depois que o alvo foi exposto e não inspecionado. Essa comparação caracteriza os grupos mencionados, mas não fornece, por si só, uma explicação para cada erro nem uma taxa comparativa de não exposição para a busca crua. Separar o que os dados descrevem do que não especificam evita atribuir causas não demonstradas.
No exemplo de exposição sem inspeção, o agente chega a expor o artigo, mas não há registro de que o tenha examinado. Essa categoria difere de uma falha total de recuperação porque a exposição foi observada; ainda assim, a classificação não informa automaticamente por que a inspeção não ocorreu nem se o conteúdo teria levado a uma resposta correta. A utilidade do rótulo está em identificar uma etapa distinta para análise, sem preencher essas questões com suposições.
Limites da generalização dos resultados
É crucial apontar que esses resultados provêm de um ambiente experimental fixo e enriquecido com documentos alvo. Essa configuração introduz vieses que podem não refletir a complexidade da busca científica em ambientes abertos e dinâmicos.
Além disso, o trabalho é um preprint apresentado em setembro de 2026, portanto não passou por revisão por pares. Os números e conclusões devem ser interpretados como válidos para essa configuração específica e não como uma prova de confiabilidade geral dos agentes de IA em todos os contextos de busca científica.
O ambiente fixo enriquecido com documentos-alvo delimita o que os resultados podem sustentar. As condições foram comparadas dentro dessa configuração, e não em uma representação completa de ambientes abertos e dinâmicos de busca científica. A possibilidade de que a configuração introduza vieses deve ser tratada como uma limitação de generalização; os detalhes disponíveis não especificam a construção do ambiente nem permitem enumerar vieses concretos.
Também não são especificados os modelos de IA exatos usados nas cinco condições, nem são descritos rastros ou dados públicos que permitam reproduzir a categorização das falhas. Essas lacunas limitam o quanto se pode avaliar ou reconstruir o procedimento a partir das informações apresentadas. Elas não anulam os números reportados para o experimento, mas recomendam cautela ao estender sua interpretação para além dele.
Como o trabalho é um preprint apresentado em setembro de 2026 e ainda não passou por revisão por pares, suas conclusões permanecem provisórias. A precisão, os totais de tentativas de inspeção e a atividade de ferramentas devem ser entendidos no escopo da configuração descrita, e não como comprovação de confiabilidade geral dos agentes em todos os contextos de busca científica. A revisão por pares poderá avaliar o trabalho, mas até lá não se deve tratar essa validação como já ocorrida.
Questões em aberto
- Não são especificados os modelos de IA exatos utilizados nas cinco condições.
- Não é detalhado como o ambiente enriquecido foi construído exatamente nem quais vieses específicos ele introduz.
- Não são mencionados dados ou rastros públicos disponíveis para reproduzir as categorias de falha.
- O estudo é um preprint, portanto suas conclusões não foram validadas por revisão por pares.
Continue a explorar
Fontes consultadas
Correções e transparência
Se encontrar informação incorreta ou desatualizada, envie-nos a página e a fonte que devemos rever.
Propor uma correção