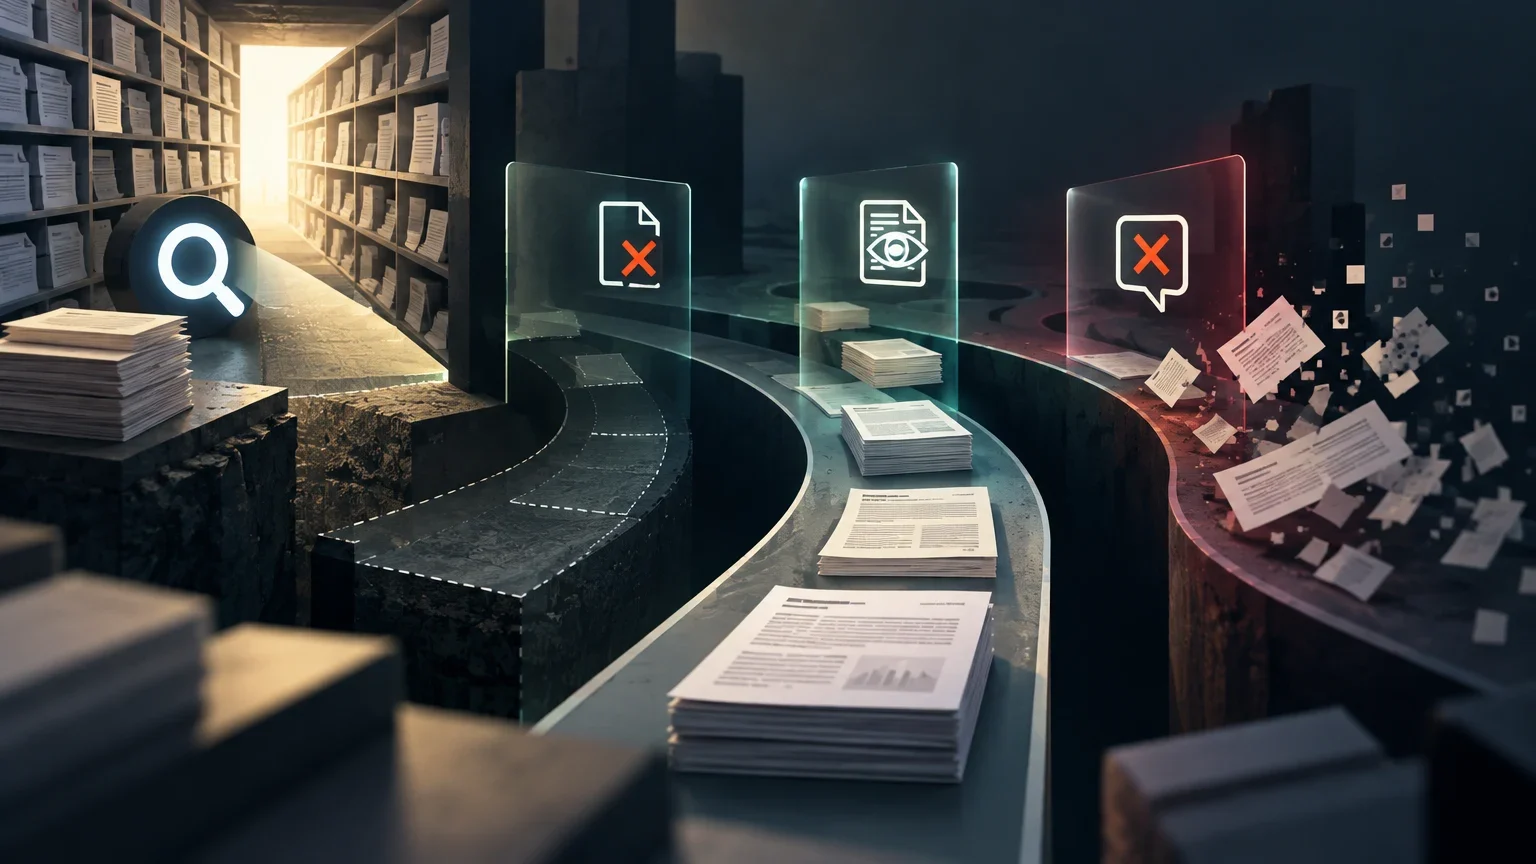
Il limite di valutare solo la risposta finale
La valutazione tradizionale degli agenti di ricerca scientifica si concentra sull'accuratezza della risposta finale. Tuttavia, questa metrica aggrega fallimenti eterogenei: un agente può fallire perché non trova il documento obiettivo, perché lo trova ma non lo ispeziona, o perché lo ispeziona ma genera una risposta errata.
Questa opacità rende difficile il miglioramento dei sistemi, poiché non consente di identificare la fase specifica in cui si verifica l'errore. Un recente preprint affronta questo limite proponendo un metodo di audit che registra eventi intermedi durante l'inferenza, consentendo una categorizzazione più granulare dei fallimenti.
L'opacità derivante dalla valutazione esclusivamente sull'esito finale impedisce una diagnosi precisa delle cause radice dei fallimenti, rendendo impossibile distinguere tra un errore di localizzazione del documento e un errore di interpretazione del contenuto. Senza una visibilità sulle fasi intermedie, gli sviluppatori non possono allocare efficacemente le risorse per correggere specifici punti deboli nel processo di inferenza dell'agente.
La proposta di un metodo di audit che catturi eventi intermedi durante l'inferenza rappresenta un cambio di paradigma rispetto alle metriche aggregati. Questo approccio consente di mappare il percorso decisionale dell'agente, offrendo una granularità necessaria per identificare se il fallimento risiede nella capacità di recupero, nella gestione delle informazioni recuperate o nella generazione della risposta finale.
Checkpoint decisionali durante la ricerca
Lo studio introduce 'decision checkpoint' che registrano osservazioni e azioni degli strumenti durante l'inferenza, senza utilizzare etichette della benchmark in tempo reale. Questi registri catturano se l'agente ha esposto il documento obiettivo e se ha tentato di ispezionarlo.
Successivamente, le identità degli obiettivi e le etichette del valutatore vengono unite agli eventi registrati per assegnare categorie di esito. Questo protocollo rende esplicite le differenze a livello di domanda, separando l'esposizione e l'ispezione dell'obiettivo dall'accuratezza aggregata e dall'uso totale degli strumenti.
L'uso di 'decision checkpoint' permette di tracciare le interazioni dell'agente con gli strumenti senza contaminare il processo di inferenza con etichette della benchmark in tempo reale. Questa separazione tra registrazione e valutazione garantisce che i dati raccolti riflettano il comportamento naturale dell'agente, preservando l'integrità sperimentale del protocollo di audit.
La successiva unione delle identità degli obiettivi con gli eventi registrati consente una categorizzazione a posteriori che è più robusta e dettagliata. Questo protocollo esplicita le differenze a livello di singola domanda, permettendo di analizzare come l'esposizione e l'ispezione dell'obiettivo si correlino con l'accuratezza aggregata e l'uso complessivo degli strumenti, offrendo una visione multidimensionale delle prestazioni.
Flusso di audit proposto
Il processo registra eventi in tempo reale e li classifica a posteriori.
- 01Registrazione di osservazioni e azioni degli strumenti durante l'inferenza.
- 02Unione delle identità degli obiettivi e delle etichette del valutatore.
- 03Assegnazione di categorie di esito basate sugli eventi registrati.
Condizioni sperimentali e cifre comparative
L'esperimento è stato condotto in un ambiente fisso arricchito con documenti obiettivo, utilizzando 540 domande rispondibili di AutoResearchBench Deep. Sono state valutate cinque diverse condizioni di ricerca.
In questo contesto, la ricerca per parole chiave ha raggiunto un'accuratezza del 24,6 %, mentre la ricerca grezza ha ottenuto il 17,8 %. La condizione di lettura preliminare ha registrato il 27,4 % in più di chiamate di ricerca di evidenze rispetto alla ricerca per parole chiave.
L'ambiente sperimentale, essendo fisso e arricchito con documenti obiettivo, crea un contesto controllato che facilita la misurazione delle variabili specifiche ma limita la trasferibilità dei risultati. Le 540 domande di AutoResearchBench Deep utilizzate per la valutazione sono state selezionate per essere rispondibili, il che esclude dalla misurazione i casi in cui la domanda stessa non ha una risposta valida nel corpus fornito.
Le differenze nelle prestazioni tra le condizioni, come l'accuratezza del 24,6 % per la ricerca per parole chiave rispetto al 17,8 % per la ricerca grezza, evidenziano l'impatto delle strategie di ricerca sulla capacità di localizzare le informazioni rilevanti. La condizione di lettura preliminare, pur mostrando un aumento del 27,4 % nelle chiamate di ricerca di evidenze, non ha superato l'accuratezza della ricerca per parole chiave, suggerendo che una maggiore attività di ricerca non si traduce automaticamente in una migliore accuratezza.
Risultati chiave dell'esperimento
Confronto di accuratezza e attività degli strumenti in condizioni selezionate.
| Condizione | Accuratezza | Note aggiuntive |
|---|---|---|
| Ricerca per parole chiave | 24,6 % | Meno risposte errate senza esposizione né ispezione. |
| Ricerca grezza | 17,8 % | Accuratezza inferiore nell'ambiente fisso. |
| Lettura preliminare | 24,6 % | 27,4 % in più di chiamate di ricerca di evidenze. |
Separazione dei fallimenti di recupero, ispezione e risposta
I dati rivelano che la ricerca per parole chiave ha meno risposte errate in cui non c'è stata né esposizione né ispezione dell'obiettivo, ma più risposte errate dopo che l'obiettivo è stato esposto e lasciato senza ispezione.
I tentativi di ispezione dell'obiettivo si sono verificati in 199 domande nella condizione di lettura preliminare e in 191 nella ricerca per parole chiave. Entrambe le condizioni hanno raggiunto la stessa accuratezza del 24,6 %, il che suggerisce che la mera ispezione non garantisce la correttezza della risposta finale.
La distinzione tra fallimenti di recupero, ispezione e risposta è fondamentale per comprendere la natura degli errori commessi dagli agenti. I dati indicano che la ricerca per parole chiave riduce i fallimenti totali di recupero, ma aumenta i casi in cui l'obiettivo viene esposto senza essere ispezionato, indicando un possibile problema nella gestione delle informazioni recuperate piuttosto che nella loro localizzazione.
Il fatto che entrambe le condizioni di lettura preliminare e ricerca per parole chiave abbiano raggiunto la stessa accuratezza del 24,6 %, nonostante un numero diverso di tentativi di ispezione (199 contro 191), suggerisce che la semplice esposizione al documento obiettivo non è sufficiente per garantire una risposta corretta. Questo risultato sottolinea l'importanza della qualità dell'ispezione e della capacità dell'agente di estrarre e sintetizzare le informazioni rilevanti dal documento.
Limiti della generalizzazione dei risultati
È cruciale sottolineare che questi risultati provengono da un ambiente sperimentale fisso e arricchito con documenti obiettivo. Questa configurazione introduce bias che potrebbero non riflettere la complessità della ricerca scientifica in ambienti aperti e dinamici.
Inoltre, il lavoro è un preprint presentato nel settembre 2026, quindi non ha superato la peer review. Le cifre e le conclusioni devono essere interpretate come valide per quella specifica configurazione e non come una prova di affidabilità generale degli agenti di IA in tutti i contesti di ricerca scientifica.
La natura di preprint del lavoro, presentato nel settembre 2026, impone una cautela nell'interpretazione dei risultati. L'assenza di peer review significa che i metodi e le conclusioni non sono stati sottoposti a una valutazione critica indipendente, il che limita la certezza con cui si possono generalizzare i risultati a contesti diversi da quello sperimentale specifico.
I bias introdotti dall'ambiente arricchito e dalla selezione delle domande rispondibili potrebbero non riflettere la complessità e l'incertezza presenti nella ricerca scientifica reale. Pertanto, le cifre e le conclusioni devono essere considerate valide solo per quella specifica configurazione, e non come una dimostrazione dell'affidabilità generale degli agenti di IA in tutti i contesti di ricerca scientifica, dove le variabili sono molte più e meno controllate.
Questioni aperte
- Non sono specificati i modelli di IA esatti utilizzati nelle cinque condizioni.
- Non è dettagliato come sia stato costruito esattamente l'ambiente arricchito né quali bias specifici introduca.
- Non vengono menzionati dati o tracce pubbliche disponibili per riprodurre le categorie di fallimento.
- Lo studio è un preprint, quindi le sue conclusioni non sono state validate dalla peer review.
Continua a esplorare
Fonti consultate
Correzioni e trasparenza
Se trovi un dato errato o non aggiornato, inviaci la pagina e la fonte da verificare.
Proponi una correzione