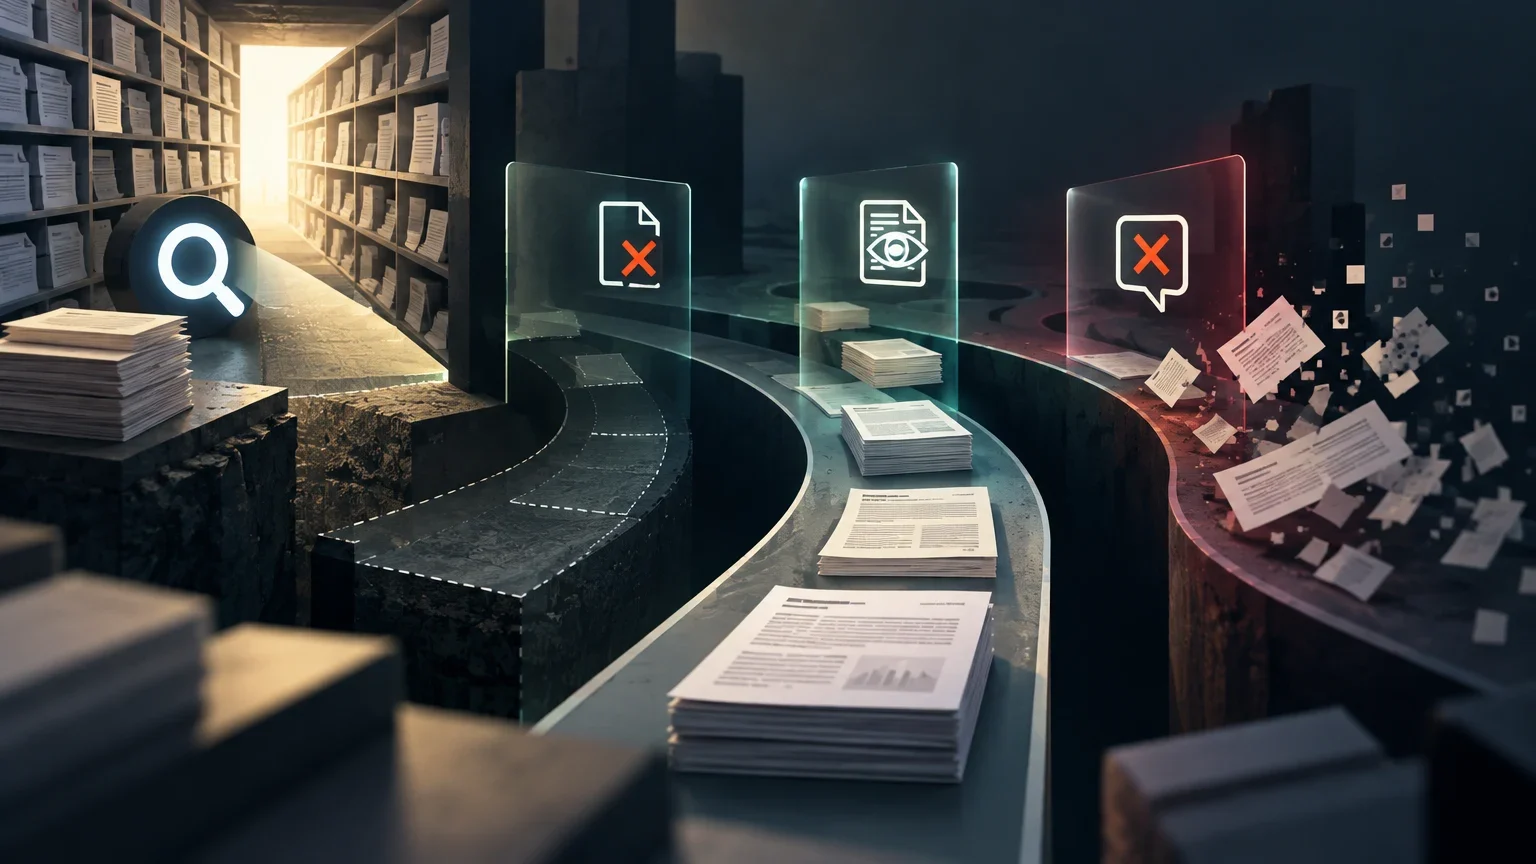
La limitación de evaluar solo la respuesta final
La evaluación tradicional de agentes de búsqueda científica se centra en la precisión de la respuesta final. Sin embargo, esta métrica agrupa fallos heterogéneos: un agente puede fallar porque no encuentra el documento objetivo, porque lo encuentra pero no lo inspecciona, o porque lo inspecciona pero genera una respuesta incorrecta.
Esta opacidad dificulta la mejora de los sistemas, ya que no permite identificar la etapa específica donde se produce el error. Un preprint reciente aborda esta limitación proponiendo un método de auditoría que registra eventos intermedios durante la inferencia, permitiendo una categorización más granular de los fallos.
La precisión final conserva valor como medida del resultado, pero por sí sola no explica cómo se llegó a él. Dos respuestas igualmente incorrectas pueden corresponder a problemas distintos: en una, el sistema nunca encontró el documento relevante; en otra, tuvo acceso a ese documento, pero no lo examinó; y en una tercera, sí lo inspeccionó, aunque después produjo una respuesta errónea. Si esos casos se contabilizan juntos, la cifra agregada no permite distinguir qué capacidad necesita atención.
La auditoría propuesta añade una lectura del proceso sin reemplazar la evaluación de la respuesta. Su propósito es hacer visible la secuencia que precede al resultado y vincularla con cada pregunta, de modo que un fallo pueda describirse con mayor precisión. Esta separación también evita interpretar automáticamente una puntuación baja como evidencia de un único defecto: la respuesta final resume el desenlace, mientras que los eventos intermedios ayudan a localizar en qué etapa se interrumpió o se desvió el trabajo del agente.
Puntos de control de decisión durante la búsqueda
El estudio introduce 'decision checkpoints' que registran observaciones y acciones de herramientas durante la inferencia, sin utilizar etiquetas de la benchmark en tiempo real. Estos registros capturan si el agente expuso el documento objetivo y si intentó inspeccionarlo.
Posteriormente, las identidades de los objetivos y las etiquetas del evaluador se unen a los eventos registrados para asignar categorías de resultado. Este protocolo hace explícitas las diferencias a nivel de pregunta, separando la exposición e inspección del objetivo de la precisión agregada y el uso total de herramientas.
Los puntos de control registran lo que el agente observa y las acciones que realiza con herramientas mientras resuelve una pregunta. La distinción temporal es relevante: durante la inferencia se guardan los eventos, pero no se incorporan las etiquetas de evaluación de la benchmark para guiar esa ejecución. Así, la auditoría pretende describir el comportamiento observado y no convertir la respuesta esperada en una señal disponible para el agente durante la búsqueda.
La clasificación se construye después, al combinar esos registros con la identidad del documento objetivo y las etiquetas del evaluador. Esta unión permite determinar, para cada pregunta, si el objetivo llegó a estar expuesto y si hubo un intento de inspección, y relacionar esas circunstancias con el resultado evaluado. En consecuencia, el procedimiento ofrece categorías de fallo más informativas que una comparación global de respuestas correctas e incorrectas, aunque depende de que los eventos y las etiquetas se puedan asociar de manera adecuada.
También conviene distinguir qué mide cada parte del protocolo. La exposición indica que el documento objetivo apareció entre las observaciones registradas; el intento de inspección recoge una acción posterior del agente; y la etiqueta del evaluador describe el resultado de la respuesta. Ninguno de estos elementos, considerado aisladamente, equivale a demostrar que el agente comprendió el documento. El valor de los puntos de control está en separar esos pasos para analizarlos, no en suponer que cada paso garantiza el siguiente.
Flujo de auditoría propuesto
El proceso registra eventos en tiempo real y los clasifica a posteriori.
- 01Registro de observaciones y acciones de herramientas durante la inferencia.
- 02Unión de identidades de objetivos y etiquetas del evaluador.
- 03Asignación de categorías de resultado basadas en eventos registrados.
Condiciones experimentales y cifras comparativas
El experimento se realizó en un entorno fijo enriquecido con documentos objetivo, utilizando 540 preguntas contestables de AutoResearchBench Deep. Se evaluaron cinco condiciones diferentes de búsqueda.
En este contexto, la búsqueda por palabras clave alcanzó una precisión del 24,6 %, mientras que la búsqueda cruda obtuvo un 17,8 %. La condición de lectura previa registró un 27,4 % más de llamadas de búsqueda de evidencia en comparación con la búsqueda por palabras clave.
Las cifras deben leerse dentro de las condiciones descritas: una colección de 540 preguntas contestables de AutoResearchBench Deep, en un entorno fijo enriquecido con los documentos objetivo, y cinco condiciones de búsqueda. Por tanto, la comparación muestra cómo se comportaron esas condiciones en esa configuración concreta. No describe por sí misma el rendimiento que se obtendría con otra colección, otro entorno o una disponibilidad distinta de los documentos.
En esa prueba, la búsqueda por palabras clave obtuvo un 24,6 % de precisión y la búsqueda cruda un 17,8 %. La condición de lectura previa también alcanzó un 24,6 %, pero registró un 27,4 % más de llamadas de búsqueda de evidencia que la condición por palabras clave. La precisión y la actividad de herramientas representan dimensiones diferentes: que dos condiciones compartan una cifra de precisión no implica que hayan seguido el mismo proceso ni que hayan requerido el mismo número de llamadas.
Por ello, el dato de actividad no debe interpretarse como una mejora automática de calidad. El mayor número de llamadas registrado para la lectura previa describe un patrón de uso de herramientas en el experimento; por sí solo no establece que cada llamada haya aportado información útil ni que una mayor actividad produzca respuestas más correctas. Del mismo modo, la diferencia de precisión entre búsqueda por palabras clave y búsqueda cruda corresponde a las condiciones evaluadas y no basta para atribuir el resultado a un mecanismo que el experimento no haya aislado.
Resultados clave del experimento
Comparación de precisión y actividad de herramientas en condiciones seleccionadas.
| Condición | Precisión | Notas adicionales |
|---|---|---|
| Búsqueda por palabras clave | 24,6 % | Menos respuestas incorrectas sin exposición ni inspección. |
| Búsqueda cruda | 17,8 % | Precisión inferior en el entorno fijo. |
| Lectura previa | 24,6 % | 27,4 % más llamadas de búsqueda de evidencia. |
Separación de fallos de recuperación, inspección y respuesta
Los datos revelan que la búsqueda por palabras clave tiene menos respuestas incorrectas donde no hubo exposición ni inspección del objetivo, pero más respuestas incorrectas después de que el objetivo fue expuesto y dejado sin inspeccionar.
Los intentos de inspección del objetivo ocurrieron en 199 preguntas bajo la condición de lectura previa y en 191 bajo la búsqueda por palabras clave. Ambas condiciones lograron la misma precisión del 24,6 %, lo que sugiere que la mera inspección no garantiza la corrección de la respuesta final.
La separación entre categorías ayuda a explicar por qué una misma precisión puede ocultar trayectorias distintas. Los datos indican que la búsqueda por palabras clave tuvo menos respuestas incorrectas en preguntas donde el objetivo no fue expuesto ni inspeccionado, pero más respuestas incorrectas en preguntas donde el objetivo apareció y quedó sin inspeccionar. Esa descripción se refiere a categorías observadas en la auditoría; no demuestra, por sí sola, qué decisión concreta causó cada diferencia ni que el mismo patrón vaya a repetirse fuera de la prueba.
Los intentos de inspección se registraron en 199 preguntas con lectura previa y en 191 con búsqueda por palabras clave. Junto con la precisión idéntica del 24,6 % en ambas condiciones, estas cifras muestran que contabilizar intentos de inspección no equivale a contabilizar respuestas correctas. Un intento es un evento del proceso, no una confirmación de que el documento se haya interpretado correctamente ni de que la respuesta final refleje su contenido.
La etiqueta «exposición sin inspección» permite conservar una diferencia que una métrica final borraría: el agente tuvo el documento entre sus observaciones, pero no intentó examinarlo. En cambio, cuando el objetivo nunca aparece, el registro apunta a una dificultad de recuperación o exposición. Esta nomenclatura sirve para ordenar el análisis por etapa; no convierte automáticamente cada etiqueta en una explicación causal ni elimina la posibilidad de que existan otros factores que los datos registrados no permiten discernir.
Límites de la generalización de los resultados
Es crucial señalar que estos resultados provienen de un entorno experimental fijo y enriquecido con documentos objetivo. Esta configuración introduce sesgos que pueden no reflejar la complejidad de la búsqueda científica en entornos abiertos y dinámicos.
Además, el trabajo es un preprint presentado en septiembre de 2026, por lo que no ha pasado por revisión por pares. Las cifras y conclusiones deben interpretarse como válidas para esa configuración específica y no como una prueba de fiabilidad general de los agentes de IA en todos los contextos de búsqueda científica.
El entorno enriquecido con documentos objetivo es una condición experimental importante para interpretar los resultados. Al mantener fija la configuración y disponer los objetivos dentro de ella, la prueba permite comparar las condiciones evaluadas bajo un marco común, pero no reproduce necesariamente las dificultades de una búsqueda científica abierta y cambiante. El texto señala que ese diseño puede introducir sesgos; como no especifica cuáles ni cómo se construyó exactamente el entorno, no corresponde atribuirle mecanismos concretos adicionales.
Tampoco se detallan aquí los modelos exactos empleados en las cinco condiciones ni se indica si las trazas o los datos necesarios para reproducir la clasificación están disponibles públicamente. Esas ausencias limitan lo que puede concluirse sobre la reproducibilidad y sobre la posibilidad de separar el efecto de cada componente del procedimiento. La auditoría aporta una forma de organizar los eventos registrados, pero la información descrita no basta para reconstruir por completo la implementación o trasladar sus resultados a otros sistemas.
Finalmente, el trabajo se presenta como un preprint de septiembre de 2026 y todavía no ha pasado por revisión por pares. Esto no invalida automáticamente las observaciones, pero sí aconseja mantenerlas en el nivel que permite la evidencia: resultados de una evaluación concreta, útiles para examinar categorías de fallo, no una validación general de la fiabilidad de los agentes de búsqueda científica. La fecha y el estado de publicación forman parte del alcance de la evidencia disponible y deben acompañar cualquier lectura de las cifras.
Qué sigue abierto
- No se especifican los modelos de IA exactos utilizados en las cinco condiciones.
- No se detalla cómo se construyó exactamente el entorno enriquecido ni qué sesgos específicos introduce.
- No se mencionan datos o trazas públicas disponibles para reproducir las categorías de fallo.
- El estudio es un preprint, por lo que sus conclusiones no han sido validadas por revisión por pares.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección