Qué sabemos y qué todavía no demuestra la documentación
La pregunta de este benchmark no es si una imagen parece atractiva ni si el modelo puede producir una edición convincente en un ejemplo aislado. Es más concreta: cuando una persona solicita varios cambios en turnos sucesivos, ¿se aplican los cambios pedidos y se mantienen estables los elementos que no debía tocar? También interesa saber si los errores de una edición pasan a la siguiente y se acumulan.
Google presenta Nano Banana 2 en documentación dirigida a desarrolladores y describe capacidades relacionadas con la generación y edición de imágenes y la iteración. Esa descripción sirve para identificar el propósito anunciado, pero no equivale a una medición independiente de la conservación de detalles a lo largo de varios turnos. En las fuentes disponibles no se aportan resultados cuantitativos sobre esta tarea concreta ni un protocolo que permita inferir un nivel de rendimiento.
Por tanto, lo que sigue es una propuesta de evaluación, no un informe de resultados. No atribuye al modelo una tasa de éxito, no lo declara mejor o peor que una alternativa y no asume que una edición mantenga automáticamente el estado de la anterior. Antes de ejecutar la prueba habrá que confirmar qué versión exacta se puede consultar, por qué interfaz y con qué controles.
La pregunta operativa del benchmark
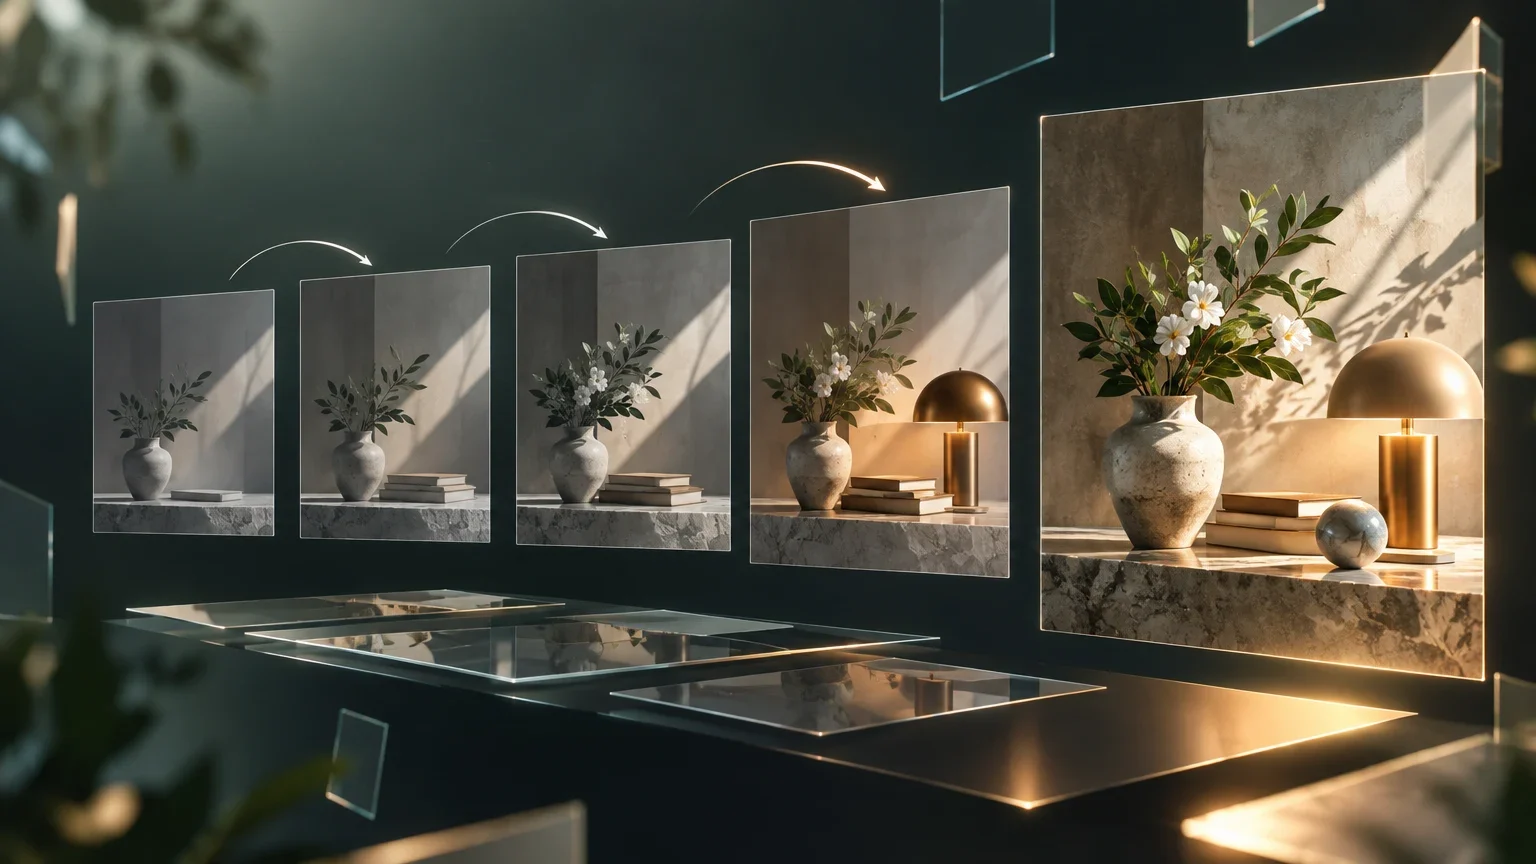
El caso de uso consiste en partir de una imagen y pedir cambios secuenciales. Por ejemplo, primero cambiar el color de una chaqueta, después sustituir el fondo y finalmente añadir un objeto a una mesa. En cada paso, la prueba debe comprobar tanto el cambio solicitado como la conservación de elementos ajenos a ese cambio: rostro, pose, prendas no mencionadas, objetos, encuadre y rasgos relevantes del fondo.
La evaluación debe separar dos obligaciones. La primera es el cumplimiento: ¿aparece el cambio que pidió la instrucción? La segunda es la conservación: ¿permanecen suficientemente estables los elementos que se habían designado como controles? Una salida puede cumplir una y fallar la otra. Si solo se califica la semejanza general o el atractivo, esos fallos pueden quedar ocultos.
También debe registrarse si el resultado de un turno introduce defectos que condicionan los turnos posteriores. Una mano deformada al principio puede seguir deformada después, aunque las instrucciones siguientes se refieran a otros elementos. El benchmark no debería atribuir automáticamente ese defecto a la última instrucción: hace falta conservar las imágenes de cada etapa y puntuar la trayectoria completa.
Qué se puntúa por separado
| Dimensión | Pregunta | Ejemplo de fallo |
|---|---|---|
| Cumplimiento del cambio | ¿Se realizó el cambio pedido en ese turno? | Se pide cambiar el color de una chaqueta y sigue igual. |
| Conservación | ¿Se mantuvieron los elementos designados como no modificables? | Cambian también la pose o el rostro. |
| Coherencia de la trayectoria | ¿El resultado sigue siendo compatible con la imagen inicial y los turnos previos? | Una modificación sustituye detalles que ya se habían aceptado. |
| Errores acumulados | ¿Aparecen o persisten defectos a través de los turnos? | Un objeto se duplica y la duplicación se mantiene en las salidas siguientes. |
Diseño de tareas y selección de imágenes
El conjunto de prueba debe incluir imágenes iniciales variadas, con personas, objetos, escenas interiores y exteriores, y distintos niveles de complejidad. La variedad no demuestra por sí sola representatividad; sirve para comprobar si el comportamiento observado depende del tipo de contenido. Las conclusiones deberán limitarse a las categorías y condiciones realmente evaluadas.
Para cada imagen, conviene preparar de antemano una secuencia de instrucciones y una lista de elementos objetivo y de control. Los objetivos son los elementos que se pide cambiar. Los controles son aquellos que la instrucción no debe alterar. Una ficha de tarea puede indicar qué debe cambiar, qué debe conservarse, qué cambios colaterales se consideran importantes y qué ambigüedades podrían hacer que distintos evaluadores discrepen.
Las instrucciones han de ser específicas, pero no tan rígidas que conviertan el benchmark en una comprobación de una única respuesta exacta. Por ejemplo, cambiar una taza por una taza azul puede admitir variación en forma y textura; conservar el número de personas o mantener la posición aproximada de una lámpara puede ser un criterio más objetivo. Antes de consultar el modelo, se deben fijar los criterios de aceptación y las exclusiones.
La selección de casos también debe evitar quedarse solo con ejemplos fáciles o visualmente llamativos. Se recomienda informar cómo se reunieron las imágenes, cuántas tareas se excluyeron y por qué. Si se emplean materiales con restricciones de uso o datos personales, el protocolo debe documentar su procedencia y las medidas pertinentes. Las fuentes disponibles no permiten afirmar qué datos de entrenamiento se usaron para el modelo ni si existe solapamiento con un conjunto de evaluación concreto; esa incertidumbre debe mantenerse explícita.
Condiciones de ejecución y comparación
Antes de ejecutar casos, el equipo debe identificar el modelo y la versión exactos que ofrece el canal de acceso elegido. El nombre visible en una página o interfaz no basta si no permite distinguir con certeza Nano Banana 2 de otros modelos de imagen. También hay que registrar la fecha de prueba, la interfaz o API, los parámetros disponibles, el formato y tamaño de las imágenes, y cualquier instrucción del sistema que afecte a la edición.
Una condición fundamental es el manejo del estado entre turnos. La interfaz podría conservar el contexto de la conversación, o la persona que realiza la prueba podría tener que enviar de nuevo la imagen resultante en cada paso. No son condiciones intercambiables: en el segundo caso, el modelo recibe una nueva imagen como entrada en cada turno. El protocolo debe especificar qué ocurre y conservar tanto las instrucciones como las imágenes enviadas y recibidas.
Como referencia, puede compararse el flujo iterativo con una condición de una sola pasada: una instrucción reúne los cambios previstos en la secuencia y se realiza una edición. La comparación solo será informativa si ambos flujos usan el mismo modelo, imágenes iniciales, calidad de entrada, parámetros y oportunidades de generación, en la medida en que el canal lo permita. Si esas condiciones difieren, hay que declararlo y evitar atribuir la diferencia exclusivamente al número de turnos.
La comparación no es siempre perfectamente equivalente. Una instrucción conjunta puede ser más larga o ambigua que las instrucciones sucesivas, y una secuencia puede permitir correcciones que una sola pasada no ofrece. Esas diferencias forman parte de la pregunta práctica, pero deben describirse con precisión. Si el acceso no permite configurar una condición comparable, el equipo puede ejecutar la prueba iterativa y presentarla como tal, sin afirmar que ha demostrado una ventaja frente a una pasada única.
Preparación mínima antes de la prueba
- 01Confirmar la identificación del modelo y la versión disponible.
- 02Registrar el canal de acceso, la fecha y todos los parámetros expuestos.
- 03Determinar si el estado se conserva en la conversación o si cada turno requiere reenviar la imagen.
- 04Congelar imágenes, instrucciones, elementos objetivo, controles y reglas de exclusión.
- 05Definir de antemano cuántas ejecuciones se harán por caso y cómo se tratarán los fallos.
Métricas, revisión humana y resultados
El resultado principal no debería resumirse en una puntuación única sin explicar qué combina. Como mínimo, se informarán por separado el cumplimiento de cada cambio, la conservación de cada control, la coherencia con la imagen inicial y los errores nuevos o persistentes. Se puede calcular el porcentaje de criterios aprobados, pero también deben presentarse los recuentos y ejemplos de fallos para que la agregación no oculte casos importantes.
La evaluación humana es pertinente porque algunos criterios —como preservar la apariencia de una persona— pueden requerir juicio visual. Para reducir sesgos, la rúbrica debe escribirse antes de examinar las salidas. Cuando sea viable, quienes puntúan no deberían saber qué condición produjo cada imagen. Si hay varias personas evaluadoras, se informará el grado de acuerdo y cómo se resolvieron desacuerdos. No se debe presentar una impresión informal como si fuera una medición reproducible.
Las métricas automáticas pueden ayudar a comparar imágenes o detectar cambios, pero no deben sustituir la comprobación de que se cumplió la intención de una instrucción. El equipo tendrá que especificar qué herramientas usó y qué aspecto miden. Una similitud global alta, por ejemplo, podría coexistir con el cambio incorrecto de un detalle pequeño; una diferencia global elevada podría ser esperable cuando se solicita sustituir un fondo.
Para describir variación entre ejecuciones, se repetirán casos bajo condiciones documentadas, siempre que el canal permita nuevas generaciones. El número de repeticiones deberá fijarse antes de interpretar los resultados y publicarse junto con los fallos, las salidas no válidas y cualquier incidencia. No conviene seleccionar solo la mejor salida de cada caso: esa práctica mide el rendimiento tras seleccionar resultados, no la fiabilidad de una ejecución normal.
Rúbrica de puntuación propuesta
| Criterio | Escala sugerida | Qué registrar |
|---|---|---|
| Cambio solicitado | Cumple / parcial / no cumple | Presencia y grado del cambio, con criterio específico por tarea. |
| Conservación de controles | Conservado / alterado / no evaluable | Elemento observado y tipo de alteración. |
| Coherencia entre turnos | Sin regresión / regresión menor / regresión importante | Qué elemento previamente aceptado cambió y en qué turno. |
| Validez de la salida | Válida / fallo técnico / no puntuable | Motivo de la exclusión o del fallo, sin borrarlo del recuento. |
Reproducibilidad, límites y alcance de las conclusiones
Un informe reproducible debe publicar la lista de tareas, las instrucciones exactas, la procedencia o descripción de las imágenes, los parámetros disponibles, el número de ejecuciones y la rúbrica. También debe mostrar los resultados fallidos y explicar las exclusiones. Cuando no se puedan compartir imágenes por licencia, privacidad u otras restricciones, se debe explicar esa limitación y ofrecer suficiente descripción para entender cómo se formaron los casos.
Los antecedentes disponibles no resuelven por sí solos esta evaluación. Un estudio de Nano Banana Pro sobre distintas tareas de visión es evidencia relativa a otro modelo y a otro diseño de prueba; no permite trasladar sus conclusiones a Nano Banana 2 ni a la edición conversacional por turnos. Del mismo modo, un benchmark de Nano Banana 2 Lite no es una comparación directa del modelo exacto aquí propuesto. Una evaluación de restauración de imágenes de Nano Banana 2 puede aportar contexto sobre una tarea relacionada, pero no mide necesariamente la conservación de elementos tras instrucciones sucesivas.
Si se ejecuta el protocolo, las conclusiones deberán limitarse a las versiones, condiciones, imágenes y tareas probadas. Un buen resultado en unas pocas escenas no demuestra fiabilidad para toda edición visual, para otros canales de acceso ni para usos profesionales con requisitos distintos. Tampoco permite concluir nada sobre el comportamiento en tareas no incluidas. Si no se dispone de un canal verificable para identificar el modelo o registrar las condiciones, la prueba puede describirse como exploratoria, no como una comparación plenamente reproducible.
Criterios prácticos antes de tomar una decisión
Para un equipo que valore incorporar la edición por turnos a un flujo de trabajo, la decisión debería apoyarse en tareas cercanas a su propio uso, no solo en imágenes de demostración elegidas por el proveedor. Conviene priorizar los elementos cuya alteración tendría consecuencias importantes, como identidad, texto, logotipos, objetos de producto o componentes de una escena, y definir qué nivel de cambio colateral sería aceptable.
Antes de interpretar cualquier puntuación, compruebe cuatro cosas: que el modelo probado esté identificado sin ambigüedad; que se conozca cómo se transmite el estado entre turnos; que los cambios solicitados y los elementos que deben conservarse se puntúen por separado; y que el informe incluya variación, errores y límites. Si falta una de ellas, la evidencia resultante será más débil y la incertidumbre debe influir en la decisión.
La documentación disponible justifica plantear la pregunta de evaluación, pero no anticipa su respuesta. El paso siguiente no es proclamar un ganador, sino ejecutar una prueba controlada, conservar el registro completo y publicar resultados que permitan distinguir una edición acertada de una secuencia realmente estable.
Qué sigue abierto
- La documentación disponible no establece aquí una métrica cuantitativa verificable para conservar detalles durante ediciones sucesivas.
- Debe confirmarse qué canal identifica inequívocamente Nano Banana 2 y qué versión exacta ejecuta.
- No se ha verificado si el canal mantiene el estado entre turnos o requiere reenviar la imagen editada.
- No se dispone de información suficiente para fijar parámetros, número de ejecuciones o condiciones técnicas concretas de acceso.
- Las fuentes aportadas no demuestran si las imágenes de cualquier conjunto de prueba se solapan con datos de entrenamiento.
- Los estudios aportados sobre Nano Banana Pro, Nano Banana 2 Lite y restauración de imágenes no son resultados directos sobre la tarea de edición visual por turnos aquí propuesta.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección