¿Qué tareas contiene?
Cobertura, dificultad, idioma, actualidad y posible contaminación.
MuestraUna métrica solo es útil cuando conocemos la tarea, las condiciones y el error que importa.
El resultado empieza por el diseño de la prueba.
Cobertura, dificultad, idioma, actualidad y posible contaminación.
MuestraExactitud, preferencia humana, coste, tiempo o tasa de éxito.
ObjetivoPrompt, herramientas, razonamiento, muestras y presupuesto.
EquidadConvierte necesidades reales en un conjunto pequeño y repetible.
Incluye casos normales, bordes y fallos costosos.
CasosSepara corrección, utilidad, seguridad y formato.
CriterioModelo, recuperación, herramientas, latencia y coste.
ProducciónResultados agrupados por prueba, modelo, métrica y fuente.
Resultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 2 modelos.
2 · Fuentes ↗ BENCHMARKResultados documentados para 2 modelos.
2 · Fuentes ↗ BENCHMARKResultados documentados para 2 modelos.
2 · Fuentes ↗ BENCHMARKResultados documentados para 2 modelos.
2 · Fuentes ↗ BENCHMARKResultados documentados para 2 modelos.
2 · Fuentes ↗ BENCHMARKResultados documentados para 2 modelos.
2 · Fuentes ↗ BENCHMARKResultados documentados para 2 modelos.
2 · Fuentes ↗ BENCHMARKResultados documentados para 2 modelos.
2 · Fuentes ↗ BENCHMARKResultados documentados para 2 modelos.
2 · Fuentes ↗ BENCHMARKResultados documentados para 3 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 2 modelos.
2 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 3 modelos.
2 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 4 modelos.
4 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 2 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 2 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 2 modelos.
2 · Fuentes ↗ BENCHMARKResultados documentados para 6 modelos.
5 · Fuentes ↗ BENCHMARKResultados documentados para 2 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 6 modelos.
5 · Fuentes ↗ BENCHMARKResultados documentados para 2 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 4 modelos.
4 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 2 modelos.
2 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 2 modelos.
2 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 5 modelos.
2 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 5 modelos.
5 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 4 modelos.
4 · Fuentes ↗ BENCHMARKResultados documentados para 4 modelos.
4 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 5 modelos.
2 · Fuentes ↗ BENCHMARKResultados documentados para 2 modelos.
2 · Fuentes ↗ BENCHMARKResultados documentados para 2 modelos.
2 · Fuentes ↗ BENCHMARKResultados documentados para 4 modelos.
4 · Fuentes ↗ BENCHMARKResultados documentados para 3 modelos.
2 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 2 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗ BENCHMARKResultados documentados para 4 modelos.
4 · Fuentes ↗ BENCHMARKResultados documentados para 4 modelos.
4 · Fuentes ↗ BENCHMARKResultados documentados para 1 modelos.
1 · Fuentes ↗
Análisis metodológico de la métrica 'Content' dentro del benchmark de AesCode. Se define su papel en la evaluación de la fidelidad semántica de infografías generadas como código, su integración con otras métricas visuales y las limitaciones para su comparación con otros estándares de la industria.
17 oct. 2026 ↗
La documentación pública describe el canal Chart, informa resultados y ofrece código de evaluación. Pero no publica los conjuntos de datos: eso limita la reproducción independiente y la interpretación de las puntuaciones.
16 oct. 2026 ↗
Análisis metodológico de la métrica 'Bound' en la suite de evaluación de AesCode de Microsoft. Se examina su función como restricción programática en la generación de infografías, su integración con otras métricas y los límites para la comparabilidad entre modelos.
16 oct. 2026 ↗
Un protocolo reproducible para examinar respuestas con evidencia suficiente, contradictoria o ausente. Esta propuesta no atribuye puntuaciones al modelo: define qué habría que fijar, medir y publicar antes de presentar resultados.
03 oct. 2026 ↗
Las fuentes disponibles apuntan a evaluaciones del proveedor, una ficha técnica y un estudio independiente de agentes IDE, pero no ofrecen suficiente detalle para tratarlas como una clasificación común. Esta guía separa lo que consta de lo que aún debe verificarse.
02 oct. 2026 ↗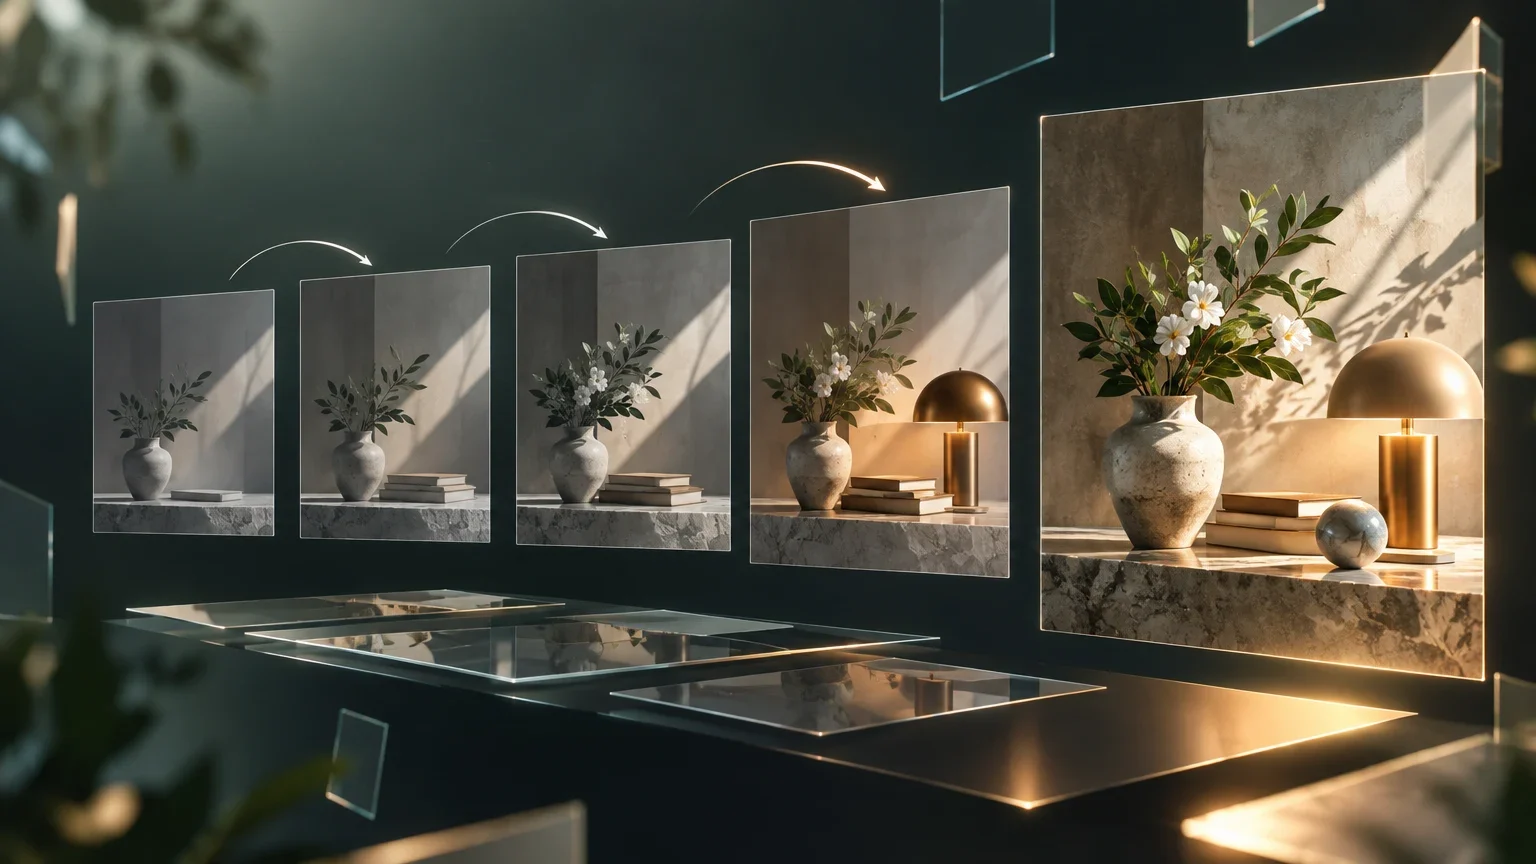
Un protocolo propuesto para medir si Nano Banana 2 aplica cambios sucesivos y conserva los elementos que las instrucciones no piden modificar. No presenta resultados experimentales: define qué habría que ejecutar y documentar para obtenerlos.
01 oct. 2026 ↗Un benchmark público orienta, pero no sustituye una evaluación con tus datos, herramientas, presupuesto y tolerancia al error.
Un alias móvil y un snapshot pueden producir resultados diferentes. Registra modelo, fecha y proveedor.
Prompt, razonamiento, herramientas, número de intentos y presupuesto deben ser equivalentes para comparar.
Una diferencia pequeña puede desaparecer entre ejecuciones. Conserva muestras, dispersión y fallos, no solo la media.
Valida si la mejora se mantiene en idiomas, formatos y casos reales cercanos a tu producto.
Resultados publicados y condiciones declaradas por sus fuentes. Las cifras solo son comparables cuando coinciden versión, configuración, métrica y fecha.
Referencias utilizadas para ampliar y revisar esta página.