Qu’est-ce que Quine et quel problème cherche-t-il à résoudre ?
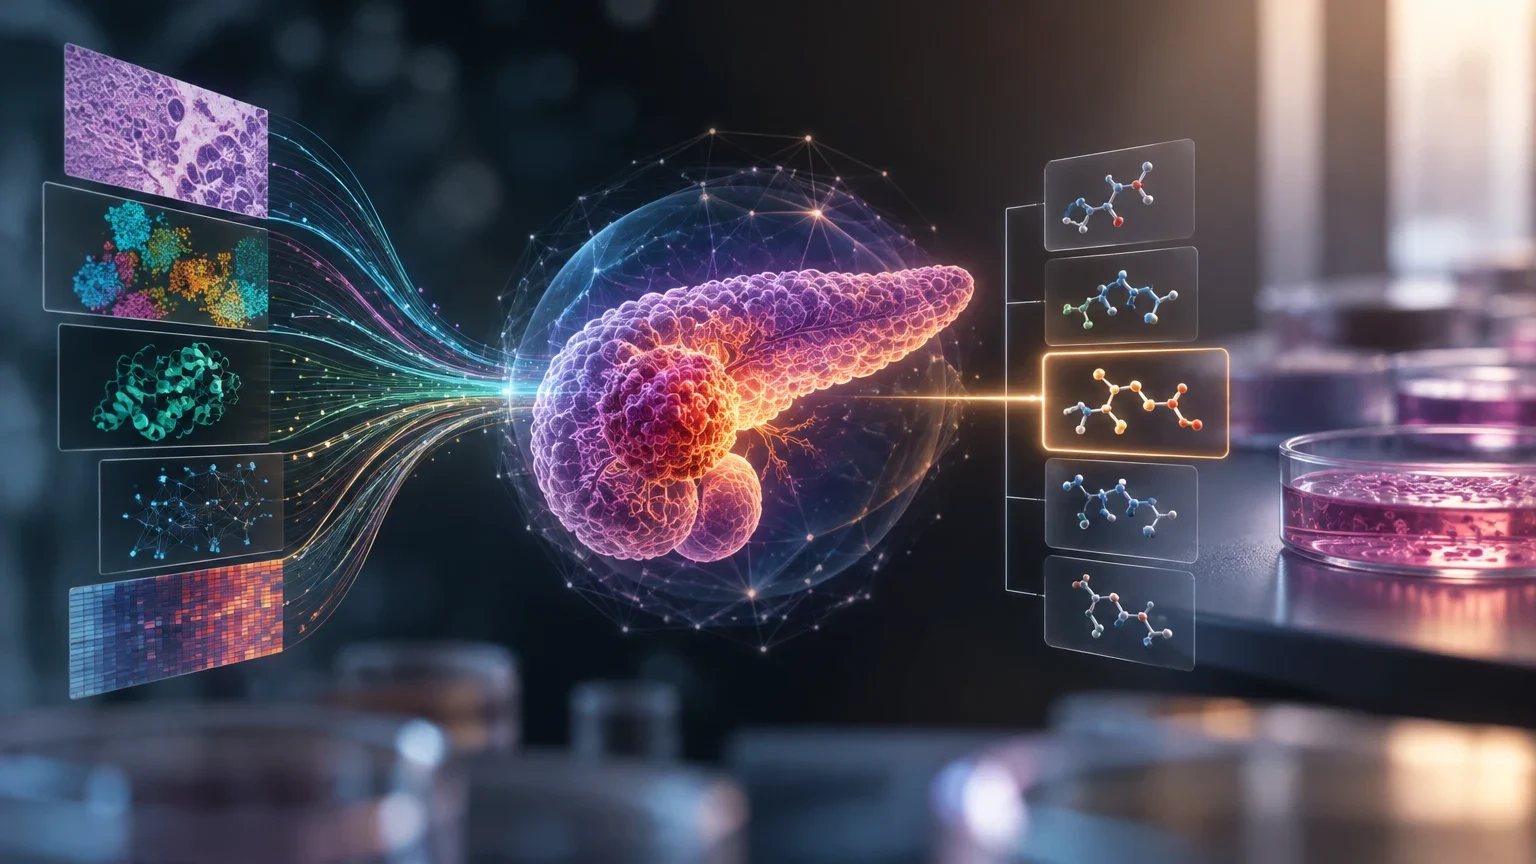
Microsoft Research a présenté Quine, une initiative expérimentale visant à explorer des questions biologiques en reliant des informations généralement étudiées séparément. Le projet associe un modèle multimodal de la biologie à un système interactif qui le met en relation avec des outils scientifiques, la littérature et des équipes de recherche. Son objectif déclaré est de représenter certains aspects des systèmes biologiques, d’anticiper leurs réponses possibles à des interventions et d’aider à déterminer quelles hypothèses devraient être testées en priorité.
Cette proposition part d’une contrainte pratique : les expériences biologiques prennent du temps et mobilisent des ressources, tandis que certaines questions impliquent trop de combinaisons pour être étudiées uniquement en laboratoire. Quine entend utiliser le calcul pour examiner un vaste éventail de possibilités et en dégager des pistes prioritaires. Une prédiction n’est toutefois pas une découverte : en principe, le modèle sert à orienter la recherche, tandis que des preuves expérimentales restent nécessaires pour vérifier si une hypothèse tient la route.
Le projet est présenté comme une première étape d’une vision à long terme, et non comme un outil scientifique éprouvé. Microsoft Research précise également que Quine est expérimental, que ses résultats peuvent être incomplets ou inexacts et qu’il n’est pas destiné à un usage clinique ou médical. L’annonce associe donc une architecture proposée à des résultats préliminaires communiqués par l’équipe elle-même ; elle ne constitue pas une démonstration indépendante de son utilité générale.
Relier les modalités et les échelles biologiques
D’après la description de Microsoft Research, le modèle apprend des représentations communes à plusieurs modalités et échelles. Parmi les types d’informations mentionnés figurent les séquences, la structure et la fonction biologiques, l’état cellulaire et les images. La description évoque également la génomique, les protéines, la chimie, l’ARN, l’état des cellules et la bio-imagerie. L’idée est qu’un signal observé dans un type de données puisse contribuer à une prédiction portant sur un autre, plutôt que de traiter chaque jeu de données comme un domaine isolé.
L’échelle compte parce que les phénomènes biologiques sont liés, des molécules et des cellules jusqu’aux tissus. Le projet vise à combiner ces niveaux afin de modéliser la manière dont une modification ou une intervention pourrait être associée à d’autres effets. Concrètement, une question portant sur l’état d’une cellule pourrait bénéficier d’informations moléculaires ou de résultats d’expériences antérieures. Mais le fait qu’une architecture soit conçue pour relier des modalités ne prouve pas automatiquement qu’elle le fasse avec précision, ni que les relations apprises soient causales.
Le second composant, que l’équipe désigne comme un système interactif ou « harness », relie le modèle aux outils scientifiques, à la littérature et aux chercheurs. L’idée est d’organiser une séquence de travail : formuler une question, produire des propositions, sélectionner des protocoles expérimentaux, mesurer les résultats, puis utiliser ces mesures pour orienter les questions suivantes. La publication décrit cette approche, mais ne fournit pas d’évaluation externe complète permettant de comparer ses performances à celles de modèles spécialisés, de méthodes conventionnelles ou de décisions prises par des experts.
Rôle de chaque composant selon la description du projet
| Composant | Fonction envisagée | Ce qu’il ne démontre pas à lui seul |
|---|---|---|
| Modèle multimodal | Apprendre des représentations reliant différents types de données et différentes échelles biologiques. | Que les prédictions soient exactes dans un nouveau contexte ou qu’elles établissent une causalité. |
| Système interactif | Relier le modèle aux outils, à la littérature et aux processus de recherche. | Que tous les outils soient intégrés de manière exhaustive ou que le processus soit supérieur aux solutions de remplacement. |
| Expériences | Tester des candidats et produire des mesures susceptibles d’orienter le cycle suivant. | Que les résultats communiqués soient généralisables à d’autres laboratoires, organismes ou patients. |
Du calcul à l’expérience : l’exemple du cancer du pancréas
Microsoft Research décrit un cas de recherche sur l’adénocarcinome canalaire pancréatique, une forme de cancer du pancréas. En collaboration avec des chercheurs du Broad Institute de Harvard et du MIT, l’équipe a étudié la possibilité que l’état cellulaire, en plus de la génétique, soit lié à la réponse des tumeurs aux médicaments. Selon la publication, Quine a servi à hiérarchiser des milliers de composés en fonction de leur capacité potentielle à faire passer les cellules tumorales d’un état à un autre, ces états étant considérés comme pertinents pour le traitement.
L’équipe indique que les composés les mieux classés ont produit les changements recherchés les plus importants lors d’essais en laboratoire portant sur la transition d’un état cellulaire dit « classique » à un état dit « basal ». Elle fait aussi état d’effets plus faibles dans le sens inverse et rapporte que certains composés étaient associés à un troisième phénotype, ce qui aurait correspondu à une prédiction du système. Ces résultats sont rapportés par les auteurs du projet ; les informations disponibles n’établissent pas de réplication indépendante et ne permettent pas de conclure que ces composés constituent des traitements efficaces.
Microsoft Research affirme que la première phase de hiérarchisation a été menée en un week-end et que le processus pourrait faire économiser des mois de travail expérimental. Cette durée concerne le processus de sélection décrit ; elle ne signifie pas que l’ensemble du cycle de recherche, de validation et de développement d’un traitement a été ramené à ce délai. La publication présente ce cas comme une première illustration de la façon dont le système peut réduire le nombre de candidats avant le travail en laboratoire, et non comme une preuve clinique.
Cet exemple illustre un soutien à la décision expérimentale : choisir quels candidats soumettre à des essais. La question n’est pas seulement de savoir si le modèle produit une liste, mais aussi comment les candidats se comportent lorsqu’ils sont testés et si cette sélection améliore les résultats de façon reproductible par rapport à un référentiel clairement défini. La description publique présente des résultats prometteurs attribués à l’équipe, mais ne fournit pas à elle seule l’ensemble des mesures, des comparateurs et des données nécessaires à une évaluation indépendante.
Que signifie le fait que le projet soit encore à un stade précoce ?
La présentation qualifie Quine de projet de recherche à un stade précoce. L’accès initial doit être limité au programme Quine Fellows et à des collaborations de recherche sélectionnées. Microsoft indique espérer élargir l’accès à mesure que la technologie mûrit, mais il s’agit d’une perspective future, et non de la confirmation d’une disponibilité générale.
Ce stade précoce invite aussi à nuancer l’interprétation de la conception. L’équipe reconnaît que le modèle ne représentera pas parfaitement la biologie et vise plutôt une utilité suffisante pour orienter la conception des expériences. Cette ambition ne garantit pas la précision : chaque prédiction peut dépendre du type et de la qualité des données, du système biologique étudié et des conditions expérimentales.
La réserve concernant l’usage est explicite : Quine est une technologie expérimentale destinée à la recherche, et non à un usage clinique ou médical. Ses résultats peuvent être incomplets ou inexacts et doivent être examinés par des chercheurs qualifiés, puis validés par des méthodes scientifiques et expérimentales adaptées. Cette limite exclut de présenter le système comme un outil de décision en matière de diagnostic, de traitement ou de prise en charge clinique.
Comment interpréter une prédiction de Quine
- 01Formuler une question biologique précise et définir les observations susceptibles d’y répondre.
- 02Utiliser le système pour générer ou hiérarchiser des hypothèses, tout en explicitant ses limites.
- 03Concevoir des essais permettant de vérifier les prédictions avec des contrôles appropriés.
- 04Mesurer les résultats et examiner s’ils étayent, contredisent ou modifient l’hypothèse.
- 05Répéter et confronter les résultats avant d’affirmer qu’ils sont généralisables.
Ce qu’il reste à établir pour évaluer son utilité scientifique
La description publique consultée ne comprend pas d’article technique indépendant exposant tous les détails de l’architecture, de l’entraînement et de l’évaluation. Elle énumère les modalités et l’objectif général du système, mais plusieurs questions restent ouvertes : quelles données ont été utilisées, comment elles ont été harmonisées, quels contrôles de qualité ont été appliqués et quelles parties du processus produisent chaque prédiction. Sans ces détails, il est difficile de reproduire le travail ou de déterminer quel composant explique les résultats.
Il faudrait également savoir précisément comment la sélection opérée par Quine a été comparée à des méthodes de référence : sélection aléatoire, modèles spécialisés, méthodes informatiques existantes ou critères d’experts. Pour mesurer un éventuel progrès, il serait utile de disposer de métriques définies avant les essais, de tailles d’échantillon, de contrôles, d’une estimation de l’incertitude statistique et de résultats portant aussi sur les candidats qui n’ont pas fonctionné, et pas seulement sur les exemples mis en avant.
La généralisation constitue une autre question ouverte. Un résultat obtenu sur des lignées cellulaires dans un contexte expérimental donné n’établit pas à lui seul que le système fonctionnera pour d’autres cancers, organismes, laboratoires ou conditions. Des évaluations prospectives et des réplications indépendantes seraient utiles, avec une distinction claire entre les données utilisées pour entraîner le système ou sélectionner les candidats et celles utilisées pour vérifier ses performances.
À ce stade, la conclusion la mieux étayée reste circonscrite : Quine propose une stratégie pour relier des données biologiques et hiérarchiser des hypothèses, et Microsoft Research rapporte des essais préliminaires de sélection de composés pour le cancer du pancréas. Les informations publiques disponibles ne suffisent pas à mesurer de façon indépendante son avantage par rapport aux solutions de remplacement, sa capacité de généralisation ou son éventuel bénéfice clinique. Ces questions nécessitent une documentation technique et des validations supplémentaires.
Questions en suspens et éléments de preuve utiles
| Question | Éléments permettant de l’évaluer |
|---|---|
| Quine surpasse-t-il les méthodes existantes ? | Des comparaisons prospectives avec des références clairement définies et des métriques publiées. |
| Les résultats sont-ils reproductibles ? | Des protocoles, des données et des réplications indépendantes dans différents laboratoires. |
| Le système se généralise-t-il à d’autres contextes ? | Des essais sur des systèmes biologiques, des organismes et des types d’expériences qui n’ont pas servi au développement du système. |
| Quel degré d’incertitude entourent les prédictions ? | Des estimations calibrées, des analyses d’erreurs et des résultats complets, y compris les résultats négatifs. |
| Les résultats ont-ils une pertinence clinique ? | Des preuves cliniques adaptées ; les essais sur cellules décrits ne suffisent pas à l’établir. |
Conclusion : orienter la science, sans la remplacer
Quine cherche à répondre à une difficulté réelle de la recherche biologique : mettre en relation des données de natures et de niveaux différents pour explorer davantage d’hypothèses qu’il ne serait pratique d’en tester directement. L’association d’un modèle multimodal et d’un système d’outils vise à établir un cycle entre prédictions, décisions expérimentales et nouvelles mesures.
Le cas du cancer du pancréas constitue une première application décrite par l’équipe, avec des candidats hiérarchisés et des résultats de laboratoire communiqués par Microsoft Research. Mais le projet reste à un stade précoce et les informations disponibles ne démontrent ni un avantage général par rapport aux méthodes de référence ni une application clinique. Son évaluation dépendra de données reproductibles, de comparaisons transparentes et d’une validation indépendante.
Pour le lecteur, la distinction essentielle est celle entre une capacité envisagée et une utilité démontrée. Quine peut aider à choisir les hypothèses à examiner ; les expériences, la réplication et l’examen scientifique déterminent quelles conclusions peuvent être défendues.
Questions ouvertes
- Aucun article technique distinct exposant l’ensemble des détails de l’architecture, de l’entraînement et de l’évaluation n’a été vérifié.
- Les résultats de laboratoire sur les composés et les états cellulaires proviennent de la description de l’équipe du projet ; aucune réplication indépendante n’est établie ici.
- Aucune comparaison publique complète avec des méthodes informatiques, une sélection par des experts ou d’autres références n’est disponible.
- La généralisation à d’autres cancers, organismes, échelles biologiques ou laboratoires n’est pas établie par le cas décrit.
- La durée d’un week-end concerne le processus de hiérarchisation rapporté et ne démontre pas que l’ensemble du processus scientifique ou thérapeutique ait été ramené à ce délai.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction