Ce qu’Agent Lightning change
Microsoft Research présente Agent Lightning v1.0 comme un cadre permettant d’entraîner des agents d’intelligence artificielle par apprentissage par renforcement, sans devoir reconstruire leur logique dans le système d’entraînement. L’idée consiste à conserver l’agent qui exécute déjà les tâches — avec ses étapes, ses outils et sa gestion du contexte — puis à le relier à l’infrastructure d’entraînement au moyen d’un proxy pour les appels au modèle.
Le projet cherche à résoudre un problème fréquent de séparation entre développement et entraînement : les cadres d’agents orchestrent les interactions avec les outils et les autres agents, tandis que les systèmes d’apprentissage par renforcement optimisent le modèle. Lorsqu’il faut réimplémenter l’agent pour l’entraîner, cette version peut se comporter autrement que celle utilisée en production. Agent Lightning vise à faire en sorte que l’entraînement observe le comportement de l’agent dans son propre flux d’exécution.
La version 1.0 constitue une refonte du projet par rapport aux versions précédentes. Le dépôt la décrit comme une implémentation légère et publie le code sous licence MIT. Le chiffre d’environ 3 500 lignes, comme les avantages attribués à cette simplicité, sont des données avancées par l’équipe du projet. Il ne s’agit pas d’une mesure indépendante de la facilité d’utilisation ni du coût total d’adoption.
Comment le système relie agents et entraînement
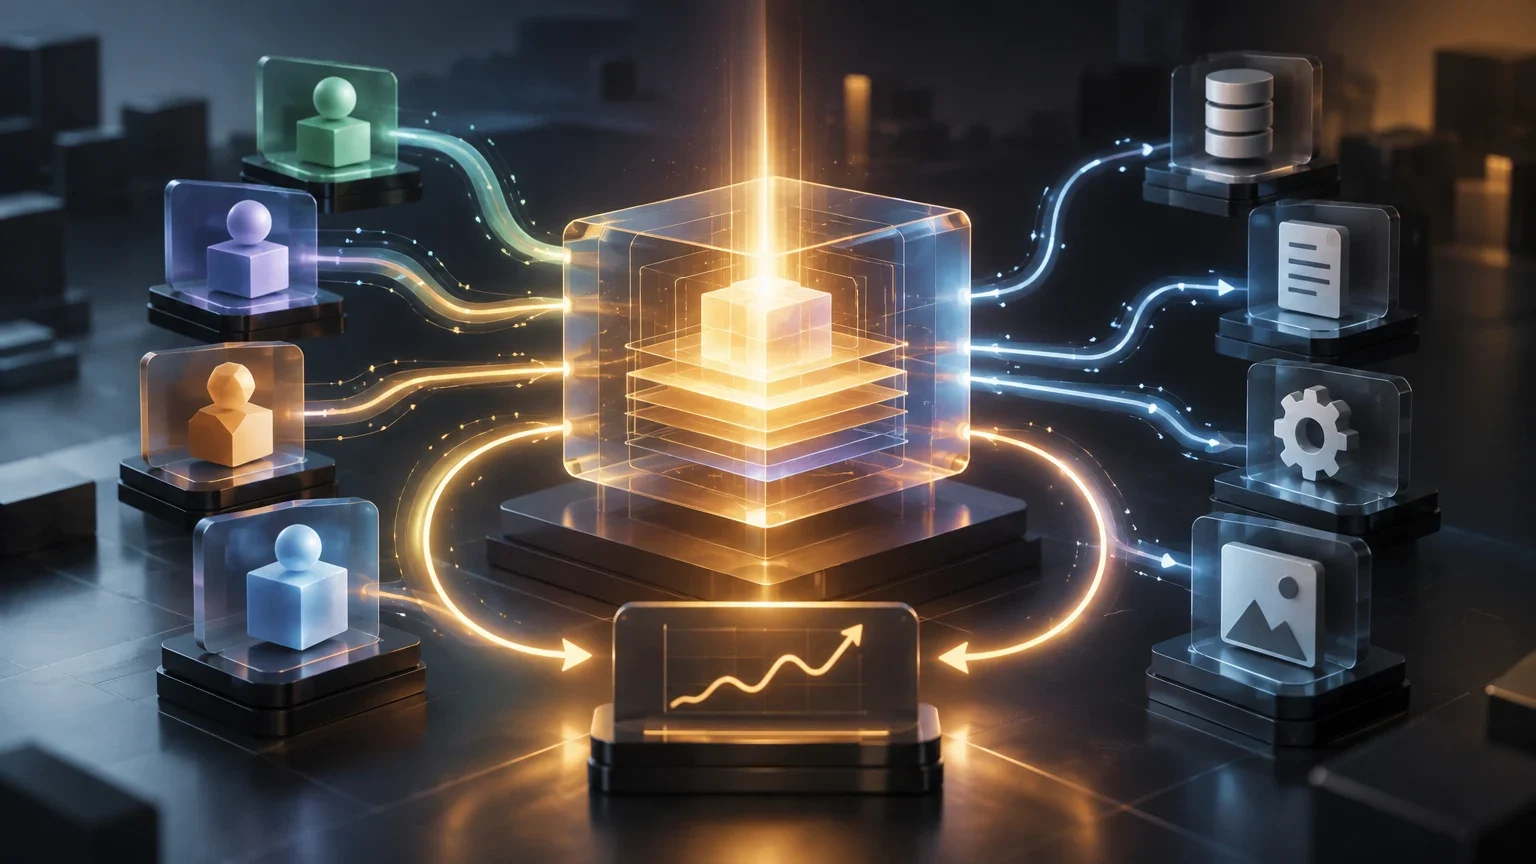
Dans l’architecture décrite, un serveur et un client Agent Lightning font l’intermédiaire entre l’agent et le système d’entraînement. Pour la version 1.0, le dépôt présente trois composants principaux : un entraîneur basé sur verl, une passerelle API qui sert de proxy compatible avec l’API OpenAI et collecte les données, ainsi qu’un contrôleur d’exécution qui lance les agents localement ou sous forme de tâches Kubernetes.
L’agent envoie ses requêtes au modèle par l’intermédiaire de la passerelle. Celle-ci associe les appels à l’exécution correspondante et consigne les informations nécessaires à la constitution des données d’entraînement, notamment les requêtes, les réponses et les probabilités associées à la génération. Le contrôleur gère l’exécution de l’agent, tandis que l’entraîneur organise les échantillons et met à jour la politique du modèle. Cette séparation permet de faire évoluer la logique de l’agent et celle de l’entraînement comme des composants distincts.
Le flux décrit part de tâches et d’exécutions de l’agent. Pendant celles-ci, le système collecte des interactions, des erreurs et des signaux de récompense, qui peuvent être configurés pour refléter la réussite ou l’échec d’une tâche. Les traces sont ensuite converties en données utilisables par le système d’entraînement. Microsoft Research décrit l’emploi d’algorithmes d’apprentissage par renforcement, dont GRPO dans le flux fondé sur verl ; cela ne signifie pas que tous les algorithmes ou toutes les configurations soient intégrés par défaut.
Le projet déclare actuellement prendre en charge OpenAI Agents SDK, LangChain et AutoGen. Cette liste correspond à la compatibilité documentée par le projet lui-même ; elle ne garantit pas que tout agent construit avec ces cadres puisse être connecté sans adaptation. Le changement de point de terminaison, la gestion des identifiants, le format des appels et les dépendances de l’agent peuvent nécessiter un travail d’intégration.
Flux d’entraînement décrit
- 01Le contrôleur lance une tâche et exécute l’agent selon son flux habituel.
- 02L’agent transmet ses requêtes au modèle par la passerelle Agent Lightning.
- 03La passerelle consigne les interactions et les signaux configurés ; le système organise les traces sous forme d’échantillons d’entraînement.
- 04L’entraîneur met à jour le modèle, puis l’agent peut être exécuté à nouveau avec la politique actualisée.
Ce que signifie entraîner l’agent avec son harnais réel
Le harnais est la couche qui orchestre le comportement de l’agent autour du modèle. Il peut gérer le contexte, l’historique, la mémoire, les outils, l’ordre des étapes et les interactions avec d’autres agents ou avec un environnement. Agent Lightning propose de faire participer ce même harnais à l’entraînement, au lieu de le remplacer par une boucle simplifiée entièrement contrôlée par le système d’apprentissage par renforcement.
En pratique, les requêtes que l’agent envoie déjà au modèle passent par le proxy. L’agent peut ainsi conserver ses outils, sa logique de contrôle et ses environnements pendant que les interactions pertinentes sont collectées pour l’entraînement. Microsoft Research affirme que cette conception évite de modifier le code de l’agent dans les cas couverts par son architecture ; le dépôt promet lui aussi une exécution sans aucune modification. Ce sont des descriptions de la conception, et non la preuve que toutes les intégrations réelles se font littéralement sans changement.
Le maintien du harnais entraîne également des difficultés techniques. Une même tâche peut produire plusieurs appels au modèle, chacun susceptible de devenir un échantillon distinct. L’agent conserve son contexte sous forme de texte, tandis que l’entraînement peut avoir besoin des identifiants des jetons générés à l’origine. Une nouvelle tokenisation du texte peut déplacer les frontières entre jetons ; en outre, le résumé du contexte ou la délégation à des sous-agents peut découper une trajectoire de différentes façons. L’équipe relève aussi des difficultés liées au calcul des avantages, à la normalisation de la perte par trajectoire et à l’adaptation de charges variables à des ressources GPU définies à l’avance.
La version 1.0 décrit un mode d’entraînement asynchrone qui partage les ressources : le système collecte des exécutions, suspend temporairement l’arrivée de nouvelles requêtes le temps de terminer celles déjà en cours, met le modèle à jour, puis reprend les exécutions. Microsoft Research fait état d’une accélération d’environ deux fois par rapport à une configuration synchrone dans ses expériences. Ce résultat correspond aux conditions testées par l’équipe ; il ne permet pas de prévoir les performances avec n’importe quel agent, matériel ou charge de travail.
Code disponible, compatibilité et mise en route
Le dépôt officiel publie Agent Lightning v1.0 sous licence MIT et propose de la documentation, des exemples et des scripts. Les exemples répertoriés couvrent notamment des tâches mathématiques avec AutoGen et des outils MCP, GSM8K, ScienceWorld, la recherche et le raisonnement, l’exécution de code dans un environnement isolé et un agent de programmation. L’existence d’un exemple documenté ne signifie pas que le projet garantisse la prise en charge de toutes les configurations de cet environnement.
La procédure de référence indiquée par le dépôt utilise une machine équipée de CUDA 13.0, synchronise les dépendances avec uv et exécute un script de configuration de verl pour les versions et la variante CUDA spécifiées. Il ne faut donc pas l’interpréter comme une installation universelle ni comme la preuve que le flux complet fonctionnera sur un ordinateur dépourvu de GPU compatible. Avant de reproduire les résultats, il convient de vérifier la version en vigueur du guide d’installation, les versions des dépendances, la disponibilité des accélérateurs et les exigences propres à chaque exemple.
La possibilité d’exécuter les agents sous forme de tâches Kubernetes standard est mise en avant dans la version 1.0. Une exécution locale est également prévue. Kubernetes permet d’utiliser une infrastructure autogérée ou des services compatibles, mais exige de gérer le cluster, les ressources, les images et la sécurité des tâches. L’affirmation selon laquelle cette option évite de dépendre de services commerciaux de sandbox décrit une possibilité architecturale ; elle ne signifie pas que l’exécution d’entraînements à grande échelle soit dépourvue de coûts opérationnels.
Le chiffre d’environ 3 500 lignes apparaît dans la description du projet et dans la communication institutionnelle. Les éléments disponibles ne fournissent pas de méthode de comptage indépendante — par exemple, quels répertoires, fichiers générés ou dépendances sont inclus. Il convient donc de considérer ce chiffre comme une approximation donnée par l’équipe, et non comme une comparaison objective de la complexité des différents cadres.
Points à vérifier avant de choisir une configuration
| Besoin | Éléments documentés | À vérifier en pratique |
|---|---|---|
| Connecter un agent existant | Proxy compatible avec l’API OpenAI ; compatibilité déclarée avec OpenAI Agents SDK, LangChain et AutoGen. | Point de terminaison, authentification, format des appels, dépendances et modifications nécessaires à l’agent. |
| Entraîner avec verl | L’entraîneur de la version 1.0 repose sur verl et le projet décrit des flux utilisant des algorithmes d’apprentissage par renforcement. | Versions compatibles, algorithme choisi, configuration GPU et définition des récompenses. |
| Exécuter sur Kubernetes | Le contrôleur peut lancer les agents comme des tâches Kubernetes standard. | Autorisations, ressources par tâche, gestion des images, isolation et coût du cluster. |
| Tester localement | Le dépôt inclut des exemples et une procédure d’installation pour CUDA 13.0. | Compatibilité du matériel, versions logicielles et exigences propres à chaque exemple. |
Résultats publiés et éléments qui restent à vérifier
Microsoft Research présente un exemple de programmation fondé sur Qwen3.5-9B, mini-SWE-agent et SWE-smith. L’équipe indique qu’après un entraînement par renforcement sur environ 6 000 échantillons, le résultat sur SWE-bench Verified est passé de 41,8 % à 56,4 % en Pass@1, soit une hausse de 14,6 points de pourcentage. Ce chiffre décrit cette expérience et cette configuration ; il ne démontre pas qu’Agent Lightning produira la même amélioration avec d’autres modèles, agents ou ensembles de tâches.
Le dépôt signale également un exemple ultérieur avec Qwen3.5-35B-A3B : le score sur SWE-bench Verified serait passé de 47,8 % à 61,6 % après un entraînement sur 1 800 exemples, selon le projet. Ces résultats sont communiqués par les auteurs du système et doivent leur être attribués comme tels. Les sources disponibles n’incluent ni évaluation indépendante reproduisant ces chiffres ni comparaison contrôlée isolant la contribution du cadre par rapport aux autres facteurs de l’entraînement.
Pour évaluer l’utilité générale, il faudrait des reproductions suffisamment détaillées concernant les versions, les données, le budget de calcul, la configuration du modèle, les récompenses et le protocole d’évaluation ; des comparaisons avec des agents non entraînés et d’autres méthodes ; ainsi que des tests sur un plus grand nombre de tâches et d’environnements. Il serait également utile de mesurer le coût et le temps d’intégration, la stabilité d’une exécution à l’autre, les défaillances de l’agent et sa sensibilité à des récompenses incorrectes. Les documents du projet reconnaissent eux-mêmes des difficultés telles que l’attribution du crédit entre les étapes et le traitement de trajectoires de longueurs différentes.
La conclusion vérifiable est plus limitée qu’une promesse d’amélioration universelle : Agent Lightning v1.0 propose une architecture ouverte visant à relier des agents existants à l’apprentissage par renforcement tout en conservant leur harnais, et publie des exemples ainsi que des résultats propres au projet. La réduction du travail d’intégration ou l’amélioration d’un agent donné doit être évaluée au cas par cas, avec une référence initiale et des conditions documentées.
Critères pratiques pour une première évaluation
Un test utile commence par une tâche bien délimitée et un agent qui fonctionne déjà avec son harnais habituel. Il est préférable de définir avant l’entraînement une mesure de réussite, une référence sans entraînement et un ensemble d’évaluation distinct des données utilisées pour l’optimisation. Si la récompense repose sur des tests automatisés, il faut vérifier qu’ils mesurent le résultat souhaité et qu’ils ne peuvent pas être réussis par des raccourcis.
On peut ensuite mesurer le coût de connexion de l’agent au proxy, les modifications nécessaires et la capacité des traces à saisir les décisions pertinentes. Il faut également consigner les erreurs d’exécution, la consommation de GPU et de CPU, la durée des itérations et la stabilité des améliorations. Un résultat qui n’apparaît que sur les exemples d’entraînement ou qui dépend d’une configuration fragile nécessite des vérifications supplémentaires.
La licence MIT facilite l’examen et l’adaptation du code, mais ne remplace pas l’analyse de la sécurité, des dépendances ni des conditions applicables aux modèles et aux données utilisés. La décision d’adopter le cadre doit reposer sur la compatibilité concrète, la capacité à exploiter l’infrastructure et une comparaison reproductible — et non uniquement sur le nombre de lignes ou sur les améliorations publiées par l’équipe.
Liste de vérifications rapide
- 01Choisir un agent et une tâche disposant déjà d’une référence reproductible.
- 02Vérifier la compatibilité du point de terminaison, des dépendances, du matériel et du mode d’exécution.
- 03Définir les récompenses et une évaluation distincte avant de commencer l’entraînement.
- 04Consigner les modifications d’intégration, les coûts, les erreurs et les résultats de plusieurs exécutions.
- 05Comparer avec d’autres solutions et présenter comme provisoires les améliorations qui n’ont pas été reproduites de manière indépendante.
Questions ouvertes
- Le chiffre d’environ 3 500 lignes est une approximation avancée par le projet ; aucune méthode de comptage indépendante n’est précisée.
- Les résultats sur SWE-bench Verified sont des résultats expérimentaux communiqués par Microsoft Research et le dépôt ; les sources disponibles ne comprennent pas de reproduction indépendante.
- La compatibilité annoncée avec certains cadres ne garantit pas une intégration sans modification de tous les agents ni de toutes leurs versions.
- La procédure d’installation de référence repose sur CUDA 13.0 et une configuration précise de verl ; les exigences peuvent varier selon le matériel, les dépendances et les exemples.
- L’accélération d’environ deux fois par rapport à l’entraînement synchrone correspond aux conditions expérimentales communiquées ; elle ne permet pas de déduire les performances pour d’autres charges de travail.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction