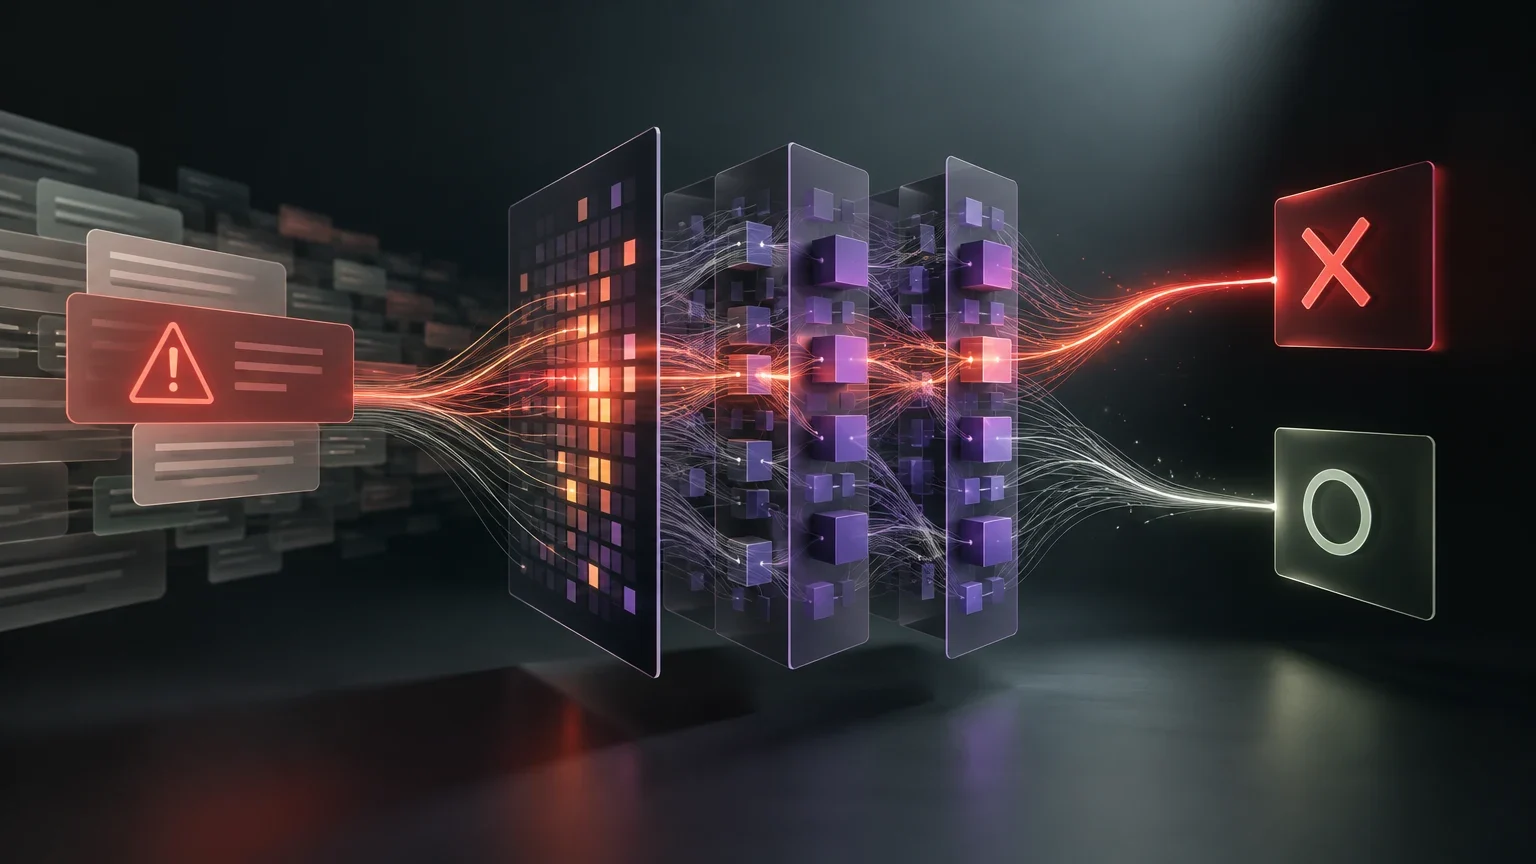
Distinguer la détection du danger de la production du refus
Les modèles de langage conçus pour respecter des objectifs de sécurité restent vulnérables aux jailbreaks et peuvent aussi refuser à tort des demandes bénignes. Pour comprendre ces défaillances, il faut distinguer la reconnaissance du caractère dangereux d’une demande du calcul qui produit la réponse de refus.
Les auteurs reformulent le problème comme une question de cheminement interne au modèle. Ils proposent de mesurer ce processus à partir des mises à jour du flux résiduel de Transformers à décodeur seul. Leur méthode sépare l’information sur le caractère nuisible qu’une mise à jour de module rend accessible du changement qu’elle apporte aux indices de refus lisibles dans le modèle.
Signaux internes : attention et couches MLP
L’analyse porte sur les mises à jour produites par les mécanismes d’attention et par les couches de perceptron multicouche, ou MLP. Les résultats indiquent que l’information relative au caractère nuisible d’une demande se décode plus facilement à partir des mises à jour de l’attention, en particulier dans les premières couches du modèle.
Les mises à jour des MLP contribuent davantage à la production sélective de refus dans les modèles alignés. Les résultats suggèrent donc une répartition des rôles : l’attention repère des éléments associés au danger, tandis que les MLP participent davantage à la formulation de la réponse de sécurité. Cette interprétation décrit les tendances observées dans les mesures des auteurs ; elle ne signifie pas que chaque module aurait un rôle exclusif.
Rôle des modules dans le cheminement de sécurité
Comparaison des fonctions associées à l’attention et aux couches MLP dans l’étude.
| Module | Fonction principalement observée | Emplacement associé dans les résultats |
|---|---|---|
| Attention | Décodage de l’information relative au caractère nuisible | Plus particulièrement dans les premières couches |
| MLP | Contribution à la production sélective de refus | Contribution plus concentrée dans les couches profondes après l’entraînement ultérieur |
Une étude portant sur 18 paires de modèles
Les auteurs évaluent 18 paires de modèles Base-Instruct issues des familles Qwen, Llama et Gemma. Cette comparaison permet d’examiner des tendances communes dans plusieurs modèles à décodeur seul, plutôt que de s’appuyer sur un seul modèle ou une seule famille.
Dans les 18 paires, l’entraînement ultérieur renforce la production de refus par les MLP, sans améliorer systématiquement la possibilité de décoder l’information sur le caractère nuisible. Après cet entraînement, les contributions positives des MLP à l’écriture du refus sont également plus concentrées dans les couches profondes. Le résumé de l’article ne suffit toutefois pas à établir ici tous les détails sur les versions exactes des modèles et la construction des jeux d’évaluation.
Interventions causales et méthode Sentinel
Les auteurs rapportent également des interventions qui étayent le cheminement proposé. Lorsqu’ils rétablissent les mises à jour des MLP en aval à leurs valeurs observées dans la situation de référence sans intervention, le déplacement de la réponse vers le refus, provoqué par des interventions en amont sur l’attention, diminue sensiblement. Ce résultat soutient l’idée que les MLP en aval contribuent à la transmission de l’effet des interventions sur l’attention ; il ne démontre pas que ces modules seraient les seuls responsables de tout refus.
À partir de ces observations, les auteurs présentent Sentinel. La méthode combine un score de perception P, dérivé de l’attention, et un score de décision D, dérivé des MLP. Selon le résumé du travail, un routage conditionnel fondé sur les deux signaux obtient une erreur agrégée inférieure à celle du routage à signal unique et des rappels fixes évalués, sur huit modèles.
Les étapes du principe de Sentinel
Le dispositif décrit dans le résumé associe des signaux issus de l’attention et des MLP pour guider le routage. Les détails d’implémentation ne sont pas précisés ici.
- 01Extraire des mises à jour de l’attention le score de perception P.
- 02Extraire des mises à jour des MLP le score de décision D.
- 03Évaluer le profil conjoint des deux scores pour appliquer un routage conditionnel.
- 04Comparer l’erreur agrégée aux approches à signal unique et aux rappels fixes évalués.
Ce que les résultats montrent — et ce qu’ils ne permettent pas de conclure
Dans six modèles capables de raisonnement, les auteurs indiquent que l’information sur le caractère nuisible reste décodable pendant le raisonnement, tandis que la production marquée de refus se concentre au début de la réponse. Ils rapportent que ce schéma persiste lorsque le raisonnement est désactivé. Le résumé ne permet pas, à lui seul, de déterminer dans quelle mesure ce résultat se généralise à d’autres modèles, prompts ou configurations.
Le travail est présenté comme un préprint déposé sur arXiv le 9 octobre 2026. Les éléments disponibles ne confirment ni une évaluation par les pairs ni une réplication indépendante. Surtout, ces résultats ne montrent pas que les jailbreaks sont résolus : ils proposent une façon d’analyser certains mécanismes internes associés à la détection du danger et à la production des refus. La robustesse face aux jailbreaks, aux demandes bénignes ambiguës et aux variations de prompt, ainsi que la reproductibilité complète des mesures, ne peuvent pas être établies à partir du seul résumé.
Questions ouvertes
- Les éléments disponibles ne confirment pas que le travail ait été évalué par les pairs ni reproduit indépendamment.
- Le résumé ne suffit pas à vérifier la robustesse des résultats face aux jailbreaks, aux demandes bénignes ambiguës ou aux variations de prompt.
- Les versions exactes des 18 paires, la construction des jeux d’évaluation et les contrôles ne sont pas détaillés dans les éléments disponibles.
- La reproductibilité complète des mesures ne peut pas être vérifiée à partir du résumé seul.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction