Una guida metodologica per distinguere la robustezza sperimentale dalla generalizzazione e dalla riproducibilità, ricostruire le condizioni messe alla prova e formulare conclusioni proporzionate alle evidenze osservate nella ricerca sull’intelligenza artificiale.
Analisi metodologica della metrica Content nel benchmark AesCode: il suo ruolo nella valutazione della fedeltà semantica delle infografiche generate come codice, l’integrazione con le altre dimensioni visive e i limiti che ostacolano il confronto con benchmark differenti.
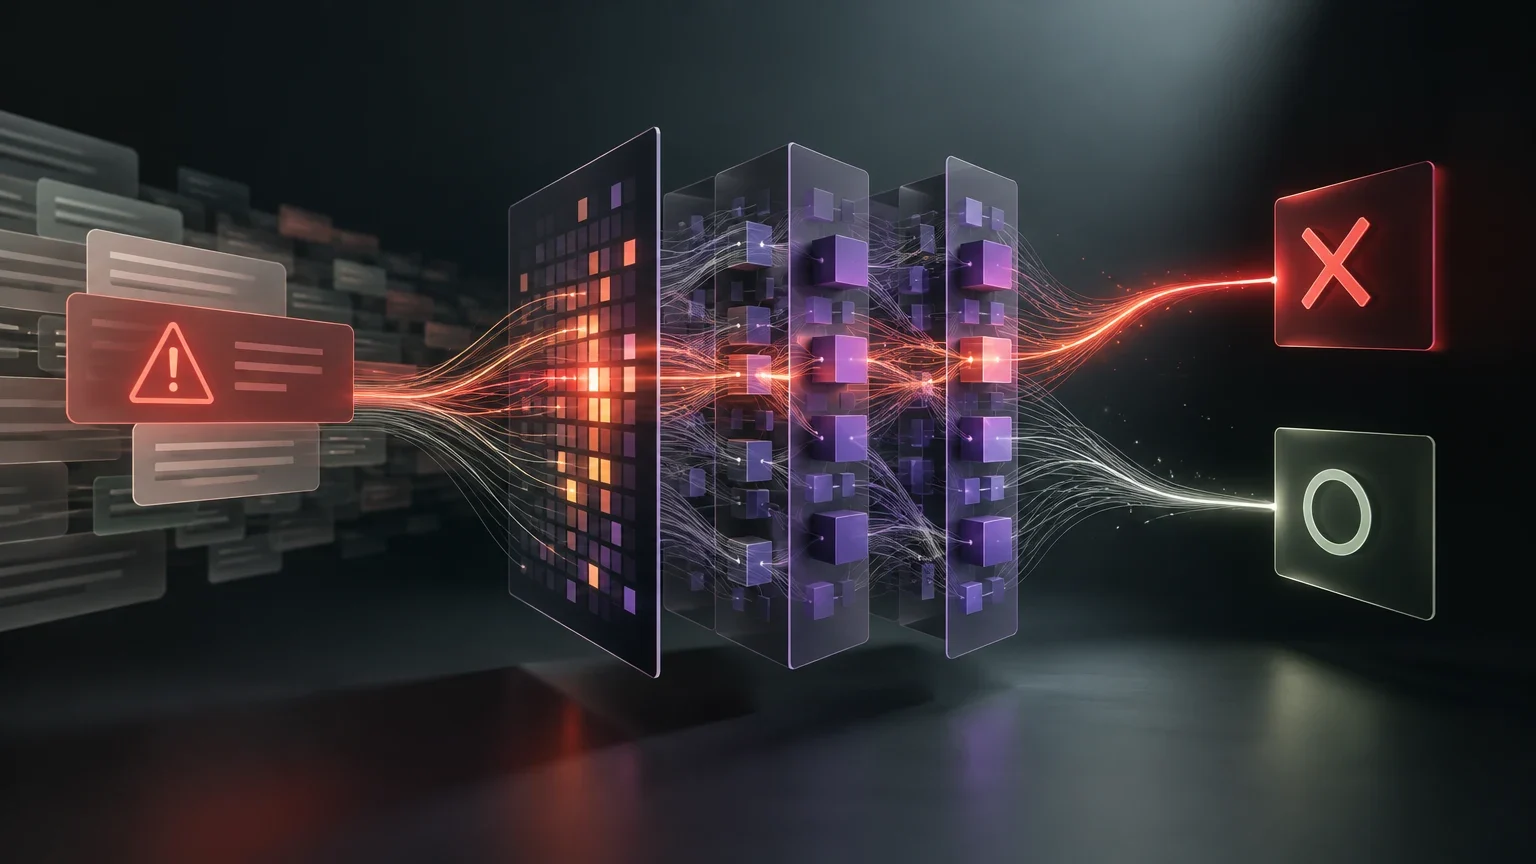
Uno studio di interpretabilità traccia come l'attenzione e gli strati MLP intervengano nel rilevamento delle richieste dannose e nel segnale di rifiuto dei modelli linguistici.
Un nuovo preprint presenta un benchmark di 20 task progettato per misurare la capacità degli agenti di programmazione di risolvere guasti in applicazioni deployate, superando i limiti dei repository di prova tradizionali.
Un preprint presenta un metodo che collega un codificatore vocale a un LLM congelato per rispondere a domande chiuse tramite distribuzioni su opzioni, riducendo la latenza negli agenti vocali in tempo reale.
A Muse Spark Open vengono attribuiti 816 miliardi di parametri, 42 miliardi attivi e una finestra di contesto da un milione di token. Tuttavia, la documentazione primaria di Meta fornita non conferma questa variante né un’ottimizzazione ufficiale per Apple Silicon; non consente neppure di verificare requisiti o prestazioni in locale.
Nemotron 3.5 Super VL è progettato per interpretare documenti, grafici, immagini e video e supportare attività prolungate con strumenti. Le informazioni disponibili confermano il lancio e la scala del modello, ma non bastano per stabilire le sue prestazioni indipendenti né quanta hardware NVIDIA richieda ogni implementazione.
Un lavoro sperimentale descrive un metodo per stabilizzare i Transformer in loop e misurarne le prestazioni. Non dimostra che OpenAI lo utilizzi nel suo prossimo modello né consente di concludere che questa architettura renda più difficile la supervisione della sicurezza.
Una guida per collegare un modello a uno strumento interno senza dargli autorità diretta sui dati: definisci un’interfaccia circoscritta, valida ogni proposta nel codice e distribuisci la funzione con controlli e possibilità di rollback.
Un’analisi dell’accordo tra Aleph Alpha e Cohere: fatti confermati, possibili effetti sull’offerta di modelli sovrani, implicazioni normative e una checklist per verificare licenze e modalità di accesso.
Prima di investire in IA, definisci quale decisione vuoi migliorare, quali dati hai e quali sarebbero le conseguenze di un errore. Questo quadro ordina quattro possibili percorsi e mostra cosa si può concludere — e cosa no — con le prove disponibili.