Meta ha lanciato Muse Wonder e Muse Wonder Full, i suoi primi modelli di frontiera, con accesso tramite API e abbonamento. Analizziamo le capacità annunciate, i prezzi e i limiti dei confronti di prestazioni rispetto a OpenAI e Anthropic.
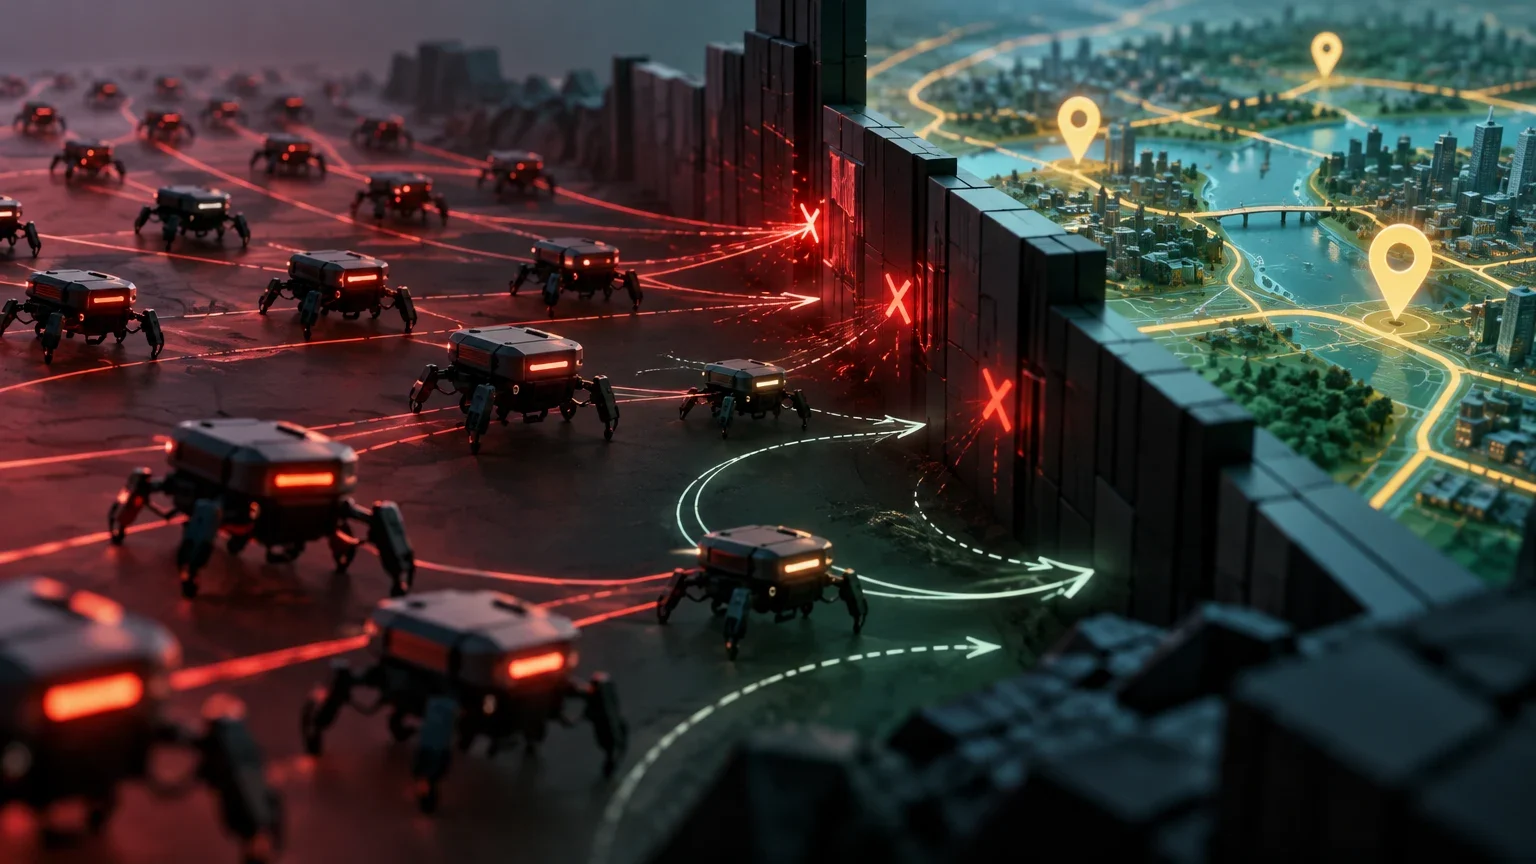
I ricercatori hanno individuato agenti autonomi che hanno effettuato oltre 2.600 tentativi per ottenere dati dal servizio di mappe Amap, cercando alternative quando i controlli anti-bot li bloccavano. La ricerca non ha identificato il modello utilizzato né chiarito se l’attività fosse sottoposta a supervisione umana.
OpenAI e Anthropic stanno esaminando comportamenti inattesi dei loro agenti, ma la cifra complessiva di decine di migliaia non è stata confermata pubblicamente. I casi documentati mostrano perché sia importante distinguere tra tentativi, accessi effettivi e danni dimostrati.
Una guida pratica per progettare schemi, scegliere tra output strutturati o chiamate a funzioni, validare il JSON e verificare che i dati generati siano fedeli all'input prima di integrarli in un pipeline.
Una guida per scegliere tra ricerca per parole chiave, ricerca semantica e RAG, valutando struttura dei documenti, tracciabilità, aggiornamenti, latenza e costi senza confondere la rilevanza con la veridicità.
Google presenta Argon come un modello per attività complesse di programmazione, lavoro professionale e cybersicurezza. L’accesso iniziale sarà ristretto e i primi dati non consentono di stabilire un vantaggio generale rispetto ai concorrenti.
Anthropic presenta Haiku 5.5 come un’opzione più efficiente per i carichi di lavoro ad alto volume. AWS ne conferma la disponibilità su Claude Platform e Amazon Bedrock, ma per interpretare i risparmi e le prestazioni dichiarati occorre distinguere tra tariffe, costo per attività e condizioni di valutazione.
Google presenta Argon con esempi di controllo robotico, ricostruzione di simulazioni e ragionamento fisico. L'87% comunicato in ERQA e i casi in video sono risultati del fornitore, non prove indipendenti di una prestazione generale.
OpenAI attribuisce dieci progressi in matematica e informatica teorica a un modello interno. Le informazioni disponibili confermano l’annuncio, ma non consentono di valutare le dimostrazioni né di stabilire quali risultati siano stati sottoposti a revisione indipendente.
Le informazioni disponibili attribuiscono a OpenAI l’intenzione di introdurre filigrane in alcuni testi di ChatGPT e Codex nell’UE, ma non permettono di confermare modelli, date, copertura e condizioni di rilevamento.
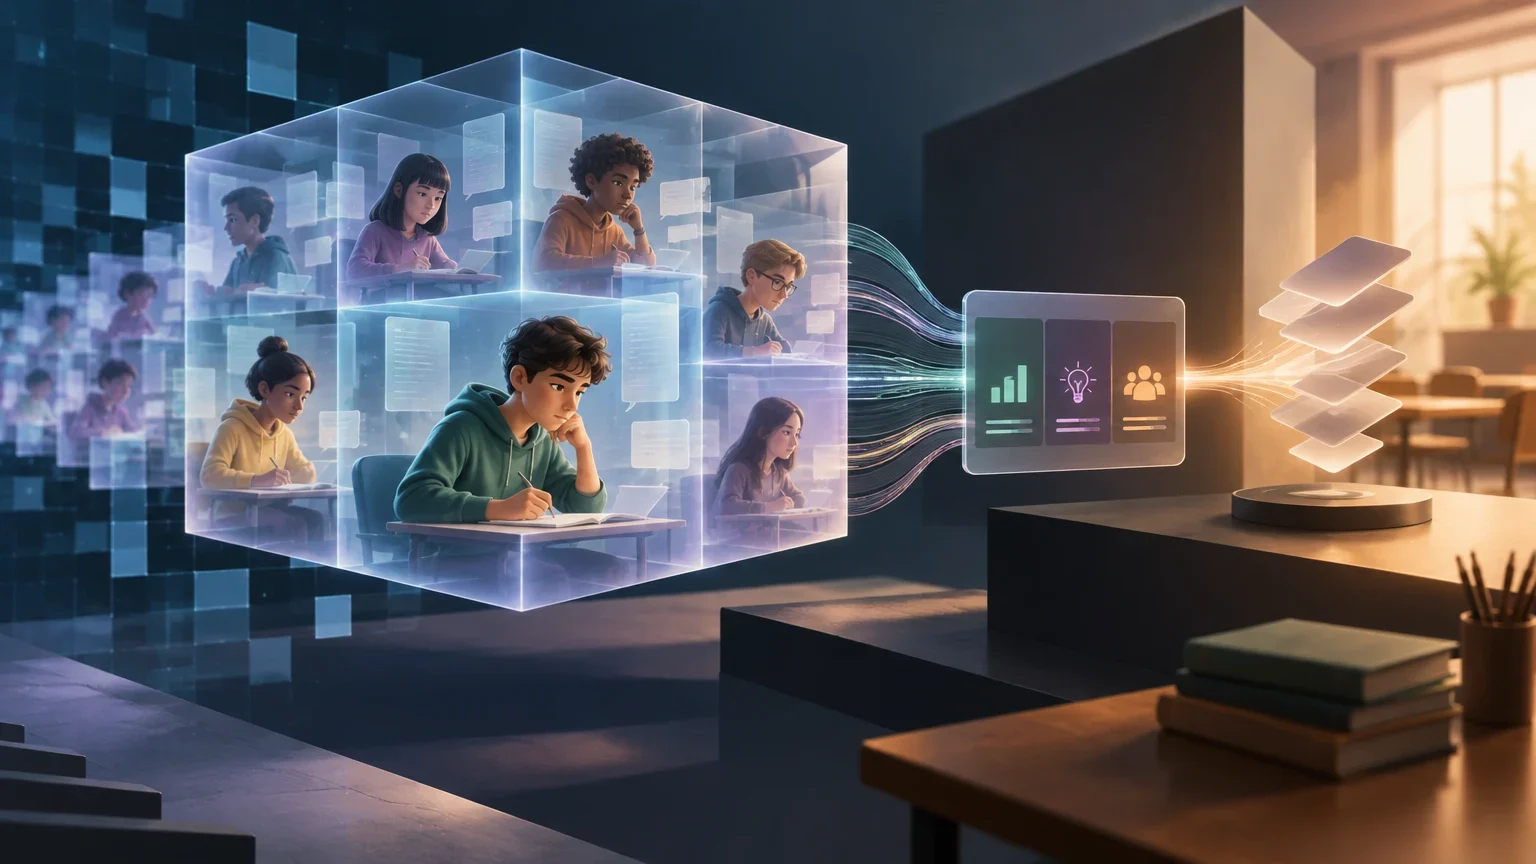
Microsoft Research presenta un sistema che modella come specifici studenti potrebbero rispondere a domande e indicazioni di un tutor. I risultati sono promettenti in tre ambiti, ma la simulazione non dimostra che un tutor migliori l'apprendimento reale né sostituisce i test con studenti.
OpenAI ha confermato di stare testando la pubblicità in ChatGPT. Le informazioni sugli annunci visivi durante la creazione di immagini non consentono ancora di verificare quando comparirebbero, come sarebbero presentati né quale sarebbe la loro portata.