Guida operativa per auditare i costi reali di AesCode 32B, distinguendo tra specifiche tecniche confermate da Microsoft e variabili economiche che richiedono stime interne, dato che non esistono tariffe pubbliche API per questo modello.
Una query può essere eseguita senza errori e calcolare comunque una metrica in modo errato. Questo protocollo spiega come controllare JOIN, filtri e aggregazioni, testare la query in un ambiente controllato e confrontare i risultati con riferimenti noti.
Q4_K_M, Q5_K_M e Q8_0 non indicano da soli quanta memoria serve. Scopri come stimare i pesi, calcolare la cache KV e verificare una configurazione con test di velocità e qualità specifici per il tuo compito.
Una guida pratica per registrare ogni richiesta e le sue fasi senza archiviare indiscriminatamente dati sensibili. Include uno schema di eventi, un esempio di strumentazione, criteri di privacy, dashboard diagnostiche e una procedura per analizzare gli errori e distinguere l’uso segnalato dall’API dagli addebiti finali.
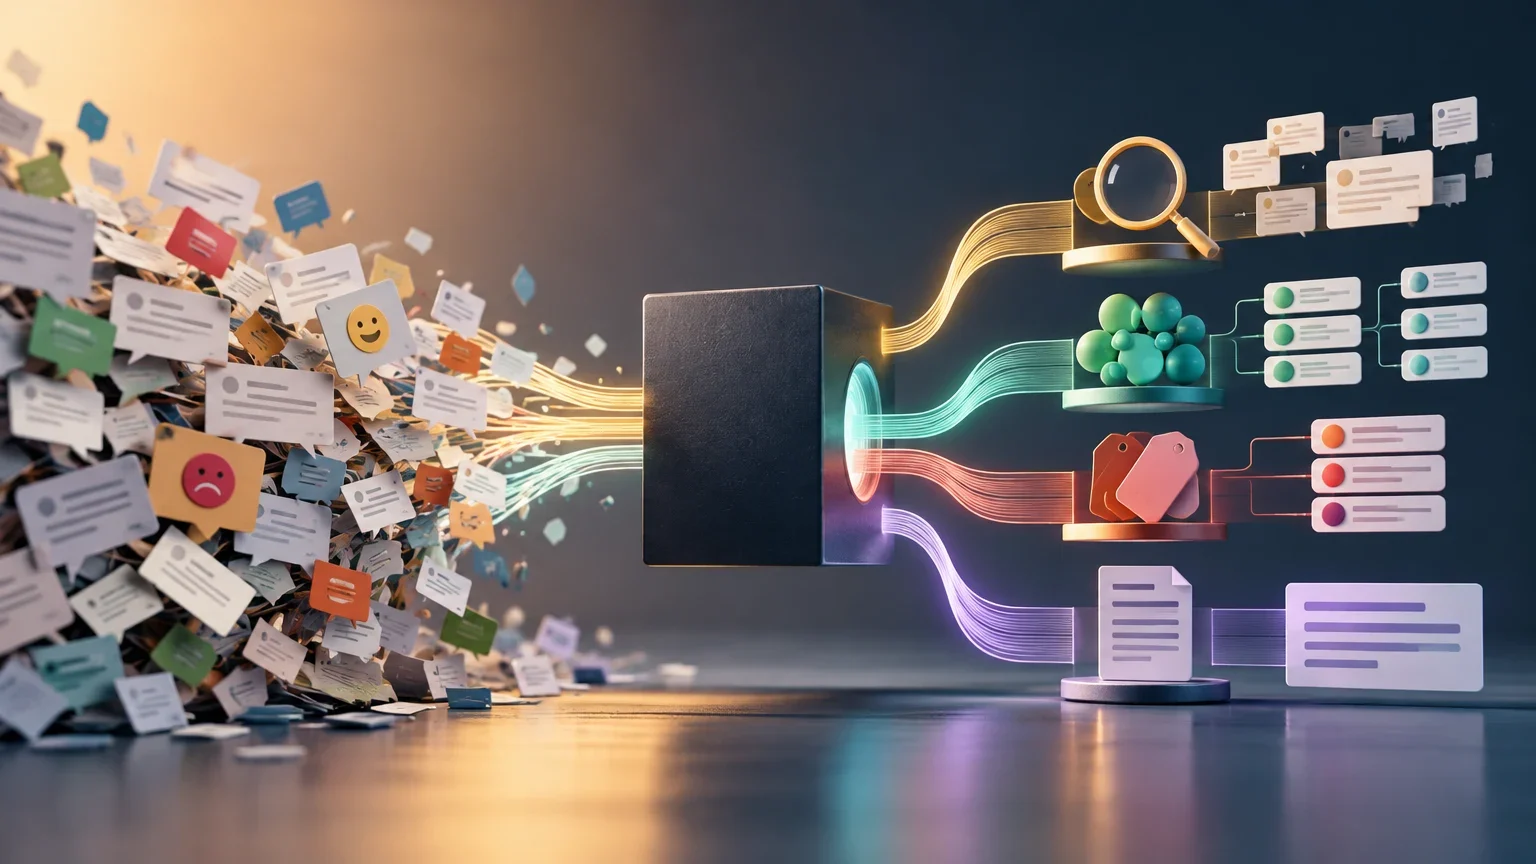
Come distinguere tra localizzare commenti, scoprire temi, applicare categorie note e redigere sintesi per selezionare l'approccio tecnico adeguato in base al volume, alla struttura e alla tolleranza all'errore.
Come definire gli stati di errore, le politiche di recupero e i test di accettazione per evitare effetti duplicati nei flussi automatizzati con intelligenza artificiale.
V4.1-Flash-1017 migliora i risultati dichiarati da DeepSeek nei task agentici e riduce il costo medio per task nella sua valutazione DeepSWE. L'azienda offre anche Search e Fetch tramite API; i benchmark del nuovo checkpoint sono, al momento, test interni.
L'azienda ha concesso a sei ricercatori dell'organizzazione no profit METR permessi equivalenti a quelli dei propri dipendenti, segnando un precedente nella verifica esterna dei rischi dell'IA.
Come distinguere tra esplorazione, reportistica ricorrente e decisioni operative per selezionare lo strumento adeguato, verificare i risultati e gestire i rischi di privacy e costi.
Questa guida propone un metodo strutturato per esaminare la catena delle prove nella ricerca sull’intelligenza artificiale. Aiuta a distinguere le osservazioni dirette, le ipotesi implicite e le conclusioni interpretative, così da capire quali affermazioni sono davvero sostenute dai dati e quali dipendono da premesse ancora da verificare.
La documentazione disponibile mostra i valori di 4 e 20 dollari per Claude Opus 5.5, ma non consente di confermarne l’unità di fatturazione. Ecco una formula, alcuni scenari condizionali e un metodo per misurare il tuo carico di lavoro senza dare per verificate le tariffe di caching o di elaborazione batch.
Una guida metodologica per distinguere la robustezza sperimentale dalla generalizzazione e dalla riproducibilità, ricostruire le condizioni messe alla prova e formulare conclusioni proporzionate alle evidenze osservate nella ricerca sull’intelligenza artificiale.