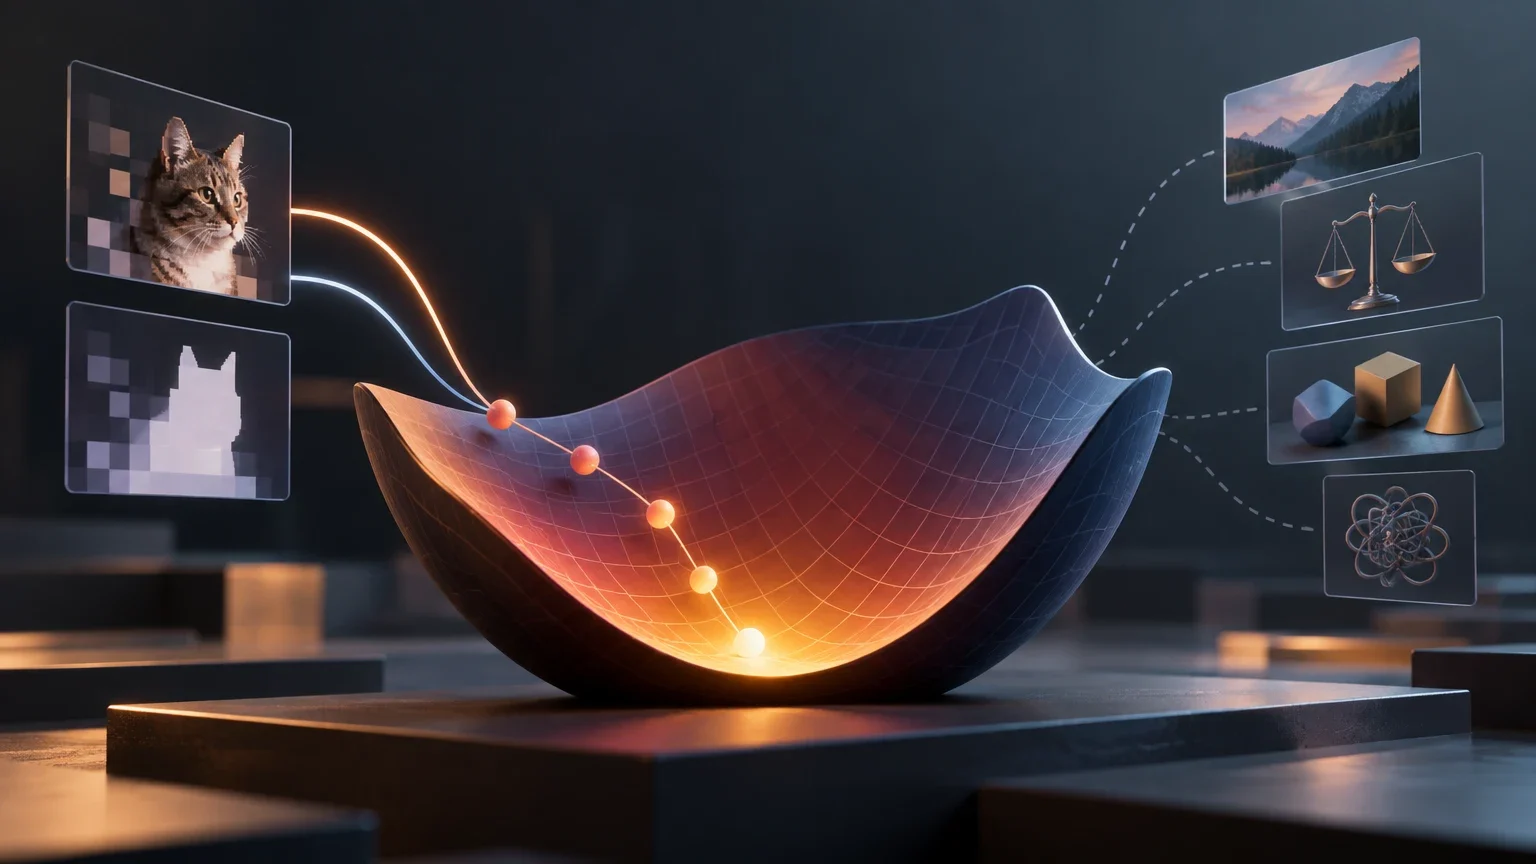
Definizione in una frase
Cálculo que cuantifica el error del modelo respecto al objetivo usado para actualizar sus parámetros durante el entrenamiento.
Definizione diretta: un criterio di discrepanza
Una funzione di perdita è una funzione matematica che assegna un valore a una previsione confrontandola con un obiettivo o un segnale di riferimento, secondo un criterio stabilito. Quel valore rappresenta la discrepanza che la funzione considera rilevante per il compito. Non è una misura universale del valore di un modello: dipende da che cosa viene previsto, dall’obiettivo usato e dagli errori che la funzione penalizza.
La parola «perdita» può far pensare che il numero misuri tutto ciò che è andato storto. Non è così. Descrive il risultato dell’applicazione di una regola precisa a dati specifici. Due funzioni possono ricevere la stessa previsione e lo stesso obiettivo e restituire valori diversi, perché attribuiscono pesi diversi ai tipi o alle dimensioni degli errori. Per interpretare il valore bisogna quindi conoscere il compito e la formulazione scelta, non limitarsi a osservare se il numero è alto o basso.
Nel linguaggio comune si dice talvolta che la perdita è l’«errore» del modello. È una semplificazione utile, purché si intenda l’errore definito dalla funzione, non necessariamente un tasso di insuccesso comprensibile direttamente. Una perdita può essere espressa su una scala che non si traduce subito in «percentuale di risposte sbagliate» o in una misura pratica della qualità.
Come interviene nell’addestramento
Il percorso concettuale parte da un input e dalla previsione prodotta dal modello. La funzione di perdita confronta quella previsione con l’obiettivo corrispondente e restituisce un valore. La procedura di addestramento usa questo segnale per modificare i parametri del modello, in modo che le perdite successive possano ridursi secondo il criterio scelto. La perdita definisce che cosa si misura; la procedura di ottimizzazione stabilisce come vengono regolati i parametri.
La funzione di perdita, quindi, non è di per sé l’algoritmo che aggiorna il modello. Dire che un addestramento «minimizza la perdita» significa che cerca di ridurre il valore associato a quel criterio. Non dimostra che il modello sia utile in un’applicazione, che le sue risposte siano corrette in ogni caso o che il criterio rappresenti tutte le esigenze dell’uso reale.
I dettagli dell’aggiornamento dipendono dal metodo di addestramento e dall’implementazione. È frequente che si usino gradienti nei metodi di ottimizzazione basati sui gradienti, ma non si può dedurre quale sia l’algoritmo specifico solo perché una descrizione menziona una funzione di perdita. Né bisogna confondere il calcolo della perdita con il passaggio di aggiornamento: sono parti collegate, ma concettualmente distinte.
Il percorso di base
- 01Il modello riceve un input e produce una previsione.
- 02La funzione di perdita confronta la previsione con l’obiettivo definito per quell’input.
- 03Il calcolo restituisce un valore di perdita secondo il criterio scelto.
- 04La procedura di ottimizzazione usa il segnale di addestramento per regolare i parametri: non è la funzione di perdita, da sola, ad aggiornarli.
- 05Il processo si ripete e si esaminano sia la perdita sia le altre misure pertinenti.
Perdita di un esempio e perdita aggregata
Una funzione può produrre un valore per un singolo esempio. Durante l’addestramento, però, si considerano di norma più esempi e serve quindi una regola per riunire i rispettivi valori in una quantità aggregata. Per esempio, si può calcolare una media oppure usare un’altra riduzione definita dall’implementazione. Non bisogna presumere che tutti i sistemi aggreghino nello stesso modo.
L’aggregazione è importante perché riassume un insieme, ma può nascondere differenze tra i casi. Una media più bassa non permette, da sola, di sapere se il miglioramento è stato uniforme o se alcuni esempi continuano ad avere perdite elevate. Per interpretare una curva conviene anche identificare i dati usati per calcolarla: addestramento, validazione o un altro insieme, e verificare se la loro composizione o il loro trattamento sono cambiati.
Perciò, quando si dice «la perdita è diminuita», restano aperte diverse domande: è diminuita la perdita per esempio o quella aggregata? Con quale riduzione? Su quale partizione dei dati? Tra quali momenti dell’addestramento? Senza queste informazioni, la tendenza può essere indicativa, ma non descrive completamente le prestazioni.
Che cosa controllare quando si legge un valore o una curva
| Domanda | Perché è importante |
|---|---|
| Quale funzione è stata calcolata? | Definisce quali discrepanze contano e come vengono valutate. |
| Quali esempi sono stati inclusi? | Il valore dipende dai dati su cui viene calcolato. |
| Come sono stati aggregati i valori? | La riduzione stabilisce come riassumere la perdita di più esempi. |
| Si tratta di addestramento o valutazione? | Una perdita calcolata sui dati di addestramento non descrive da sola il comportamento su altri dati. |
Esempio applicato: regressione numerica
Immagina un compito di regressione che prevede il tempo di consegna di un ordine. Per un ordine, il modello produce una durata stimata, che viene confrontata con la durata obiettivo registrata. Una funzione di perdita assegna un valore alla discrepanza tra le due. Se la previsione è lontana dall’obiettivo, il valore può rappresentare una discrepanza maggiore, secondo la regola scelta.
La scelta della regola cambia il peso attribuito ai diversi errori. A titolo illustrativo, una formulazione può fare in modo che gli errori grandi incidano in misura particolarmente marcata, mentre un’altra può ridurne l’influenza relativa. Non si può dedurre quale funzione venga usata dalla sola etichetta «regressione»: occorre consultare la definizione della funzione e la sua configurazione.
Questo esempio mostra anche perché «minimizzare l’errore» è un’espressione incompleta. L’addestramento cerca di ridurre la discrepanza formalizzata dalla funzione, ma non necessariamente il ritardo medio, il costo operativo o la quota di consegne effettuate entro una finestra accettabile. Per rispondere a queste domande possono servire metriche di valutazione aggiuntive.
Esempio applicato: classificazione del testo
In un compito di classificazione del testo, il modello riceve un testo e produce un’uscita relativa a diverse classi possibili, come «richiesta di informazioni», «reclamo» o «domanda». Per gli esempi usati nell’addestramento sono disponibili etichette obiettivo. Una funzione di perdita confronta l’uscita del modello con queste etichette secondo una regola di classificazione e restituisce un valore utilizzabile durante l’addestramento.
Quel valore non corrisponde automaticamente alla percentuale di testi classificati correttamente. La percentuale di correttezza risponde a una domanda diversa: quante previsioni finali hanno coinciso con le rispettive etichette, secondo una determinata regola decisionale? Una funzione di perdita può tenere conto di più informazioni sull’uscita rispetto al semplice esito corretto o errato della classe scelta. Perciò due modelli con la stessa percentuale di correttezza potrebbero avere perdite diverse, a seconda delle loro uscite e della funzione utilizzata.
Per interpretare il risultato bisogna verificare quali etichette sono state usate, quale funzione è stata applicata e su quali testi è stato calcolato il valore. È inoltre importante ricordare che una perdita di addestramento più bassa non garantisce che il classificatore si comporti altrettanto bene con testi nuovi, con una distribuzione diversa di argomenti o con categorie per le quali gli errori hanno costi differenti.
Esempio applicato: rilevamento di oggetti
In un compito di rilevamento di oggetti, il modello deve produrre informazioni sugli oggetti presenti in un’immagine. A livello concettuale, si possono distinguere domande sulla posizione di un oggetto e sulla classe a cui appartiene. Una funzione di perdita per questo compito potrebbe rappresentare discrepanze legate a più di un aspetto della previsione; il modo concreto di combinare le componenti dipende dal modello e dalla sua implementazione.
L’esempio aiuta a evitare una semplificazione: non sempre un unico errore elementare riassume un compito complesso. Tuttavia, non sarebbe rigoroso attribuire a tutti i rilevatori una formula, un elenco fisso di componenti o una ponderazione universale. Per descrivere una funzione di rilevamento specifica occorrerebbe consultare la documentazione tecnica di quell’implementazione, compresi i termini calcolati e il modo in cui vengono aggregati.
La perdita, inoltre, non sostituisce automaticamente le misure usate per valutare i rilevamenti. Se un rapporto presenta un valore di perdita, bisogna capire quale criterio rappresenta; se presenta una metrica di valutazione, la sua definizione va consultata separatamente. È utile confrontare le due categorie di informazioni, ma questo non autorizza a trattarne i valori come se fossero espressi sulla stessa scala.
Concetti vicini: perdita, metrica, costo e ottimizzatore
Una metrica di valutazione riassume un aspetto delle prestazioni mediante una regola di misurazione. Può aiutare a rispondere a domande come quante previsioni erano corrette o quale qualità abbia un risultato secondo una definizione specifica. Una perdita, invece, è il criterio che assegna un valore a previsioni e obiettivi per il compito definito. Alcune metriche e alcune perdite possono essere collegate, ma non sono sinonimi per impostazione predefinita e non hanno necessariamente la stessa interpretazione.
«Errore» è un termine generale e ambiguo: può riferirsi alla discrepanza calcolata da una funzione formale, a una previsione sbagliata o a una metrica espressa in unità comprensibili. È meglio indicare la quantità precisa. Anche «funzione di costo» può essere usato in modi diversi nei testi tecnici, per esempio per indicare un criterio aggregato. Non bisogna presumere che tutti gli autori distinguano perdita individuale e costo aggregato usando la stessa terminologia.
L’obiettivo di addestramento è il criterio più ampio che una configurazione cerca di ottimizzare. La funzione di perdita può far parte di questo obiettivo, ma la sua descrizione completa può includere altri elementi. L’ottimizzatore è la procedura che esegue gli aggiornamenti dei parametri. In breve: la perdita è una misura definita; l’obiettivo è ciò che si vuole ottimizzare; l’ottimizzatore è il metodo che organizza gli aggiornamenti; la metrica è un modo per valutare una proprietà.
Distinzioni utili
| Concetto | Domanda a cui aiuta a rispondere | Da non confondere con |
|---|---|---|
| Funzione di perdita | Quale valore assegna il criterio alla previsione rispetto all’obiettivo? | Una descrizione completa dell’utilità del modello. |
| Metrica di valutazione | Come si riassume un aspetto delle prestazioni? | La perdita di addestramento, salvo che sia definita esplicitamente in questi termini. |
| Ottimizzatore | Come vengono regolati i parametri durante l’addestramento? | La funzione che calcola la perdita. |
| Costo o obiettivo aggregato | Quale quantità globale si cerca di ottimizzare in una formulazione specifica? | Una terminologia universale con lo stesso significato in tutte le fonti. |
Che cosa non dimostra una perdita bassa
Una perdita bassa mostra che, sui dati considerati e secondo la funzione definita, il valore di quel criterio è basso. Da sola non dimostra che il modello generalizzi bene a esempi mai visti, che sia calibrato, che sia utile alle persone che lo usano o che tratti in modo equo gruppi diversi. Queste proprietà richiedono definizioni, dati e valutazioni pertinenti.
Può inoltre esserci una differenza tra i dati di addestramento e quelli incontrati nell’uso. Se il modello si adatta molto bene al criterio sugli esempi di addestramento, ma si comporta peggio su altri dati, la perdita di addestramento non basta a individuare o spiegare il problema. Il confronto dei risultati su insiemi adeguati può offrire elementi utili, anche se contano la selezione e la rappresentatività di quegli insiemi.
Una curva non si interpreta senza contesto. La sua lettura dipende dalla funzione, dall’aggregazione, dai dati e dal momento in cui viene calcolata. Una tendenza in discesa può indicare che la procedura sta riducendo il criterio ottimizzato, ma non consente di concludere automaticamente che tutte le capacità del modello stiano migliorando. Questa distinzione è fondamentale quando si parla di generalizzazione e sovradattamento.
Criteri pratici per interpretare una perdita
- 01Identifica il compito, la funzione specifica e l’obiettivo con cui viene confrontata la previsione.
- 02Scopri se il valore riguarda un singolo esempio o un’aggregazione, e qual è la regola di aggregazione.
- 03Verifica quale partizione dei dati ha prodotto il valore e se è confrontabile con quello usato nel confronto.
- 04Consulta le metriche adatte a valutare le conseguenze pratiche degli errori in quel compito.
- 05Non dedurre generalizzazione, calibrazione, utilità o assenza di distorsioni da una perdita isolata.
Errori frequenti e concetti correlati
Un errore frequente è dire che il modello «ha imparato perché la perdita è arrivata a zero». Il valore zero avrebbe un significato preciso solo rispetto a una funzione e a determinati dati; non dimostra che il sistema risolva correttamente tutti i casi rilevanti. Un altro errore consiste nel confrontare direttamente perdite di compiti, funzioni o configurazioni diverse. In assenza di formulazioni compatibili, i valori potrebbero non essere confrontabili.
Si confonde anche la funzione di perdita con l’algoritmo di ottimizzazione, oppure si presenta una perdita come se fosse una metrica di prodotto. Per evitarlo, è più chiaro specificare la funzione utilizzata, l’insieme di dati su cui è stata calcolata e la metrica con cui si valuta il risultato operativo. Quando si parla di addestramento, la perdita descrive il criterio; quando si parla di risultati, vanno indicate esplicitamente le misure di valutazione.
Per approfondire, questa scheda è collegata alla valutazione, alla generalizzazione e al sovradattamento: la perdita è una parte dell’interpretazione dell’addestramento, mentre quei concetti aiutano a esaminare il comportamento oltre il valore ottimizzato. Sono pertinenti anche il fine-tuning e l’apprendimento autosupervisionato, nei quali la formulazione dell’obiettivo determina quale segnale viene usato. Le altre voci del glossario e la pagina di confronto tra concetti correlati possono offrire ulteriori percorsi di consultazione, ma ogni termine va definito nel proprio contesto.