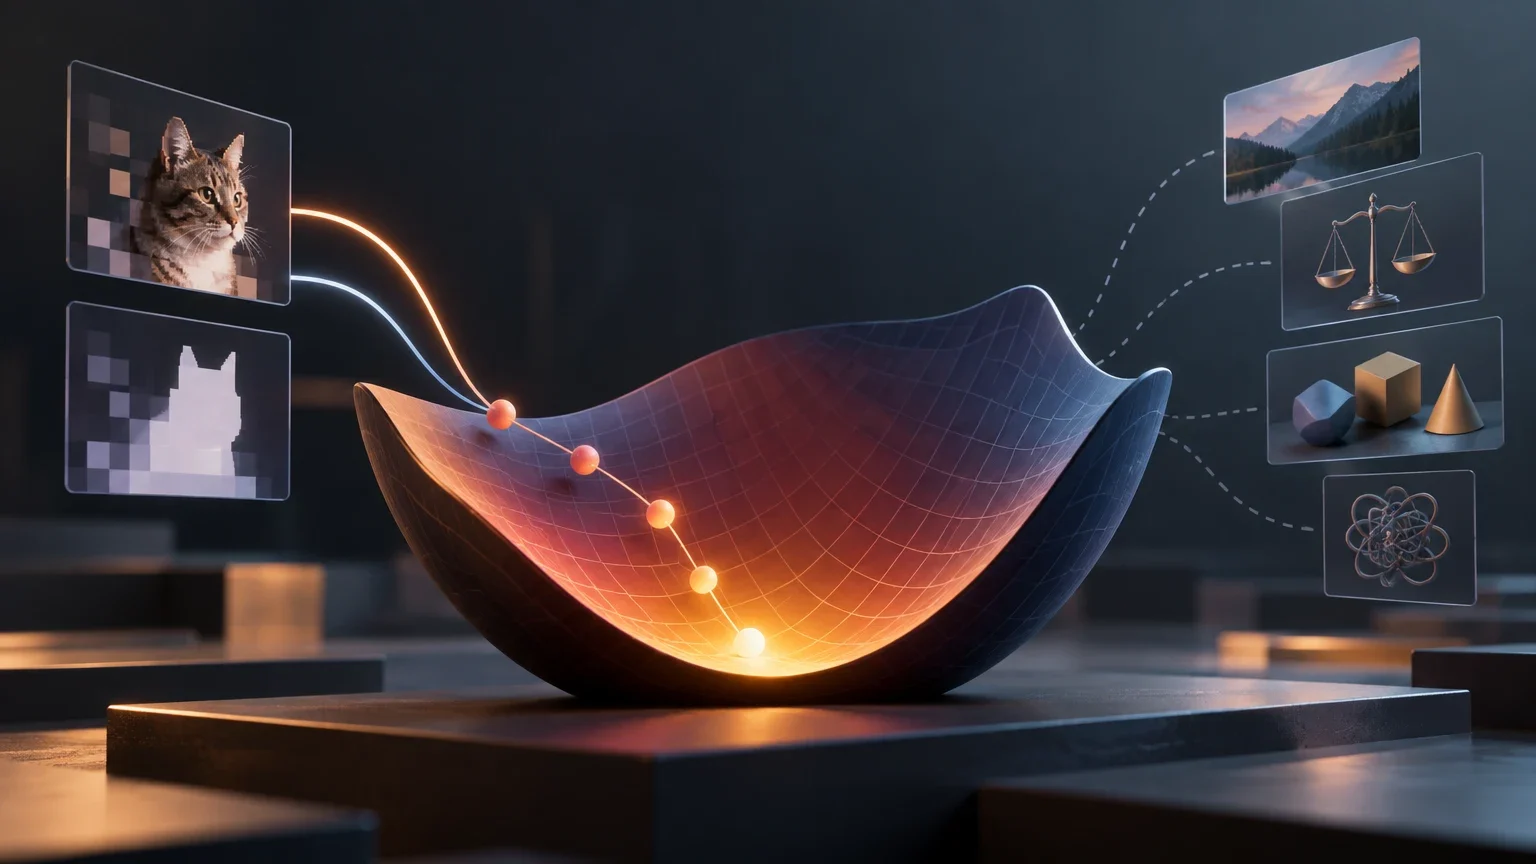
Definición en una frase
Cálculo que cuantifica el error del modelo respecto al objetivo usado para actualizar sus parámetros durante el entrenamiento.
Definición directa: un criterio de discrepancia
Una función de pérdida es una función matemática que asigna un valor a una predicción al compararla con un objetivo o una señal de referencia, de acuerdo con un criterio establecido. Ese valor representa la discrepancia que la función considera relevante para la tarea. No es una medida universal del valor de un modelo: depende de qué predice, qué objetivo utiliza y qué errores penaliza.
La palabra «pérdida» puede sugerir que el número mide todo lo que salió mal. No es así. Describe el resultado de aplicar una regla concreta a unos datos concretos. Dos funciones pueden recibir la misma predicción y el mismo objetivo y producir valores distintos porque ponderan de forma diferente los tipos o tamaños de error. Por eso, para interpretar el valor hay que conocer la tarea y la formulación elegida, no solo observar si el número es grande o pequeño.
En lenguaje cotidiano, a veces se dice que la pérdida es el «error» del modelo. Es una simplificación útil si se entiende que se refiere al error definido por la función, no necesariamente a una tasa de fallos comprensible directamente para una persona. Una pérdida puede estar en una escala que no se traduce de manera inmediata a «porcentaje de respuestas incorrectas» o a una medida práctica de calidad.
Cómo interviene en el entrenamiento
El recorrido conceptual empieza con una entrada y una predicción del modelo. La función de pérdida compara esa predicción con el objetivo correspondiente y produce un valor. El procedimiento de entrenamiento utiliza esa señal para modificar los parámetros del modelo de modo que, según el criterio elegido, las pérdidas posteriores puedan reducirse. La pérdida define qué se mide; el procedimiento de optimización determina cómo se ajustan los parámetros.
Por tanto, la función de pérdida no es por sí sola el algoritmo que actualiza el modelo. Decir que un entrenamiento «minimiza la pérdida» significa que busca reducir el valor asociado a ese criterio. No demuestra que el modelo sea útil en una aplicación, que sus respuestas sean correctas en todos los casos ni que el criterio represente todas las necesidades del uso real.
El detalle de la actualización depende del método de entrenamiento y de la implementación. Es frecuente que se empleen gradientes en métodos de optimización basados en ellos, pero no debe deducirse el algoritmo concreto solo porque una descripción mencione una función de pérdida. Tampoco debe confundirse el cálculo de la pérdida con el paso de actualización: son partes relacionadas, pero conceptualmente distintas.
Recorrido básico
- 01El modelo recibe una entrada y produce una predicción.
- 02La función de pérdida compara la predicción con el objetivo definido para esa entrada.
- 03El cálculo genera un valor de pérdida según el criterio escogido.
- 04El procedimiento de optimización utiliza la señal de entrenamiento para ajustar parámetros; no es la función de pérdida la que, por sí sola, los actualiza.
- 05Se repite el proceso y se examinan tanto la pérdida como otras medidas pertinentes.
Pérdida de un ejemplo y pérdida agregada
Una función puede producir un valor para un ejemplo individual. En un entrenamiento suelen considerarse varios ejemplos, así que hace falta una regla para reunir sus valores en una cantidad agregada. Por ejemplo, se puede calcular un promedio o utilizar otra reducción definida por la implementación. No hay que suponer que todos los sistemas agregan de la misma manera.
La agregación importa porque resume un conjunto, pero puede ocultar diferencias entre casos. Un promedio menor no permite saber, por sí solo, si la mejora fue homogénea o si algunos ejemplos siguen teniendo pérdidas altas. Para interpretar una curva también conviene identificar qué datos se usaron para calcularla: entrenamiento, validación u otro conjunto, y si la composición o el procesamiento de esos datos cambió.
Así, cuando se informa «la pérdida bajó», la afirmación todavía deja preguntas abiertas: ¿bajó la pérdida por ejemplo o la agregada?, ¿con qué reducción?, ¿en qué partición de datos?, ¿entre qué momentos del entrenamiento? Si no se especifica, la tendencia puede ser informativa, pero no ofrece una descripción completa del desempeño.
Qué comprobar al leer un valor o una curva
| Pregunta | Por qué importa |
|---|---|
| ¿Qué función se calculó? | Define qué discrepancias cuentan y cómo se valoran. |
| ¿Qué ejemplos se incluyeron? | La cifra depende de los datos sobre los que se calcula. |
| ¿Cómo se agregaron los valores? | La reducción determina cómo se resume la pérdida de varios ejemplos. |
| ¿Se trata de entrenamiento o evaluación? | Una pérdida sobre datos de entrenamiento no describe por sí sola el comportamiento en otros datos. |
Ejemplo aplicado: regresión numérica
Imagina una tarea de regresión que predice el tiempo de entrega de un pedido. Para un pedido, el modelo produce una duración estimada y se compara con la duración objetivo registrada. Una función de pérdida asigna un valor a la discrepancia entre ambas. Si la predicción queda lejos del objetivo, el valor puede reflejar una discrepancia mayor, conforme a la regla elegida.
La elección de la regla cambia qué errores reciben más peso. A modo de ilustración, una formulación puede hacer que errores grandes influyan de manera especialmente marcada, mientras que otra puede reducir esa influencia relativa. No se debe inferir cuál se está usando solo por la etiqueta «regresión»; hay que consultar la definición de la función y su configuración.
Esto también muestra por qué «minimizar el error» es una frase incompleta. El entrenamiento intenta reducir la discrepancia formalizada por la función, no necesariamente el tiempo medio de retraso, el coste operativo o la proporción de entregas dentro de una ventana aceptable. Esas preguntas pueden requerir métricas de evaluación adicionales.
Ejemplo aplicado: clasificación de texto
En una clasificación de texto, el modelo recibe un texto y produce una salida relacionada con varias clases posibles, como «consulta», «queja» o «solicitud». El entrenamiento dispone de etiquetas objetivo para los ejemplos. Una función de pérdida compara la salida del modelo con esas etiquetas según una regla de clasificación y devuelve un valor que puede utilizarse durante el entrenamiento.
Ese valor no es automáticamente el porcentaje de textos clasificados correctamente. El porcentaje de aciertos responde a una pregunta distinta: cuántas predicciones finales coincidieron con sus etiquetas según una regla de decisión. Una función de pérdida puede tener en cuenta más información de la salida que el simple acierto o fallo de una clase elegida. Por eso, dos modelos con porcentajes de acierto iguales podrían no tener la misma pérdida, dependiendo de sus salidas y de la función.
Para interpretar el resultado hay que comprobar qué etiquetas se usaron, cuál fue la función y sobre qué textos se calculó. También es importante que una pérdida de entrenamiento menor no garantice que el clasificador funcione igual de bien con textos nuevos, con otra distribución de temas o con categorías cuyo coste de error sea diferente.
Ejemplo aplicado: detección de objetos
En una tarea de detección de objetos, el modelo debe producir información sobre los objetos presentes en una imagen. Como esquema conceptual, pueden distinguirse preguntas sobre dónde se encuentra un objeto y a qué clase pertenece. Una pérdida para esa tarea podría reflejar discrepancias relacionadas con más de un aspecto de la predicción; el modo concreto de combinar componentes depende del modelo y de su implementación.
Este ejemplo sirve para evitar una simplificación: no siempre existe un único error elemental que resuma una tarea compleja. Sin embargo, no es riguroso atribuir una fórmula, una lista fija de componentes o una ponderación universal a todos los detectores. Para describir una función de detección concreta habría que consultar documentación técnica de esa implementación, incluyendo qué términos calcula y cómo los agrega.
La pérdida tampoco sustituye automáticamente a las medidas que se utilicen para evaluar detecciones. Si un informe presenta un valor de pérdida, hay que averiguar qué criterio representa; si presenta una métrica de evaluación, hay que consultar su definición por separado. La propuesta de comparar ambos tipos de información es útil, pero no autoriza a tratar sus valores como si estuvieran en la misma escala.
Conceptos próximos: pérdida, métrica, coste y optimizador
Una métrica de evaluación resume un aspecto del desempeño mediante una regla de medición. Puede ayudar a responder preguntas como cuántas predicciones fueron correctas o qué calidad tiene un resultado según una definición concreta. Una pérdida, en cambio, es el criterio que asigna un valor a predicciones y objetivos para la tarea especificada. Algunas métricas y pérdidas pueden estar relacionadas, pero no son sinónimos por defecto ni necesariamente se interpretan igual.
«Error» es un término general y ambiguo: puede referirse a la discrepancia de una función formal, a una predicción equivocada o a una métrica expresada en unidades comprensibles. Conviene nombrar la cantidad exacta. «Función de coste» también puede usarse de distintas maneras en textos técnicos, por ejemplo para referirse a un criterio agregado. No se debe asumir que todos los autores distinguen pérdida individual y coste agregado con idéntica terminología.
El objetivo de entrenamiento es el criterio más amplio que se busca optimizar en una configuración. La función de pérdida puede formar parte de ese objetivo, pero la descripción completa puede incluir otros elementos. El optimizador es el procedimiento que lleva a cabo las actualizaciones de parámetros. En suma: pérdida es una medida definida; objetivo, aquello que se busca optimizar; optimizador, el método que organiza las actualizaciones; métrica, una forma de evaluar una propiedad.
Distinciones útiles
| Concepto | Pregunta que ayuda a responder | No debe confundirse con |
|---|---|---|
| Función de pérdida | ¿Qué valor asigna el criterio a la predicción respecto del objetivo? | Una descripción total de la utilidad del modelo. |
| Métrica de evaluación | ¿Cómo se resume un aspecto del desempeño? | La pérdida de entrenamiento, salvo que se defina expresamente así. |
| Optimizador | ¿Cómo se ajustan los parámetros durante el entrenamiento? | La función que calcula la pérdida. |
| Coste u objetivo agregado | ¿Qué cantidad global se busca optimizar en una formulación concreta? | Una terminología universal con el mismo significado en todas las fuentes. |
Qué no demuestra una pérdida baja
Una pérdida baja muestra que, sobre los datos considerados y según la función definida, el valor de ese criterio es bajo. No prueba por sí sola que el modelo generalice bien a ejemplos no vistos, que esté calibrado, que sea útil para las personas usuarias ni que trate de manera equitativa a distintos grupos. Esas propiedades requieren definiciones, datos y evaluaciones pertinentes.
También puede haber una diferencia entre los datos de entrenamiento y los de uso. Si el modelo ajusta muy bien el criterio en los ejemplos de entrenamiento, pero su comportamiento empeora en otros datos, la pérdida de entrenamiento no basta para detectar o explicar ese problema. Comparar resultados en conjuntos adecuados puede aportar evidencia, aunque la selección y representatividad de esos conjuntos también importan.
La curva no habla sin contexto. Su lectura depende de la función, la agregación, los datos y el momento en que se calcula. Una tendencia descendente puede indicar que el procedimiento está reduciendo el criterio optimizado, pero no permite concluir sin más que todas las capacidades del modelo mejoren. Esa diferencia es central al explicar generalización y sobreajuste.
Criterios prácticos para interpretar una pérdida
- 01Identifica la tarea, la función concreta y el objetivo con el que se compara la predicción.
- 02Averigua si el valor corresponde a un ejemplo o a una agregación, y cuál es la regla de agregación.
- 03Comprueba qué partición de datos produjo el valor y si es comparable con el valor que estás contrastando.
- 04Consulta las métricas adecuadas para las consecuencias prácticas de los errores de esa tarea.
- 05No infieras generalización, calibración, utilidad o ausencia de sesgo a partir de una pérdida aislada.
Errores frecuentes y conceptos relacionados
Un error frecuente es decir que el modelo «aprendió porque la pérdida llegó a cero». El valor cero solo tendría una interpretación concreta respecto de una función y unos datos determinados; no demuestra que el sistema resuelva correctamente todos los casos relevantes. Otro error es comparar directamente pérdidas de tareas, funciones o configuraciones distintas. Sin una formulación compatible, las cifras pueden no ser comparables.
También se confunde la función de pérdida con el algoritmo de optimización, o se comunica una pérdida como si fuera una métrica de producto. La forma más clara de evitarlo es indicar la función usada, el conjunto sobre el que se calculó y la métrica que evalúa el resultado operativo. Al hablar de entrenamiento, la pérdida explica el criterio; al hablar de resultados, deben explicitarse las medidas de evaluación.
Para profundizar, esta ficha se relaciona con la evaluación, la generalización y el sobreajuste: la pérdida es una parte de la lectura del entrenamiento, mientras que esos conceptos ayudan a examinar el comportamiento más allá de la cifra optimizada. También es relevante para el ajuste fino y el aprendizaje autosupervisado, donde la formulación del objetivo determina qué señal se utiliza. La página de glosario y la comparación entre conceptos relacionados pueden servir como rutas de consulta, pero cada término debe definirse en su propio contexto.